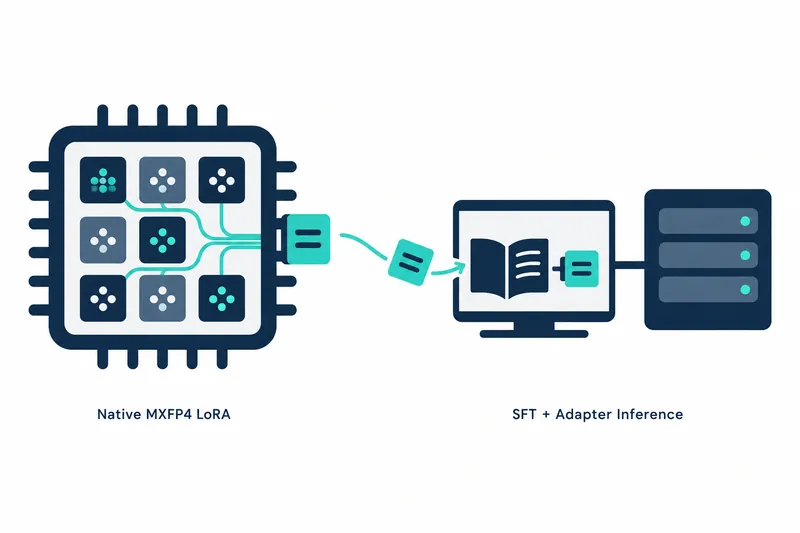
对于希望在自有环境中微调大语言模型的开发者,现在有了一条可将部分模型以压缩状态保留在 CPU 上进行训练的路径。新版本仅训练小规模附加权重,并支持将保存的结果接入推理服务器。
1. 保持权重压缩状态的训练
KTransformers v0.7.2 于 2026年10月15日发布。
支持的对象是 4月版 DeepSeek-V4-Flash。每次输入所选择的计算模块,即“路由专家”,在 CPU 上处理,注意力等其余模块则在 GPU 上处理。
LoRA 是固定原有权重、添加小规模修正权重进行训练的方法。此次路径保留专家原有的 4位压缩格式 MXFP4,执行预测和训练梯度计算。关键在于不将固定的专家权重展开为更宽数值格式的常驻副本。
2. 训练工具衔接与成本
可接入 LLaMA-Factory 的监督微调,但必须使用匹配的、经过验证的集成软件包与依赖锁定文件。仅靠基础安装的额外依赖包组,无法获得所需的开发分支。
经过验证的训练方式是不使用推理过程生成模式的普通对话,也包括多轮对话。训练长度为 1024 个 token。
自动转换为 16位数值格式 BF16,多 GPU 时使用 FSDP2 分散训练状态。
收益在于保持专家权重的压缩存储。代价是 GPU 中间结果需要重计算,CPU 专家的中间结果需要保留,而专家附加权重与优化器状态由第一个分布式进程负责。非专家权重会为训练而展开并存入独立缓存,因此以 4月版为准,还需要约 13.7 GiB 的磁盘空间。
缓存应放在与原始文件分离的专用目录中,同时原始文件也必须可访问。首次运行时创建缓存,此后验证并复用。
3. 从检查点到推理适配器
如果只保留一个普通适配器,即修正权重文件,就会遗漏 CPU 专家的附加权重。必须保持 save_only_model: false,并保留作为训练状态集合的整个检查点目录。恢复训练需要相同的模型、缓存、分布式进程数、训练对象及学习率调度的总周期。
下面的导出工具会检查原始文件的一致性、哈希及附加权重的形状等,不会修改原始文件。
python -m kt_kernel.sft.export_dsv4_sglang_adapter \
  --source /models/DeepSeek-V4-Flash \
  --cache /cache/v4-non-experts \
  --adapter /runs/v4/checkpoint-20 \
  --output /deploy/v4-adapter
产物分为合并了普通附加权重的模型,以及 CPU 专家用的附加权重,两者缺一不可。
SGLang 推理需使用匹配的依赖锁定文件,并将专家放在 CPU 上。经过验证的请求长度为输入与输出合计 2048 个 token。
4. 数值验证的范围
训练集成之前的独立内核验证以 DeepSeek-V4-Flash-0731 的单个专家层为对象。服务器配备 2 颗 AMD EPYC 9355,共有 64 个物理核心、128 个硬件线程。
使用 AVX512-BF16,未使用 AMX。在实际检查点的第 3 层测试,条件为 256 个专家、隐藏维度 4096、中间维度 2048、每个 token 选择 6 个专家、附加权重维度 8、token 长度 2。
此时压缩层的存储量为 3,623,878,656 字节。分片数为 1 的 TP1 和为 2 的 TP2,其最大驻留内存分别为 11.699 GiB 和 11.623 GiB,包含原始张量、临时分片准备空间及内核压缩副本。
对照基准是首个 token 所选择的 6 个专家的展开权重。表示数值差异的相对 L2 误差最大为 0.007374,表示方向一致性的余弦相似度最低为 0.999973。
同一设备上的合成测试条件为 4 个专家、隐藏与中间维度各 256、每个 token 选择 2 个专家、附加权重维度 8、分片数 1·2、训练梯度累积 1·2·8 次。相对于 32位数值格式 FP32 基准值,相对 L2 误差最大为 0.008501,余弦相似度最低为 0.999965。
5. 采用决策仍需注意的边界
在实际层测试中,即使更新了附加权重,用于判定原始文件是否一致的哈希也没有变化。
token 长度为 2 的运行观测用于确认正确性,不能作为吞吐量或延迟的依据。未提供完整模型的损失、质量、恢复训练及吞吐量测量结果。
集成文档的支持范围也不包括将多个对话打包为一个训练序列、一次性指定全部模块、动态切换适配器及其他模型变体。
本版本的价值在于将压缩专家训练与保存、推理衔接起来,采用时还需一并规划软件包组合和资源配置。