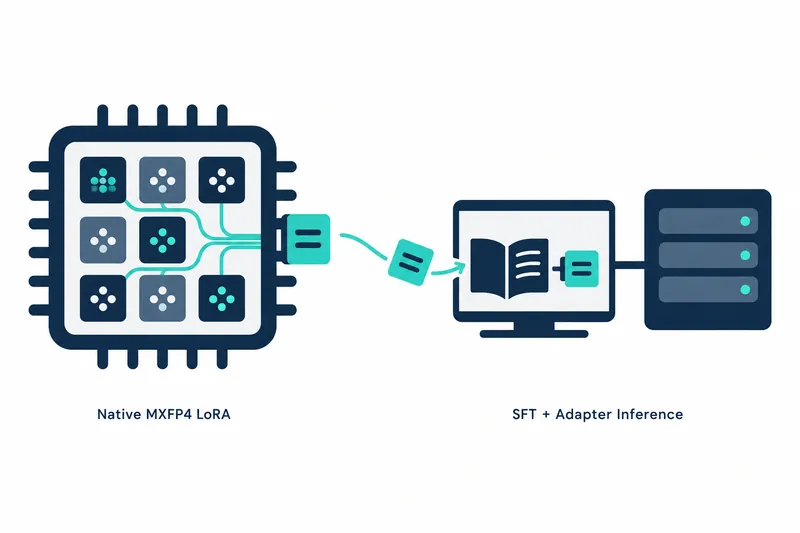
대형 언어 모델을 자체 환경에서 미세 조정하려는 개발자에게, 모델의 일부를 CPU에 압축 상태로 둔 채 학습하는 경로가 생겼다. 새 버전은 작은 추가 가중치만 학습하고, 저장한 결과를 추론 서버에 연결하도록 지원한다.
1. 압축 가중치를 유지하는 학습
KTransformers v0.7.2는 2026년 10월 15일 공개됐다.
지원 대상은 4월판 DeepSeek-V4-Flash다. 입력마다 선택되는 계산 모듈인 ‘라우팅 전문가’는 CPU에서, 주의 집중 등 나머지 모듈은 GPU에서 처리한다.
LoRA는 기존 가중치를 고정하고 작은 보정 가중치를 덧붙여 학습하는 방식이다. 이번 경로는 전문가의 원래 4비트 압축 형식인 MXFP4를 유지하며 예측과 학습용 기울기 계산을 수행한다. 고정된 전문가 가중치를 더 넓은 수치 형식의 상시 사본으로 펼쳐 두지 않는 것이 핵심이다.
2. 학습 도구 연결과 비용
LLaMA-Factory의 지도 미세 조정에 연결하되, 검증된 연동 패키지와 의존성 잠금 파일을 맞춰야 한다. 기본 설치의 추가 의존성 묶음만으로는 필요한 개발 브랜치가 제공되지 않는다.
검증된 학습법은 추론 과정 생성 모드를 쓰지 않는 일반 대화이며 여러 턴도 포함한다. 학습 길이는 1024토큰이다.
16비트 수치 형식인 BF16으로 자동 변환하며, 여러 GPU에서는 학습 상태를 분산하는 FSDP2를 사용한다.
이익은 전문가 가중치의 압축 저장 유지다. 대신 GPU 중간 결과는 재계산하고 CPU 전문가의 중간 결과는 보관하며, 전문가 추가 가중치와 최적화 상태는 첫 번째 분산 프로세스가 맡는다. 비전문가 가중치는 학습용으로 풀어 별도 캐시에 저장하므로 4월판 기준 약 13.7 GiB의 디스크도 필요하다.
캐시는 원본과 분리된 전용 디렉터리에 두되 원본도 접근 가능해야 한다. 첫 실행에서 만들고 이후에는 검증해 재사용한다.
3. 체크포인트에서 추론 어댑터로
일반 어댑터, 즉 보정 가중치 파일 하나만 남기면 CPU 전문가의 추가 가중치가 빠진다. save_only_model: false를 유지하고 학습 상태 묶음인 체크포인트 디렉터리 전체를 보존해야 한다. 재개에는 같은 모델·캐시·분산 프로세스 수·학습 대상·학습률 일정의 전체 기간이 필요하다.
아래 내보내기 도구는 원본 동일성, 해시와 추가 가중치의 모양 등을 검사하며 원본을 바꾸지 않는다.
python -m kt_kernel.sft.export_dsv4_sglang_adapter \
  --source /models/DeepSeek-V4-Flash \
  --cache /cache/v4-non-experts \
  --adapter /runs/v4/checkpoint-20 \
  --output /deploy/v4-adapter
산출물은 일반 추가 가중치를 합친 모델과 CPU 전문가용 추가 가중치로 나뉘며 둘 다 필요하다.
SGLang 추론에는 일치하는 의존성 잠금 파일을 사용하고 전문가를 CPU에 둔다. 검증된 요청 길이는 입력과 출력 합계 2048토큰이다.
4. 수치가 확인한 범위
학습 통합에 앞선 독립 커널 검증은 DeepSeek-V4-Flash-0731의 단일 전문가 층을 대상으로 했다. 서버는 AMD EPYC 9355 두 개, 물리 코어 64개·하드웨어 스레드 128개 구성이다.
AVX512-BF16을 사용하고 AMX는 쓰지 않았다. 실제 체크포인트의 3번 층에서 전문가 256개, 은닉 차원 4096, 중간 차원 2048, 토큰당 선택 6개, 추가 가중치 차원 8, 토큰 길이 2로 시험했다.
이때 압축 층 저장량은 3,623,878,656바이트였다. 분할 수가 1인 TP1과 2인 TP2의 최대 상주 메모리는 각각 11.699 GiB와 11.623 GiB로, 원본 텐서·임시 분할 준비 공간·커널 압축 사본을 포함한다.
첫 토큰이 선택한 전문가 6개의 펼친 가중치 기준값과 비교했다. 값의 차이를 나타내는 상대 L2 오차는 최대 0.007374, 방향 일치를 나타내는 코사인 유사도는 최소 0.999973이었다.
같은 장비의 합성 시험은 전문가 4개, 은닉·중간 차원 각 256, 토큰당 선택 2개, 추가 가중치 차원 8, 분할 수 1·2, 학습용 기울기 누적 1·2·8회 조건이었다. 32비트 수치 형식인 FP32 기준값 대비 상대 L2 오차는 최대 0.008501, 코사인 유사도는 최소 0.999965였다.
5. 도입 판단에 남는 경계
실제 층 시험에서는 추가 가중치를 갱신한 뒤에도 원본이 같은지 판별하는 해시가 변하지 않았다.
토큰 길이 2의 실행 관측은 정확성 확인용이지 처리량이나 지연 시간의 근거가 아니다. 전체 모델의 손실·품질·재개·처리량 측정 결과는 제시되지 않았다.
통합 문서의 지원 범위에서도 여러 대화를 한 학습 시퀀스로 묶기, 전체 모듈 일괄 지정, 동적 어댑터 교체와 다른 모델 변형은 제외된다.
이번 버전의 가치는 압축 전문가 학습을 저장·추론까지 잇는 데 있으며, 도입 시에는 패키지 조합과 자원 배치까지 함께 계획해야 한다.