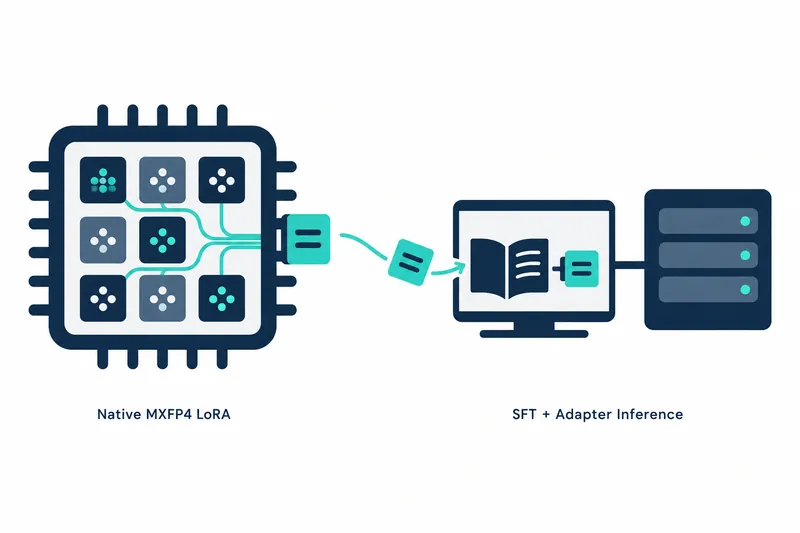
大規模言語モデルを自前の環境で微調整したい開発者向けに、モデルの一部をCPU上で圧縮状態に保ったまま学習する経路が登場した。新バージョンは小さな追加重みだけを学習し、保存した結果を推論サーバーに接続できるようにする。
1. 圧縮重みを維持する学習
KTransformers v0.7.2は2026年10月15日に公開された。
対象は4月版のDeepSeek-V4-Flashである。入力ごとに選ばれる計算モジュールである「ルーティングエキスパート」はCPUで、アテンションなどの残りのモジュールはGPUで処理する。
LoRAは既存の重みを固定し、小さな補正重みを追加して学習する方式である。今回の経路は、エキスパート本来の4ビット圧縮形式であるMXFP4を維持して予測と学習用の勾配計算を行う。固定されたエキスパート重みを、より広い数値形式の常駐コピーとして展開しておかない点が要となる。
2. 学習ツールとの連携とコスト
LLaMA-Factoryの教師あり微調整に接続するが、検証済みの連携パッケージと依存関係のロックファイルをそろえる必要がある。標準インストールの追加依存パッケージ群だけでは、必要な開発ブランチは提供されない。
検証済みの学習方式は、推論過程の生成モードを使わない通常の会話であり、複数ターンも含む。学習長は1024トークンである。
16ビット数値形式のBF16へ自動変換し、複数GPUでは学習状態を分散するFSDP2を使用する。
利点はエキスパート重みの圧縮保存を維持できることにある。一方、GPUの中間結果は再計算し、CPUエキスパートの中間結果は保持するほか、エキスパートの追加重みと最適化状態は最初の分散プロセスが担当する。非エキスパート重みは学習用に展開して別のキャッシュに保存するため、4月版では約13.7 GiBのディスク容量も必要となる。
キャッシュは元データと分離した専用ディレクトリに置き、元データにもアクセスできる必要がある。初回実行時に作成し、以降は検証して再利用する。
3. チェックポイントから推論アダプターへ
通常のアダプター、つまり補正重みのファイルだけを残すと、CPUエキスパートの追加重みが欠落する。save_only_model: falseを維持し、学習状態をまとめたチェックポイントディレクトリ全体を保存する必要がある。再開には、同じモデル・キャッシュ・分散プロセス数・学習対象・学習率スケジュールの全期間が必要である。
以下のエクスポートツールは、元データの同一性、ハッシュ、追加重みの形状などを検査し、元データは変更しない。
python -m kt_kernel.sft.export_dsv4_sglang_adapter \
  --source /models/DeepSeek-V4-Flash \
  --cache /cache/v4-non-experts \
  --adapter /runs/v4/checkpoint-20 \
  --output /deploy/v4-adapter
出力物は通常の追加重みを統合したモデルと、CPUエキスパート用の追加重みに分かれ、両方が必要となる。
SGLangでの推論には対応する依存関係のロックファイルを使用し、エキスパートをCPUに置く。検証済みのリクエスト長は入力と出力の合計2048トークンである。
4. 数値で確認された範囲
学習統合に先立つ単独カーネルの検証は、DeepSeek-V4-Flash-0731の単一エキスパート層を対象にした。サーバーはAMD EPYC 9355を2基、物理コア64個・ハードウェアスレッド128個の構成である。
AVX512-BF16を使用し、AMXは使わなかった。実際のチェックポイントの3番層で、エキスパート256個、隠れ次元4096、中間次元2048、トークン当たりの選択数6個、追加重みの次元8、トークン長2で試験した。
このとき圧縮層の保存量は3,623,878,656バイトだった。分割数が1のTP1と2のTP2の最大常駐メモリは、それぞれ11.699 GiBと11.623 GiBで、元のテンソル・一時的な分割準備領域・カーネルの圧縮コピーを含む。
最初のトークンが選択したエキスパート6個の展開済み重みの基準値と比較した。値の差を示す相対L2誤差は最大0.007374、方向の一致を示すコサイン類似度は最小0.999973だった。
同じ機器での合成試験は、エキスパート4個、隠れ次元・中間次元各256、トークン当たりの選択数2個、追加重みの次元8、分割数1・2、学習用の勾配累積1・2・8回の条件だった。32ビット数値形式であるFP32の基準値に対し、相対L2誤差は最大0.008501、コサイン類似度は最小0.999965だった。
5. 導入判断に残る限界
実際の層を使った試験では、追加重みの更新後も元データの同一性を判定するハッシュは変化しなかった。
トークン長2での実行観測は正確性の確認用であり、スループットやレイテンシーの根拠にはならない。モデル全体の損失・品質・再開・スループットの測定結果は示されていない。
統合ドキュメントの対応範囲でも、複数の会話を1つの学習シーケンスにまとめること、全モジュールの一括指定、動的なアダプター交換、他のモデル派生版は対象外となっている。
今回のバージョンの価値は、圧縮エキスパートの学習を保存・推論までつなぐ点にあり、導入時にはパッケージの組み合わせとリソース配置も併せて計画する必要がある。