KRAFTON AI于10月21日在Hugging Face发布Raon-1 mini预览版。这款30B级开放权重模型主打韩语对话和指令遵循,为寻找可接入自身服务的韩语模型的团队增加了一个选择。它采用MoE设计,即每个token仅调用部分专家,在总计28.8B的模型参数中,每个token只用4.3B参与计算。模型支持262,144个token的上下文,以及调用外部工具的工具调用功能。按公司基准测试,搭配DFlash2草稿模型时,单张B300的输出吞吐量最高可达常规解码的2.18倍。
一览
表:Raon-1 mini preview主要规格
条件:Hugging Face模型卡所列规格,2026-10-21发布
权重采用需申请批准的门控访问方式,获批后只需登录HF一次,即可下载Raon-1 mini preview系列的所有仓库。Apache 2.0许可证适用于权重和配置文件,不适用于训练数据和托管API。
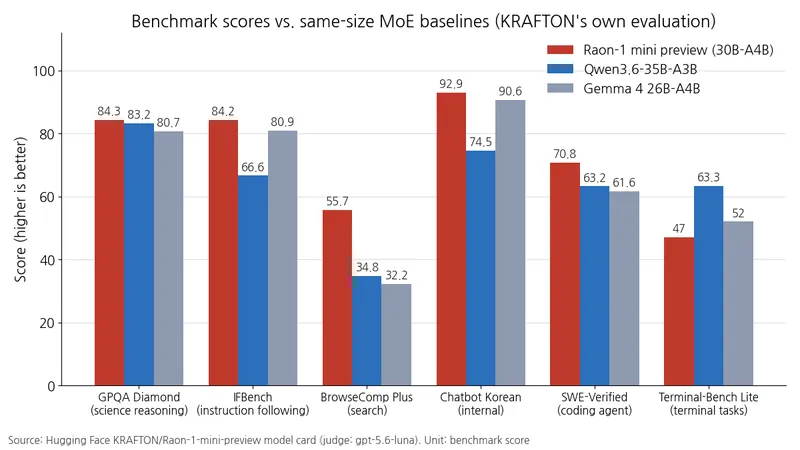
性能:相比MoE对比模型,指令遵循、搜索与韩语对话领先
条件:KRAFTON自行评测,评判模型与用户模拟器为gpt-5.6-luna;SWE-Verified通过mini-SWE-agent评测框架这一执行评测任务的工具集测量;Chatbot Korean为内部基准,对比对象为2款MoE模型
单位:基准测试得分
上表6项评测中,与对比模型分差最大的是搜索评测BrowseComp Plus。编码智能体项目领先,但终端任务项目落后于对比模型。SWE-Verified衡量智能体读取代码库并修复GitHub问题的能力。韩语对话项目与Qwen3.6-35B-A3B的分差也超过18分。
推理速度:单张B300上DFlash2草稿模型带来的差距
条件:单张NVIDIA B300,vLLM 0.28.0,MXFP8目标模型,块大小8(草稿7个token),随机草稿采样,temperature 1.0、top-p 0.95、top-k 20,启用thinking,最多新生成4,096个token,并发数1,每项基准128条提示词(MT-Bench为80条)
单位:AL为每次验证平均接受的token数,吞吐量为tok/s,倍数相对于常规解码
推测解码由小模型提出接下来的多个token,再由目标模型验证,以提高输出吞吐量。AL表示一次验证平均接受多少个token。公司测量结果中,数学题的倍数最大,对话评测MT-Bench最小。MT-Bench的并发数提高到8时,倍数降至1.38倍,提高到32时降至1.56倍。
价格与成本:托管API限时免费
KRAFTON为庆祝发布,限时免费开放托管API和官方体验平台,并表示可能对每位用户的token用量与请求次数设限。用户也可以在Apache 2.0许可证范围内下载权重,在自己的GPU上运行。平台采用提交申请后,通过电子邮件发送控制台邀请链接的方式。
有何变化:25层中18层采用线性注意力
公司称,Raon Delta Attention将Kimi Delta Attention中控制信息流的遗忘门与写入门分离,相比KDA改善了长上下文性能。Raon-mHC则通过降低DeepSeek的mHC(带约束的超连接)的计算成本来加快训练。KV缓存是保存此前token信息的内存,仅在7个全注意力层中保留,BF16下每个token约占8KiB。
隐藏维度即模型内部表示的维数为2,560,线性注意力与全注意力的注意力头数均为40,词表大小为259,840。模型不使用为表示加入token顺序信息的位置编码。量化即把模型数值转为低精度,此次同时提供MXFP8 8位与NVFP4 4位格式。NVFP4检查点即保存的模型状态文件,是28.8B模型的4位量化版本,公司表示可在单张32GB VRAM NVIDIA RTX 5090上运行。DFlash2草稿模型规模为0.68B。KRAFTON称模型使用韩语、英语、日语、中文、西班牙语、法语和泰语训练。
如何试用
在Hugging Face提交权重访问申请后,系统会自动批准。下载后,启动兼容OpenAI的API服务器较为方便。
vllm serve KRAFTON/Raon-1-mini-preview \
  --max-model-len 262144 \
  --kv-cache-dtype fp8_e4m3 \
  --spec-method dflash \
  --spec-model KRAFTON/Raon-1-mini-preview-dflash2 \
  --spec-tokens 7 \
  --reasoning-parser raon_1 \
  --enable-auto-tool-choice \
  --tool-call-parser raon_1
vLLM需从KRAFTON维护的分支安装,即从原项目分出并独立修改的代码。首次运行需编译内核,据称约需10分钟,后续运行会复用已编译的内核。Hermes Agent、Pi、OpenCode等智能体框架可将这个已启用工具调用与推理解析器的服务器地址注册为OpenAI兼容提供商。若只想在终端运行,可自行构建KRAFTON的llama.cpp分支并运行GGUF检查点,或下载适用于Apple芯片的MLX检查点,官方也提供了Docker镜像运行说明。采样默认推荐值为temperature 1.0、top-p 0.95、top-k 20,默认启用thinking模式。编码与数学任务建议将presence_penalty降至0。
局限
由于是预览版,正式版发布前规格与结果可能变化,韩语对话基准也仅供KRAFTON内部使用。MMLU Pro成绩低于两款MoE对比模型,长上下文评测低于Qwen3.6-35B-A3B,但高于Gemma 4 26B-A4B。官方明确表示,此次免费开放的托管API未来可能调整收费或政策。
若团队想自行尝试韩语聊天机器人或内部智能体流水线,可先测试公司所称能在单张32GB VRAM NVIDIA RTX 5090上运行的NVFP4检查点;若需要API密钥,则在官方体验平台限时免费确认响应速度和韩语质量会更快捷。