크래프톤 AI가 10월 21일 Hugging Face에 Raon-1 mini 프리뷰를 공개했다. 회사가 한국어 대화와 지시 따르기를 강점으로 내세운 30B급 오픈 웨이트, 가중치를 공개한 모델이 나온 셈이라, 자사 서비스에 붙일 한국어 모델을 찾는 팀의 선택지가 하나 늘었다. 총 28.8B 파라미터, 모델 학습값을 이루는 수치 중 토큰마다 4.3B만 계산에 쓰는 MoE(토큰마다 일부 전문가만 동원하는 혼합 모델) 설계에 262,144토큰 컨텍스트와 툴 콜링, 모델이 외부 도구를 호출하는 기능을 넣었다. 회사 벤치마크 기준으로 DFlash2 드래프트 모델을 함께 쓰면 B300 1장에서 일반 디코딩 대비 출력 처리량이 최대 2.18배가 된다.
한눈에 보기
표: Raon-1 mini preview 주요 사양
조건: Hugging Face 모델 카드에 기재된 사양, 2026-10-21 공개
가중치는 요청 승인이 필요한 게이트 방식, 접근 권한을 승인으로 제어하는 방식이고, 승인 뒤 HF 로그인 한 번으로 Raon-1 mini preview 계열 저장소를 모두 받을 수 있다. Apache 2.0 라이선스는 가중치와 설정 파일에 적용되며 학습 데이터와 호스팅 API에는 적용되지 않는다.
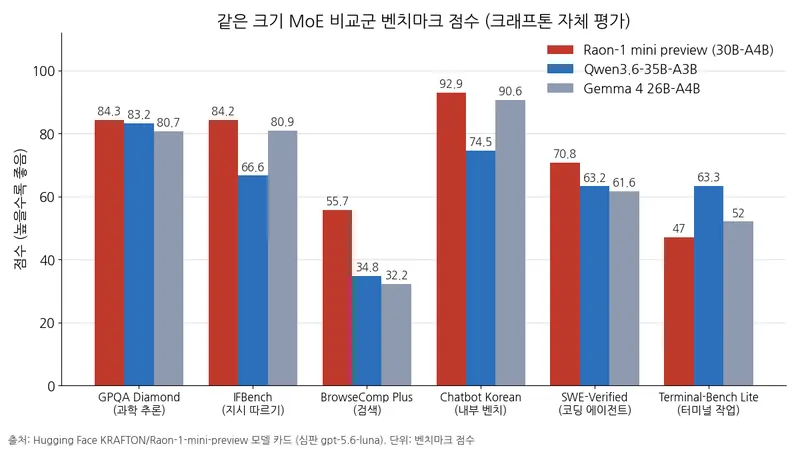
성능: MoE 비교군과 보면 지시 따르기·검색·한국어 대화가 앞선다
조건: 크래프톤 자체 평가, 심판·사용자 시뮬레이터 gpt-5.6-luna, SWE-Verified는 mini-SWE-agent 하네스, 평가 작업을 실행하는 도구 묶음으로 측정, Chatbot Korean은 내부 벤치, 비교 대상은 MoE 모델 2종
단위: 벤치마크 점수
위 표에 실은 6개 평가 가운데 비교 대상과 점수 차이가 가장 큰 항목은 검색 평가인 BrowseComp Plus였다. 코딩 에이전트 항목은 앞섰지만 터미널 작업 항목은 비교군에 밀렸다. SWE-Verified는 에이전트가 코드베이스를 읽고 GitHub 이슈를 고치는 능력을 재는 평가다. 한국어 대화 항목도 Qwen3.6-35B-A3B와는 점수 차이가 18점을 넘었다.
추론 속도: B300 1장에서 DFlash2 드래프트가 만드는 격차
조건: 단일 NVIDIA B300, vLLM 0.28.0, MXFP8 타깃, 블록 크기 8(드래프트 7토큰), 확률적 드래프트 샘플링, temperature 1.0·top-p 0.95·top-k 20, thinking 활성화, 최대 생성 신규 토큰 4,096개, 동시성 1, 벤치마크당 프롬프트 128개(MT-Bench는 80개)
단위: AL은 검증당 평균 채택 토큰 수, 처리량은 tok/s, 배수는 일반 디코딩 대비
스펙큘레이티브 디코딩은 작은 모델이 이어질 여러 토큰을 제안하고 타깃 모델이 검증해 출력 처리량을 높이는 방식이다. AL은 검증 한 번에 평균 몇 토큰이 채택되는지를 뜻한다. 회사 측정치로는 수학 문제에서 배수가 가장 크고 대화형 평가인 MT-Bench에서 가장 작았다. MT-Bench에서 동시성을 8로 올리면 배수는 1.38배, 32로 올리면 1.56배로 낮아진다.
가격과 비용: 호스팅 API는 한정 무료
크래프톤은 출시를 기념해 호스팅 API와 공식 플레이그라운드를 한정 무료로 열었고, 사용자별 토큰 사용량과 요청 수 제한이 적용될 수 있다고 안내했다. Apache 2.0 라이선스 범위에서 가중치를 직접 받아 자기 GPU에서 돌리는 경로도 가능하다. 플랫폼은 신청서를 남기면 콘솔 초대 링크를 이메일로 보내는 방식이다.
무엇이 달라졌나: 25층 중 18층이 선형 어텐션
Raon Delta Attention은 Kimi Delta Attention의 삭제·쓰기 게이트, 정보 흐름을 조절하는 장치를 분리해 KDA 대비 장문 맥락 성능을 개선한 구조라고 회사는 설명했다. Raon-mHC는 DeepSeek의 mHC(제약이 있는 하이퍼 커넥션) 연산 비용을 줄여 학습을 빠르게 한다는 설명이다. KV 캐시(지난 토큰 정보를 저장하는 메모리)는 전체 어텐션 7개 층만 유지하며 BF16 기준 토큰당 약 8KiB다.
히든 크기, 모델 내부 표현의 차원 수는 2,560이고 어텐션 헤드는 선형 어텐션과 전체 어텐션 모두 40개이며 어휘 크기는 259,840이다. 위치 인코딩, 토큰 순서 정보를 표현에 더하는 방식은 쓰지 않는다. 양자화, 모델 수치를 낮은 정밀도로 바꾸는 방식은 MXFP8 8비트와 NVFP4 4비트 포맷이 함께 올라왔고, NVFP4 체크포인트, 저장해 둔 모델 상태 파일은 28.8B 모델의 4비트 양자화본으로, 회사는 이 NVFP4가 32GB VRAM NVIDIA RTX 5090 한 장에서 구동된다고 안내한다. DFlash2 드래프트 모델은 0.68B 규모다. 크래프톤은 한국어·영어·일본어·중국어·스페인어·프랑스어·태국어로 학습했다고 밝혔다.
써 보려면
가중치는 Hugging Face에서 요청을 넣으면 승인이 자동 처리된다. 내려받은 뒤에는 OpenAI 호환 API 서버를 띄우는 쪽이 편하다.
vllm serve KRAFTON/Raon-1-mini-preview \
  --max-model-len 262144 \
  --kv-cache-dtype fp8_e4m3 \
  --spec-method dflash \
  --spec-model KRAFTON/Raon-1-mini-preview-dflash2 \
  --spec-tokens 7 \
  --reasoning-parser raon_1 \
  --enable-auto-tool-choice \
  --tool-call-parser raon_1
vLLM은 크래프톤이 관리하는 포크, 원본에서 갈라 독자 수정한 코드에서 설치하며, 첫 실행에 커널을 컴파일하므로 10분쯤 걸린다고 한다. 이후 실행에서는 컴파일한 커널을 재사용한다. 에이전트 하네스인 Hermes Agent, Pi, OpenCode는 툴 콜링과 추론 파서를 켠 이 서버 주소를 OpenAI 호환 프로바이더로 등록해 쓰면 된다. 터미널에서만 돌리려면 크래프톤의 llama.cpp 브랜치를 직접 빌드해 GGUF 체크포인트를 돌리거나 Apple 실리콘용 MLX 체크포인트를 받으면 되고, Docker 이미지 실행 방식도 안내돼 있다. 샘플링은 temperature 1.0, top-p 0.95, top-k 20이 기본 권장값이고 thinking 모드가 기본 설정이다. 코딩과 수학 작업에서는 presence_penalty를 0으로 낮추라고 안내한다.
한계
프리뷰 릴리스라 최종본 이전에 사양과 결과가 바뀔 수 있고, 한국어 대화 벤치마크는 크래프톤 내부 전용이다. MMLU Pro에서는 두 MoE 비교군보다 낮고, 장문 컨텍스트 평가에서는 Qwen3.6-35B-A3B보다 낮지만 Gemma 4 26B-A4B보다 높고, 무료로 열었던 호스팅 API는 향후 과금이나 정책이 바뀔 수 있다고 명시했다.
한국어 챗봇이나 내부 에이전트 파이프라인을 혼자 돌려 볼 팀이라면 회사가 안내한 32GB VRAM NVIDIA RTX 5090 한 장 구동 NVFP4 체크포인트부터 직접 시험해 보고, API 키가 필요하면 공식 플레이그라운드에서 한정 무료로 응답 속도와 한국어 품질을 확인하는 편이 빠르다.