KRAFTON AIは10月21日、Hugging FaceでRaon-1 miniのプレビューを公開した。同社が韓国語での対話と指示追従を強みとする30B級のオープンウェイト、つまり重みを公開したモデルが登場し、自社サービス向けの韓国語モデルを探すチームの選択肢が増えた。総28.8Bパラメータという学習値のうち、トークンごとに4.3Bだけを計算に使うMoE(一部の専門家のみを動員する混合モデル)設計を採用した。262,144トークンのコンテキストと、外部ツールを呼び出すツールコーリングに対応する。同社のベンチマークでは、DFlash2ドラフトモデルを併用するとB300 1枚で通常のデコーディングに対し出力スループットが最大2.18倍になる。
ひと目で分かる概要
表:Raon-1 mini previewの主な仕様
条件:Hugging Faceのモデルカード記載の仕様、2026-10-21公開
重みはリクエストの承認が必要なゲート方式で、承認によってアクセス権を制御する。承認後はHFへの1回のログインでRaon-1 mini preview系列の全リポジトリを取得できる。Apache 2.0ライセンスは重みと設定ファイルに適用され、学習データとホスティングAPIには適用されない。
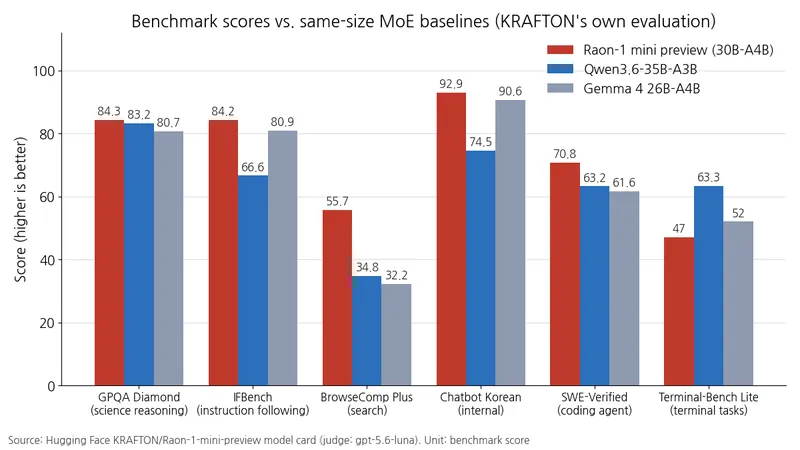
性能:MoE比較群に対し指示追従・検索・韓国語対話で上回る
条件:KRAFTONの独自評価、審判・ユーザーシミュレーターはgpt-5.6-luna、SWE-Verifiedは評価タスクを実行するツール群であるmini-SWE-agentハーネスで測定、Chatbot Koreanは内部ベンチマーク、比較対象はMoEモデル2種
単位:ベンチマークスコア
上の表に掲載した6項目の評価で、比較対象とのスコア差が最も大きかったのは検索評価のBrowseComp Plusだった。コーディングエージェントの項目では上回ったが、ターミナル作業の項目では比較群に劣った。SWE-Verifiedは、エージェントがコードベースを読み、GitHubのイシューを修正する能力を測る評価だ。韓国語対話の項目でもQwen3.6-35B-A3Bとのスコア差は18点を超えた。
推論速度:B300 1枚でDFlash2ドラフトが生む差
条件:単一NVIDIA B300、vLLM 0.28.0、MXFP8ターゲット、ブロックサイズ8(ドラフト7トークン)、確率的ドラフトサンプリング、temperature 1.0・top-p 0.95・top-k 20、thinking有効、最大新規生成トークン数4,096、同時実行数1、ベンチマークごとにプロンプト128個(MT-Benchは80個)
単位:ALは検証ごとの平均採用トークン数、スループットはtok/s、倍率は通常のデコーディング比
投機的デコーディングは、小さなモデルが後続の複数トークンを提案し、ターゲットモデルが検証することで出力スループットを高める方式だ。ALは1回の検証で平均何トークンが採用されるかを示す。同社の測定では、数学問題で倍率が最も大きく、対話型評価のMT-Benchで最も小さかった。MT-Benchで同時実行数を8に増やすと倍率は1.38倍、32に増やすと1.56倍に下がる。
価格と費用:ホスティングAPIは期間限定で無料
KRAFTONはリリースを記念し、ホスティングAPIと公式プレイグラウンドを期間限定で無料公開した。ユーザーごとのトークン使用量とリクエスト数に制限が適用される場合があると案内している。Apache 2.0ライセンスの範囲内で重みを直接取得し、自分のGPUで動かすこともできる。プラットフォームは申請書を送信すると、コンソールの招待リンクがメールで届く方式だ。
何が変わったか:25層のうち18層が線形アテンション
同社によると、Raon Delta AttentionはKimi Delta Attentionの情報の流れを調整する削除・書き込みゲートを分離し、KDAに比べ長文コンテキスト性能を改善した構造だ。Raon-mHCはDeepSeekのmHC(制約付きハイパーコネクション)の演算コストを減らし、学習を高速化するという。過去のトークン情報を保存するメモリであるKVキャッシュは、全アテンションの7層だけで保持し、BF16でトークンあたり約8KiBとなる。
モデル内部表現の次元数である隠れサイズは2,560、アテンションヘッド数は線形アテンションと全アテンションのいずれも40、語彙サイズは259,840だ。トークンの順序情報を表現に加える位置エンコーディングは使わない。モデルの数値を低精度に変換する量子化では、MXFP8 8ビットとNVFP4 4ビットの形式が公開された。保存済みモデル状態ファイルであるNVFP4チェックポイントは28.8Bモデルの4ビット量子化版で、同社は32GB VRAMのNVIDIA RTX 5090 1枚で動作すると案内している。DFlash2ドラフトモデルの規模は0.68Bだ。KRAFTONは韓国語・英語・日本語・中国語・スペイン語・フランス語・タイ語で学習したと明らかにした。
試すには
重みはHugging Faceでリクエストすると自動承認される。ダウンロード後はOpenAI互換APIサーバーを起動するのが便利だ。
vllm serve KRAFTON/Raon-1-mini-preview \
  --max-model-len 262144 \
  --kv-cache-dtype fp8_e4m3 \
  --spec-method dflash \
  --spec-model KRAFTON/Raon-1-mini-preview-dflash2 \
  --spec-tokens 7 \
  --reasoning-parser raon_1 \
  --enable-auto-tool-choice \
  --tool-call-parser raon_1
vLLMはKRAFTONが管理する、元のコードから分岐して独自に修正したフォークからインストールする。初回起動時はカーネルをコンパイルするため10分ほどかかるという。その後の起動ではコンパイル済みカーネルを再利用する。エージェントハーネスのHermes Agent、Pi、OpenCodeでは、ツールコーリングと推論パーサーを有効にしたこのサーバーのアドレスをOpenAI互換プロバイダーとして登録すればよい。ターミナルだけで動かすなら、KRAFTONのllama.cppブランチを直接ビルドしてGGUFチェックポイントを動かすか、Appleシリコン向けMLXチェックポイントを取得する。Dockerイメージでの実行方法も案内されている。サンプリングの標準推奨値はtemperature 1.0、top-p 0.95、top-k 20で、thinkingモードが既定の設定だ。コーディングと数学のタスクではpresence_penaltyを0に下げるよう案内している。
限界
プレビューリリースのため、最終版までに仕様や結果が変わる可能性があり、韓国語対話ベンチマークはKRAFTONの内部専用だ。MMLU ProではMoE比較群2種を下回る。長文コンテキスト評価ではQwen3.6-35B-A3Bを下回るが、Gemma 4 26B-A4Bを上回る。無料公開したホスティングAPIは今後、課金やポリシーが変わる可能性があると明記している。
韓国語チャットボットや内部エージェントを自前で動かすチームは、32GB VRAMのNVIDIA RTX 5090 1枚で動くNVFP4チェックポイントを試し、APIが必要なら公式プレイグラウンドの期間限定無料利用で速度と韓国語品質を確認できる。