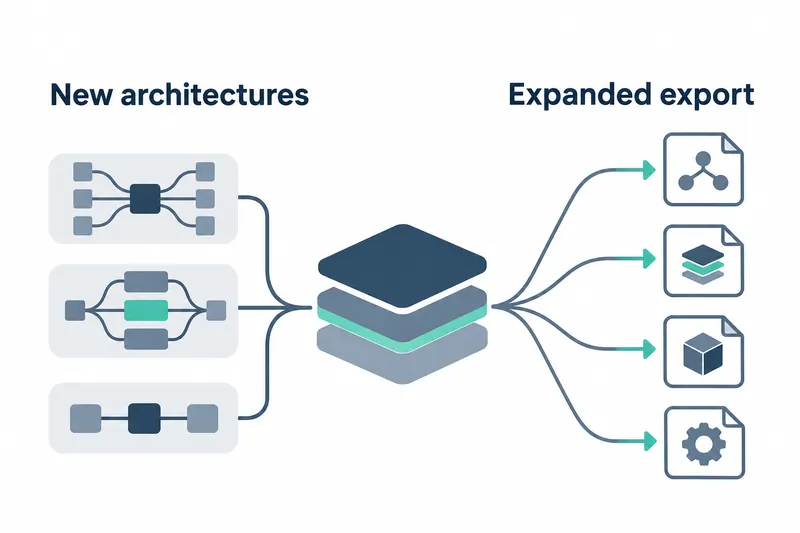
Transformers 新增了包括判别头在内的七项模型支持,并将模型导出到多种运行环境后再运行的步骤统一起来。不仅使用新模型的开发者,共享和运行部署模型的团队也能利用新流程,但现有导出代码需要部分修改。
1. 共享并重新运行已导出模型的流程实现统一
新的导出流程不止于生成部署模型,还衔接了保存、共享和运行环节。返回的 ExportedModel 对象像原始模型一样接收参数,并返回相同的输出类。开发者可以将其上传到 Hub,再下载到对应的运行环境中使用。
准备好模型和输入后,导出为 ONNX Runtime 格式并共享的原文示例如下。最后一次调用沿用了导出前调用模型的形式。
exported = OnnxExporter().export(model, inputs, OnnxConfig(dynamic=True, ort_fusions="cuda"))
exported.push_to_hub("my-org/embeddinggemma-2-onnx")

exported_model = ExportedModel.from_pretrained("my-org/embeddinggemma-2-onnx", device="cuda")
outputs = exported_model(**inputs)  # same output class as model(**inputs)
导出结果也可以放在模型仓库的子文件夹中。export.json 会记录配置、输入形状、软件包版本和输入输出名称。降低权重表示精度后的量化结果也能以相同方式保存和运行,因此这类模型也可以共享。
2. 扩展多模态、代码和判别模型支持
Thinking Machines Lab 的 Inkling 2 Small 接收文本和图像,输出文本。其混合专家架构针对每次输入仅选择模型中的部分专家进行计算。该模型的总参数量为 594B,激活参数量为 17B。
Liquid AI 的 LFM3 是结合卷积与注意力机制的语言模型,注意力机制用于计算输入元素之间的关联程度。LFM3-VL 则是在此基础上增加图像和视频处理能力的模型系列。
Dots 3 Note Preview 是支持文本、图像、视频和音频输入的混合专家模型。
此次还新增了判别头 JEV。这一组件根据提示词的最后一个 token,为单 token 标签打分。
IQuest-Coder-V1 是代码模型系列,InternLM3 则是经过指令调优的语言模型。两者均可利用现有 Llama 实现,通过自动类加载,减少了为每个模型单独熟悉运行实现的负担。
3. 运行速度因后端和比较基准而异
导出过程中会将多个运算合并为适合运行环境的单个运算,以降低处理开销。ONNX Runtime 将其用于注意力、归一化等调整数值大小或分布的处理。OpenVINO 也通过自有 CPU 内核,即直接执行运算的底层代码,处理注意力和压缩权重等。据公司公布的数据,逐步生成输出的解码阶段速度提升至原来的 2.4~3.9倍。
性能示例采用 EmbeddingGemma2 模型,输入为 8 × 128 个 token。据公司公布的数据,在 A100 上,采用 TensorRT 执行路径的 ONNX Runtime 速度为 PyTorch 默认执行的 7.6倍,为 torch.compile 的 1.4倍。
据公司公布的数据,同一模型与输入在 Xeon Platinum 8570 上运行时,OpenVINO 的速度为默认执行的 4.1倍,为编译执行的 2.2倍。将权重改为 int8 后,分别为 4.9倍和 2.6倍。这表明,团队在各自设备上原先采用默认执行还是编译执行,会影响可预期的提升幅度。
4. 返回值和保存方式需适配新接口
迁移现有导出代码时,应先检查接收结果的部分。返回值改为 ExportedModel,ONNX 程序则采用 onnx_ir.Model 格式。
用于指定保存路径的 output_path 选项已移除,保存操作改用 save_pretrained。
自定义运行后端通过 register_backend 注册。
采用循环结构的 IQuest-Coder-V1 Loop 检查点,即保存训练状态的模型资料,不在支持范围内,判别头和流水线仍处于实验阶段。性能数据来自不同设备,而前述解码性能提升范围未同时给出模型、输入和硬件信息。
5. 统一流程的收益伴随着代码修改成本
统一流程的好处在于,其他开发者拿到导出结果后,可以采用相同的调用方式运行。与此同时,现有用户需要承担返回格式和保存代码的迁移成本。面向多种部署目标的团队可以评估共享流程的复用效果,已实现导出自动化的团队则值得先检查发生变化的接口。
本次版本在增加可选模型的同时,也有助于复用部署结果;是否采用,应重点权衡各运行环境中的收益与现有代码的迁移成本。