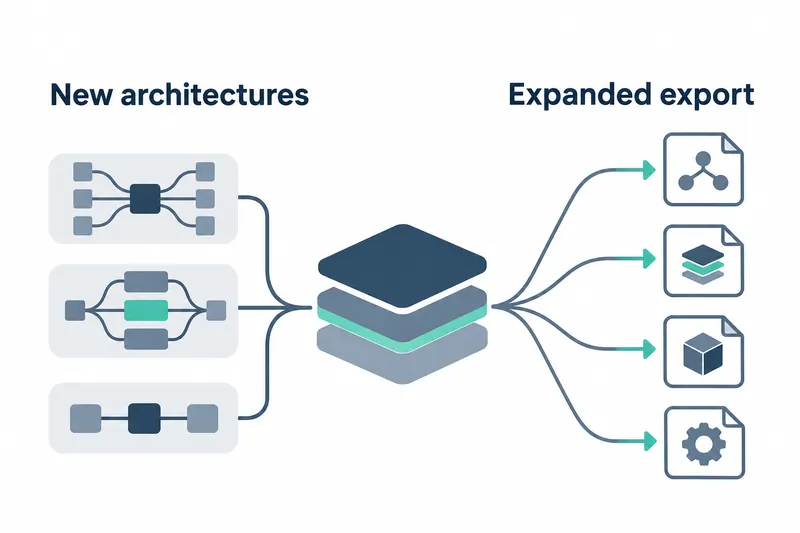
Transformersは判定用ヘッドを含む7つのモデル対応項目を追加し、複数の実行環境へモデルをエクスポートして再実行する手順を一つの方式にまとめた。新モデルを使いたい開発者だけでなく、デプロイ用モデルを共有・実行するチームも変更後の経路を活用できるが、既存のエクスポートコードには一部修正が必要だ。
1. エクスポートしたモデルの共有と再実行の流れを統合
新しいエクスポート経路は、デプロイ用モデルの作成にとどまらず、保存・共有・実行までをつなぐ。結果として得られるExportedModelオブジェクトは、元のモデルと同様に引数を受け取り、同じ出力クラスを返す。開発者はこれをハブにアップロードし、再びダウンロードして該当する実行環境で利用できる。
モデルと入力を用意した後、ONNX Runtime向けにエクスポートして共有する原文の例は次のとおりだ。最後の呼び出しは、エクスポート前のモデルを呼び出していた形式をそのまま使う。
exported = OnnxExporter().export(model, inputs, OnnxConfig(dynamic=True, ort_fusions="cuda"))
exported.push_to_hub("my-org/embeddinggemma-2-onnx")

exported_model = ExportedModel.from_pretrained("my-org/embeddinggemma-2-onnx", device="cuda")
outputs = exported_model(**inputs)  # same output class as model(**inputs)
エクスポートした結果は、モデルリポジトリのサブフォルダーにも配置できる。export.jsonには設定、入力の形状、パッケージのバージョン、入出力名が記録される。重みの表現精度を下げた量子化の結果も同じ方法で保存・実行でき、こうしたモデルも共有の対象となる。
2. マルチモーダル・コード・判定用モデルへの対応を拡大
Thinking Machines LabのInkling 2 Smallは、文章と画像を受け取り文章を出力する。混合エキスパート構造は、入力ごとにモデル内の一部のエキスパートだけを選んで計算する方式だ。このモデルの総パラメーター数は594B、アクティブパラメーター数は17Bだ。
Liquid AIのLFM3は、畳み込みと、入力要素間の関連度を計算するアテンションを組み合わせた言語モデルだ。LFM3-VLは、これに画像・動画の処理機能を加えたモデル群だ。
Dots 3 Note Previewは、テキスト・画像・動画・音声の入力を受け取る混合エキスパートモデルだ。
判定用ヘッドのJEVも追加された。これはプロンプトの最後のトークンを基に、単一トークンのラベルにスコアを付ける部品だ。
IQuest-Coder-V1はコードモデル群で、InternLM3は指示に沿って回答するよう調整された言語モデルだ。どちらも既存のLlama実装を活用して自動クラスで読み込めるため、モデルごとに個別の実行実装を学ぶ負担を減らせる。
3. 実行速度はバックエンドと比較基準で変わる
エクスポート時には、複数の演算を実行環境に適した一つの演算にまとめ、処理負担を減らす。ONNX Runtimeはアテンションや正規化、値の大きさや分布を調整する処理などにこれを適用する。OpenVINOも独自のCPUカーネルという演算を直接実行する低水準コードでアテンションや圧縮重みなどを処理し、同社発表では出力を順次生成するデコード段階が従来より2.4~3.9倍高速化した。
性能例は、モデルEmbeddingGemma2に8 × 128トークンを入力した結果だ。同社発表では、A100上でTensorRT実行経路を使ったONNX Runtimeは、PyTorchの標準実行より7.6倍、torch.compileより1.4倍高速だった。
同じモデルと入力でXeon Platinum 8570上で実行したOpenVINOは、同社発表では標準実行より4.1倍、コンパイル実行より2.2倍高速だった。重みをint8に変えると、それぞれ4.9倍と2.6倍だった。この結果は、各機器で標準実行とコンパイル実行のどちらを使っていたチームかによって、期待できる改善幅が異なることを示す。
4. 戻り値と保存方法を新インターフェースに合わせる
既存のエクスポートコードを移行する際は、結果を受け取る部分から確認する必要がある。戻り値はExportedModelに変わり、ONNXプログラムはonnx_ir.Model形式になる。
保存先を指定していたoutput_pathオプションは廃止され、保存にはsave_pretrainedを使う。
独自に作成した実行バックエンドはregister_backendで登録する。
反復構造を使うIQuest-Coder-V1 Loopのチェックポイント、つまり学習状態を保存したモデルデータはサポート対象外であり、判定用ヘッドとパイプラインは実験段階だ。性能値は異なる機器での結果であり、先に示したデコードの改善範囲には、モデル・入力・ハードウェアの情報が併記されていなかった。
5. 統合の利点にはコード変更のコストも伴う
統合経路の利点は、エクスポートした結果を別の開発者が受け取り、同じ呼び出し方で実行できる点にある。一方、既存ユーザーは戻り値の形式と保存コードの移行コストを負担する。デプロイ先が複数あるチームは共有の流れを再利用する効果を、すでにエクスポートを自動化したチームは変更される接点から確認するとよい。
今回のバージョンは、選べるモデルを増やすと同時にデプロイ結果の再利用を助ける変更であり、導入判断の中心は実行環境ごとの利点と既存コードの移行コストだ。