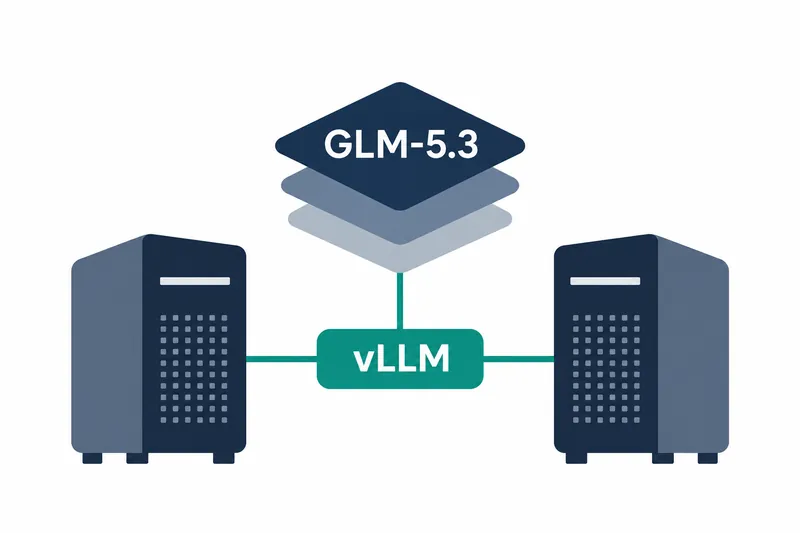
NVIDIA 公布了在两台 DGX Station 上协同运行大型语言模型 GLM-5.3,并通过单一 API 提供服务的流程。希望将单张 GPU 无法容纳的模型拆分到两张 GPU 上自行部署的开发团队,可以基于该配置搭建本地推理服务,并测试并发请求性能。
1. 量化后仍超出单张 GPU 容量的模型
GLM-5.3 NVFP4 的总参数量为 7530 亿,每个令牌激活 400 亿参数。虽然计算时只选择适合任务的部分参数,但所有候选权重都必须驻留内存。NVIDIA 博客称,检查点大小约为 464GB,超过单张 GB300 GPU 的 252GB 显存。
介绍模型规格及使用信息的模型卡说明,该模型对混合专家架构的线性运算应用了 4 位量化,即每次输入只选择部分子模型参与计算。NVIDIA 表示,将相关权重和激活值的精度从 8 位降至 4 位,使磁盘和 GPU 显存需求缩减至原来的约 1/1.66。
指南中的配置不将权重卸载至 CPU 内存,而是采用张量并行,将权重和计算分配给两张 GPU。一台设备接收 API 请求,两台设备共同处理每个请求,因此用户只需连接一个兼容 OpenAI 的 API。
2. 两端均需准备模型副本和高速连接
每台 Station 都在磁盘上保存完整的检查点副本,即存储已训练模型状态的文件,因此每台都需要至少 464GB 的模型存储可用空间。指南先在一端下载模型,再复制到另一端,并比较文件列表和大小。实际加载到 GPU 时,vLLM 会将权重拆分到两张 GPU 上。
两台设备通过 ConnectX-8 连接使用 RDMA 通信,在 GPU 显存之间直接交换计算结果。NVIDIA 指导用户在准备阶段确认连接速率达到 400000Mb/s、大数据包传输成功以及时间同步。
启动后需检查 API 状态和通信日志。根据启动日志,每张 GPU 加载的权重约为 218GiB,约占整个模型的一半。
3. 先启动工作节点,再通过单一 API 发送请求
指南中的 vLLM 0.30.0 配置通过多令牌预测 MTP,在一个步骤中生成四个令牌的草稿,再由完整模型验证,从而加快输出。前缀缓存还可减少对已处理提示词前部的重复计算。
FP8 KV 缓存保存进行中请求的上下文,与 16 位存储相比,可将缓存内存需求减半。
先启动工作节点,再启动提供 API 的节点。日志显示服务启动完成后,通过健康检查和请求确认响应。原文的请求示例需在完成两台设备的容器和环境变量设置后使用。
docker exec "$CONTAINER" curl -fsS --max-time 120 \
 "http://127.0.0.1:$PORT/v1/chat/completions" \
 -H 'Content-Type: application/json' \
 -d '{"model":"nvidia/GLM-5.3-NVFP4",
 "messages":[{"role":"user","content":"Quarterly units sold: Q1 = 120; Q2 = 180; Q3 = 150. Summarize the trend in one sentence and calculate the percentage change from Q1 to Q2."}],
 "temperature":0,"max_tokens":4096,
 "chat_template_kwargs":{"reasoning_effort":"low"}}' |
python3 -c 'import json,sys; c=json.load(sys.stdin)["choices"][0];
print(c["message"]["content"]); print("finish_reason:",c["finish_reason"])'
该示例同时输出响应内容和结束原因,以确认是否正常完成。此请求的推理强度设为低,而下文的负载测试使用默认的最高强度。
4. 增加并发请求,吞吐量与响应速度此消彼长
NVIDIA 使用 AIPerf 和 SPEED-Bench Coding 的 80 段对话测量负载。每个阶段先发送并发请求数三倍的预热请求,再测量十倍数量的请求,预热不计入统计。输出令牌包含回答前的推理。
以下是该公司公布的、并发处理上限固定为 16 时的结果。
表:并发处理上限为 16 时,不同请求数下的吞吐量与延迟
条件:两台配备 GB300 GPU 的 DGX Station、GLM-5.3 NVFP4、张量并行度 2、vLLM 并发处理上限 16、上下文上限 98304 令牌、SPEED-Bench Coding、前缀缓存、四令牌 MTP、FP8 KV 缓存、推理强度 max、输出上限 8192 令牌
单位:吞吐量 tok/s,延迟 s
| 并发请求数 | 总吞吐量 (tok/s) | 平均每用户吞吐量 (tok/s) | 平均请求延迟 (s) |
|---|---|---|---|
| 1 | 107.4 | 115.3 | 49.84 |
| 8 | 386.0 | — | 114.17 |
| 16 | 607.8 | — | 136.46 |
据该公司公布的数据,此配置在 16 个并发请求下的总吞吐量为 607.8tok/s。并发请求越多,总吞吐量越高,但平均延迟也越长。这体现了容纳更多用户的能力与每位用户等待时间之间的权衡。
另一项测试将并发处理上限改为 32,并同时发送 32 个并发请求。其余条件不变,该公司公布的总吞吐量为 385.0tok/s,平均每用户吞吐量为 13.0tok/s,平均请求延迟为 453.54 秒。
5. 本地运行的代价是两台设备和网络的运维
将两台设备组合起来,可在本地运行超出单张 GPU 显存容量的模型。NVIDIA 提出的用途包括敏感数据的本地推理、智能体实验,以及无需按令牌付费的反复提示词测试。但这要求持续配备两张 GPU 和网络,并在每台 Station 上保存完整模型副本。RDMA 连接、同步和网络访问控制也都属于运维范围。
指南配置中的 API 默认无需认证,并在接收请求设备的所有网络接口上开放。因此,对外提供服务前,需要配置防火墙、认证以及用于加密通信内容的安全协议 TLS。
将 GLM-5.3 分布在两台 Station 上的配置突破了单张 GPU 的显存限制,但最佳吞吐量配置随负载变化,需要实际测量。