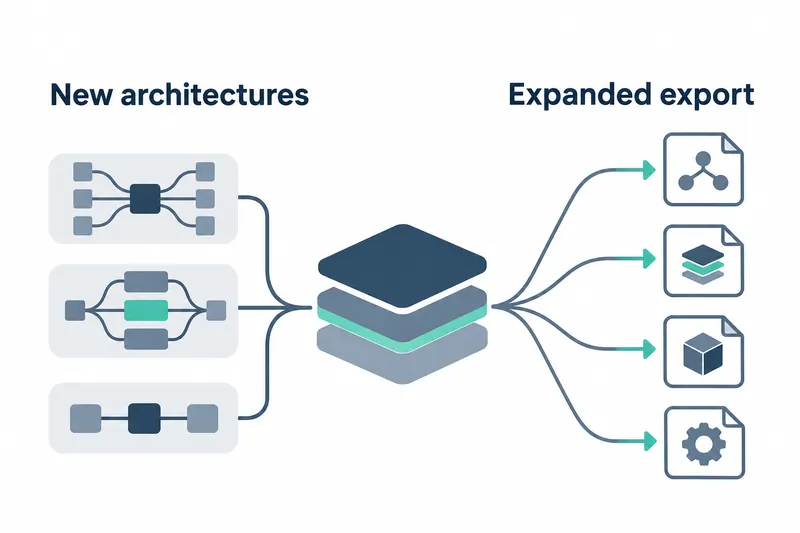
Transformers가 판단용 헤드를 포함한 일곱 모델 지원 항목을 추가하고, 여러 실행 환경으로 모델을 내보내고 다시 실행하는 절차를 하나의 방식으로 묶었다. 새 모델을 쓰려는 개발자뿐 아니라 배포 모델을 공유하고 실행하는 팀도 바뀐 경로를 활용할 수 있지만, 기존 내보내기 코드는 일부 수정이 필요하다.
1. 내보낸 모델을 공유하고 다시 실행하는 흐름이 통합됐다
새 내보내기 경로는 배포용 모델을 만드는 데서 끝나지 않고, 저장·공유·실행까지 연결한다. 결과로 받는 ExportedModel 객체는 원래 모델처럼 인자를 받고 같은 출력 클래스를 돌려준다. 개발자는 이를 허브에 올리고, 다시 내려받아 해당 실행 환경에서 사용할 수 있다.
모델과 입력을 준비한 뒤 ONNX Runtime용으로 내보내고 공유하는 원문 예시는 다음과 같다. 마지막 호출은 내보내기 전 모델을 호출하던 형태를 그대로 쓴다.
exported = OnnxExporter().export(model, inputs, OnnxConfig(dynamic=True, ort_fusions="cuda"))
exported.push_to_hub("my-org/embeddinggemma-2-onnx")

exported_model = ExportedModel.from_pretrained("my-org/embeddinggemma-2-onnx", device="cuda")
outputs = exported_model(**inputs)  # same output class as model(**inputs)
내보낸 결과는 모델 저장소의 하위 폴더에도 둘 수 있다. export.json에는 설정, 입력 형태, 패키지 버전, 입출력 이름이 기록된다. 가중치의 표현 정밀도를 낮춘 양자화 결과도 같은 방식으로 저장하고 실행할 수 있어, 공유 대상에 이런 모델도 포함된다.
2. 멀티모달·코드·판단용 모델 지원이 넓어졌다
Thinking Machines Lab의 Inkling 2 Small은 글과 이미지를 받아 글을 출력한다. 혼합 전문가 구조는 입력마다 모델의 일부 전문가만 골라 계산하는 방식이다. 이 모델의 전체 파라미터는 594B, 활성 파라미터는 17B다.
Liquid AI의 LFM3는 합성곱과 어텐션, 입력 요소 간 관련도를 계산하는 방식을 결합한 언어 모델이다. LFM3-VL은 여기에 이미지·비디오 처리 기능을 더한 모델 계열이다.
Dots 3 Note Preview는 텍스트·이미지·비디오·오디오 입력을 받는 혼합 전문가 모델이다.
판단용 헤드인 JEV도 추가됐다. 이는 프롬프트 마지막 토큰을 바탕으로 단일 토큰 라벨에 점수를 매기는 부품이다.
IQuest-Coder-V1은 코드 모델 계열이며, InternLM3은 지시에 맞게 답하도록 조정한 언어 모델이다. 둘 다 기존 라마 구현을 활용해 자동 클래스로 불러올 수 있으므로, 모델마다 별도의 실행 구현을 익히는 부담을 줄인다.
3. 실행 속도는 백엔드와 기준에 따라 달라진다
내보내기 과정에서는 여러 연산을 실행 환경에 맞는 하나의 연산으로 묶어 처리 부담을 줄인다. ONNX Runtime은 어텐션과 정규화, 값의 크기나 분포를 조정하는 처리 등에 이를 적용한다. OpenVINO도 자체 CPU 커널, 연산을 직접 수행하는 저수준 코드로 어텐션과 압축 가중치 등을 처리하며, 회사 발표 기준 출력을 이어 만드는 디코드 단계가 이전보다 2.4~3.9배 빨라졌다.
성능 예시는 모델 EmbeddingGemma2에 8 × 128 토큰을 입력한 결과다. 회사 발표 기준, A100에서 텐서알티 실행 경로를 쓴 ONNX Runtime은 파이토치 기본 실행보다 7.6배, torch.compile보다 1.4배 빨랐다.
같은 모델과 입력으로 Xeon Platinum 8570에서 실행한 OpenVINO는 회사 발표 기준 기본 실행보다 4.1배, 컴파일 실행보다 2.2배 빨랐다. 가중치를 int8로 바꾸면 각각 4.9배와 2.6배였다. 이 결과는 각 장비에서 기본 실행과 컴파일 실행 중 무엇을 쓰던 팀인지에 따라 기대할 개선 폭이 달라짐을 보여준다.
4. 반환값과 저장 방식을 새 인터페이스에 맞춘다
기존 내보내기 코드를 옮길 때는 결과를 받는 부분부터 확인해야 한다. 반환값은 ExportedModel로 바뀌며, ONNX 프로그램은 onnx_ir.Model 형식이 된다.
저장 경로를 지정하던 output_path 옵션은 없어졌고, 저장에는 save_pretrained를 쓴다.
직접 만든 실행 백엔드는 register_backend로 등록한다.
반복 구조를 쓰는 IQuest-Coder-V1 Loop 체크포인트, 학습 상태를 저장한 모델 자료는 지원 대상이 아니며, 판단용 헤드와 파이프라인은 실험 단계다. 성능 수치는 서로 다른 장비의 결과이며, 앞서 제시한 디코드 개선 범위에는 모델·입력·하드웨어 정보가 함께 제시되지 않았다.
5. 통합의 이익은 코드 변경 비용과 함께 온다
통합 경로의 이익은 내보낸 결과를 다른 개발자가 받아 같은 호출 방식으로 실행할 수 있다는 데 있다. 반면 기존 사용자는 반환 형식과 저장 코드의 전환 비용을 부담한다. 배포 대상이 여럿인 팀은 공유 흐름의 재사용 효과를, 이미 내보내기를 자동화한 팀은 변경되는 접점부터 살펴볼 만하다.
이번 버전은 선택할 모델을 늘리는 동시에 배포 결과의 재사용을 돕는 변화이며, 도입 판단의 중심은 실행 환경별 이익과 기존 코드의 전환 비용이다.