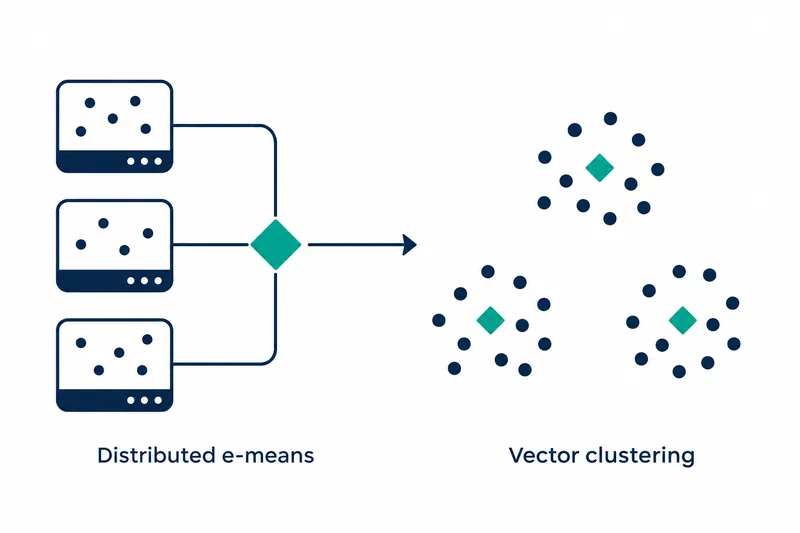
Faiss 1.16.0 为将相似向量分组的聚类新增了多设备分布式训练和训练样本上限。处理大规模数据的开发者可以选择将数据分配到多个设备训练,或仅选取随机样本以减少处理量。
1. 无需汇集数据,通过汇总信息协同训练
e-means 是一种分小批处理数据并更新聚类代表位置——质心的工具。新的分布式实现让每个进程,即独立运行的任务单元,保留全部质心,并合并各自负责的向量之和、数量等汇总信息,以更新质心并汇总整体训练误差。
用户需创建 PyTorch 分布式通信组,为各进程分配互不重叠的行。用户不再一次性传入整个数组,而是自行组织开始训练、累积数据、更新质心、结束一轮遍历及确定结果的流程。CPU 使用 Gloo,原文演示提供了在 GPU 和 CPU 上以两个进程运行的方法。
2. 通过样本上限减少读取和训练的数据
新增的 max_points_per_centroid 选项用于设定每个质心最多使用的训练行数。当总行数超过该上限与质心数量的乘积时,会依据种子,即用于复现随机选择的基准值,抽取随机样本。默认值为 None,与此前一样使用全部行训练。
批次大小,即一次成批处理的数据量,以及训练步数的计算也会按样本大小调整。对于 NumPy 输入,仅会读取选中的行,因此可在不将整个内存映射数据集载入内存的情况下训练;内存映射将文件作为内存地址访问。以下原样展示了新增样本限制的变更提案中的示例。
km = Emeans(d, k, max_points_per_centroid=256)
centroids, labels = km.train(x)   # labels[i] == -1 for rows outside the sample
返回的标签数组保留输入行数,未被采样的行填入 -1,而不是聚类编号。因此,即使缩小训练样本,结果数组与原始输入行的对应关系仍然保留。
3. 比较达到相同误差所需时间的基准测试
该版本还加入了复测 e-means 论文结果的脚本。以下为公司公布的数据:在单块 NVIDIA H100 80GB 上,e-means 达到 Flash-KMeans 迭代 25 次后的测试误差所需的训练轮数及加速倍数。一轮指完整遍历一次训练数据的量。
测试误差是预留向量与最近质心之间距离平方的平均值。两种方法针对每个数据集和种子使用相同的 GPU 与初始质心,并在预热运行后测量训练时间,不计数据加载和误差评估。
训练轮数按各个种子达到目标的时点排序,取中间两个值中较大的一个;加速倍数则取各个种子时间倍数的中位数,即按大小排序后的中间值。SPACEV 和 SimSearchNet++ 的基准实现已调整为使用 float32 计算向量长度的平方。
表:e-means 达到 Flash-KMeans 基准误差所需的训练量及加速倍数
条件:H100 80GB,PyTorch 2.14,Triton 3.8,CUTLASS DSL 4.7.1,Flash-KMeans 0.3.1·float16·迭代 25 次,种子 10~19,SPACEV·SimSearchNet++ 基准实现的平方范数(向量长度的平方)使用 float32。e-means 默认配方·CuTe 内核·bfloat16 分配,float32 输入按批转换,包含 CuTe 缓存(暂存以供复用的信息)的修复。
单位:训练轮数、倍
| 数据集 | 训练轮数 | 加速倍数 |
|---|---|---|
| DEEP* 1M | 2.0 | 12.8 |
| DINOv3/4096 1M | 2.0 | 12.7 |
| SPACEV 1M | 2.4 | 9.5 |
| SimSearchNet++ 1M | 1.4 | 12.9 |
| DEEP* 10M | 2.0 | 27.8 |
| DINOv3/4096 10M | 1.4 | 23.3 |
| SPACEV 10M | 2.0 | 19.2 |
| SimSearchNet++ 10M | 1.6 | 23.8 |
| DEEP* 100M | 2.0 | 27.0 |
| SPACEV 100M | 1.4 | 35.9 |
1M·10M·100M 分别表示 100万·1000万·1亿 行的规模。时间倍数是各数据集上基准方法的训练时间除以 e-means 的训练时间,因此值越大,表示达到相同误差越快。
据公司公布的数据,在将 SimSearchNet++ 100M 预先转换为 bfloat16 的独立输入路径上,结果为 2.6 轮、19.9倍。表格及该独立结果测量的都是在单块 GPU 上运行的聚类训练。
4. 减少数据处理的同时,增加了运维责任
样本上限减少了读取和训练的数据量,按行分布则让训练数据由多个设备分担处理。但在分布式配置中,用户需负责进程管理和数据分配,并承担质心副本之间的通信开销。由于每个设备都保留质心,选择配置时除了数据分布,还需考虑质心所占内存。
样本上限适用于接收数组的实现,在分布式及质心分片实现中指定该选项会报错。按行分布式训练要求包括最后一批在内的全局批次(所有进程共同处理的批次)以及每轮行数均能被进程数整除。表中时间包含正在单独合入的 CuTe 内核缓存修复;未包含该修复的代码,在不足一轮遍历的部分轮次中可能耗时更长,加速倍数更低。
Faiss 1.16.0 的选择重点是将训练行分配到多个设备,还是通过采样减少训练行;性能表则可视为支持这一选择的单 GPU 基准。