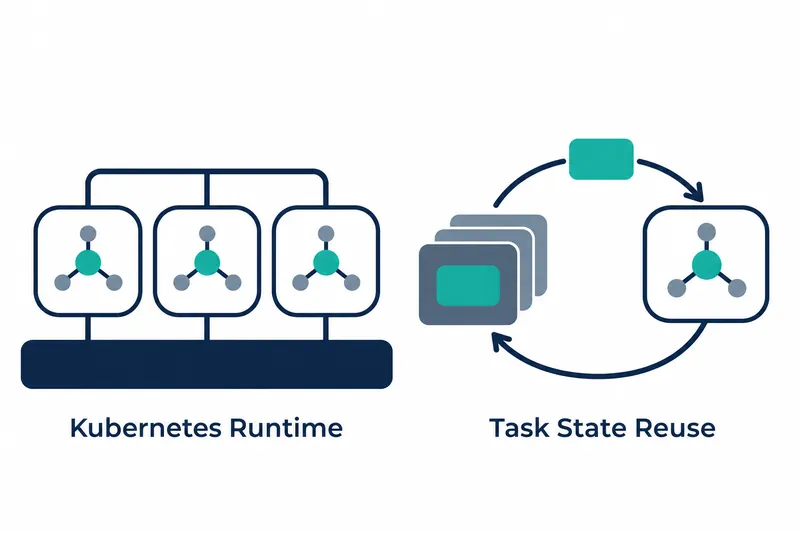
NVIDIA 发布了开源运行时 Agent Substrate,可在 Kubernetes 中快速暂停并复用智能体环境,运行时即程序的执行环境。智能体平台运营者无需持续为每个等待中的会话分配计算资源,而可保存会话状态,让多个会话共享较小的工作池,即处理任务的执行单元集合。
1. 减少为每个会话绑定工作单元的浪费
智能体执行命令或修改文件后,常常要等待模型响应或人工输入。此时,文件、进程和工作目录必须保留到下一阶段。但若为每个会话持续运行 Kubernetes 的任务执行单元 Pod,空闲时也会占用内存;若每次新建 Pod,调度以及镜像和网络准备可能耗时数秒,调度即决定在哪台计算机上运行任务。
编程辅助工具在模型调用与代码仓库操作之间切换时,需要保留环境。因此,与其为大量会话各自绑定专用执行环境,不如保存暂停任务的状态,之后继续执行。
在强化学习后训练,即对已训练模型进行追加训练的过程中,请求会成批涌向代码执行器或模拟器等以 CPU 为主的环境。NVIDIA 表示,规模可从早期实验的数百个环境增至生产阶段的数十万个。最慢的环境决定下一批训练何时就绪,因此新建环境的延迟会导致 GPU 等待。
2. 保存空闲状态,在空闲工作单元上恢复
Agent Substrate 在预备好的 Kubernetes 工作 Pod 集合之上设置独立控制层,负责资源分配与状态管理,将大量智能体环境连接到较小的工作池。沙箱是隔离的执行空间,采用 gVisor 或微型虚拟机,后者是通过虚拟化隔离的小型计算机环境。环境空闲时,系统保存内存和文件系统状态并归还工作单元。下次调用时,在空闲工作单元上从保存的状态继续执行。
恢复无需经过新建 Pod 的流程,而工作单元本身是普通 Kubernetes Pod,因此仍适用集群的调度和配额策略。根据公司公告,该运行时旨在以标准容器 10 倍的密度运行数百万个智能体和工具。
3. 处理饱和等待与沙箱内的资源争用
当所有工作单元都被占用时,系统不会立即让新请求失败,而是由路由器在一定限度内暂存请求,并在工作单元空闲后尝试恢复,这一功能已完成开发。路由器是将请求转发到合适执行目标的组件。后续改进还旨在避免面向已运行环境的请求滞留在队列中,队列即待处理请求按顺序等待的列表。
沙箱内可同时包含负责日志、代理或指标采集的辅助容器,代理即代其他服务转发请求的中介功能。在微型虚拟机沙箱中对各容器施加 CPU 和内存限制后,若某个容器超出内存上限,可仅终止该容器,让其余环境继续运行。
另有设计提案支持暂停并恢复供研究人员编译代码或执行计算的 GPU 沙箱。设备供应商若提供安全暂停方式及恢复所需的设备特性,运行时便可保存这些信息,并在符合条件的设备上恢复。NVIDIA GPU 是首个支持对象。
4. 将推理状态反馈给环境管理
Agent Substrate 管理智能体使用工具的环境,而 NVIDIA Dynamo 则协调模型推理,即已训练模型在 GPU 上生成结果的过程。Dynamo 路由器掌握 KV 缓存的位置和 GPU 工作单元的拥堵程度,KV 缓存保存此前模型调用的计算结果。它还可结合会话标识符与工具调用边界等信息,协调后续模型请求,会话标识符即区分不同会话的值。
联动的核心是将推理侧的进度信息反馈给智能体环境管理。Dynamo 可提供首个 token 的预计等待时间、请求进度、缓存就绪状态、GPU 池饱和度等信号,饱和度即可用资源被占用的程度。Agent Substrate 旨在据此决定继续保留环境、在推理长时间等待时保存环境,还是在模型即将响应时恢复环境。这一方式试图同时降低环境常开成本与反复重启的延迟。
5. 效率提升伴随着跨层协调
避免空闲会话占用工作单元并复用状态,可减少 CPU、内存浪费和各阶段重启的负担。但运营者也必须协调分别管理环境执行与推理的两个层面的信号和资源运用。在降低资源常开成本的同时,协调状态保存与恢复时机变得更加重要。
GPU 状态通常只能在相同 GPU 型号上恢复,有时甚至要求驱动版本一致,因此若无符合条件的设备,就需重新启动。NVIDIA 表示,API 仍在持续变化,GPU 支持正基于新的 Kubernetes 资源分配机制重建,与 Dynamo 的部分联动仍处于实验阶段。
Agent Substrate 是已捐赠给云原生计算基金会(CNCF)、成为其沙箱项目的独立开源项目。NVIDIA Dynamo 负责推理,KAI Scheduler 调度工作 Pod,Agent Substrate 则管理有状态的智能体环境。由于工作 Pod 是普通 Kubernetes Pod,可与 GPU 训练器或推理服务器并置。
Agent Substrate 的价值在于将任务状态保存与推理进度信息相连,把智能体的等待时间转化为轮流复用共享资源的机会。