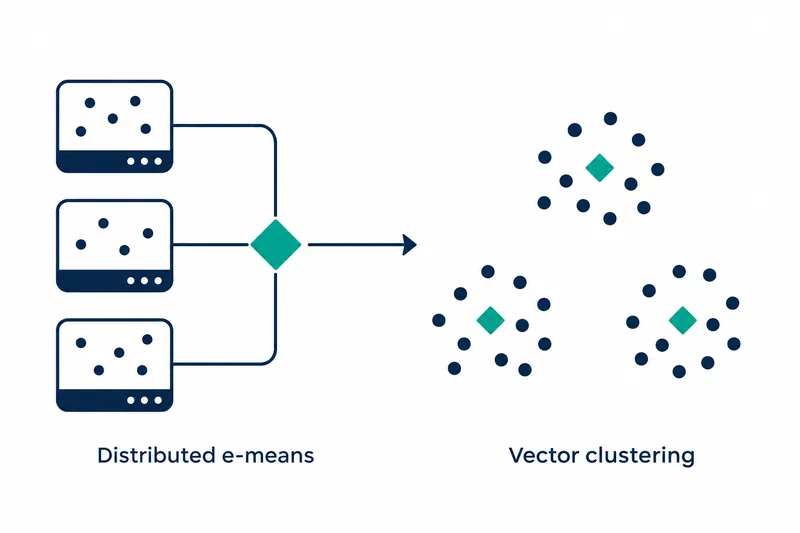
Faiss 1.16.0이 벡터를 비슷한 것끼리 묶는 군집화에 여러 장치가 나눠 수행하는 분산 학습과 학습 표본 상한을 추가했다. 대규모 데이터를 다루는 개발자는 여러 장치에 데이터를 나눠 학습하거나, 무작위 표본만 골라 처리량을 줄이는 방식을 택할 수 있다.
1. 데이터를 모으지 않고 요약 정보로 함께 학습
e-means는 데이터를 작은 묶음으로 처리하며 군집의 대표 위치인 중심점을 갱신하는 도구다. 새 분산 구현은 각 프로세스, 독립 실행되는 작업 단위가 중심점 전체를 보유한 채, 맡은 벡터의 합과 개수 등 요약 정보를 합쳐 중심점을 갱신하고 전체 학습 오차를 집계한다.
사용자는 PyTorch 분산 통신 그룹을 만들고, 각 프로세스에 서로 겹치지 않는 행을 분배한다. 전체 배열을 한 번에 넘기는 대신 학습 시작, 데이터 누적, 중심점 갱신, 한 차례 순회 종료, 결과 확정의 흐름을 직접 구성한다. CPU에서는 Gloo를 쓰며, 원문 데모는 GPU와 CPU에서 두 프로세스로 실행하는 방법을 제공한다.
2. 표본 상한으로 읽고 학습할 데이터 줄이기
새로운 max_points_per_centroid 옵션은 중심점 하나당 사용할 학습 행의 최대 수를 정한다. 전체 행 수가 상한과 중심점 수의 곱을 넘으면 시드, 무작위 선택을 재현하는 기준값에 따라 무작위 표본을 뽑는다. 기본값은 None으로, 기존처럼 전체 행을 학습한다.
배치 크기, 한 번에 묶어 처리하는 데이터 수와 학습 단계 계산도 표본 크기에 맞춰 조정된다. NumPy 입력에서는 선택된 행만 읽으므로 파일을 메모리 주소로 다루는 메모리 맵 데이터셋 전체를 메모리에 올리지 않고 학습할 수 있다. 다음은 표본 제한을 추가한 변경 제안의 예제 그대로다.
km = Emeans(d, k, max_points_per_centroid=256)
centroids, labels = km.train(x)   # labels[i] == -1 for rows outside the sample
반환 라벨 배열은 입력 행 수를 유지하며, 표본에 들지 않은 행에는 군집 번호 대신 -1이 들어간다. 따라서 학습용 표본을 줄여도 결과 배열이 원래 입력의 어느 행에 대응하는지 유지된다.
3. 같은 오차에 도달하는 시간을 비교한 벤치마크
이번 릴리스에는 e-means 논문의 결과를 다시 측정하는 스크립트도 들어갔다. 아래는 회사 발표 기준으로 NVIDIA H100 80GB 한 대에서 Flash-KMeans가 25회 반복한 뒤의 시험 오차에 e-means가 도달하는 데 필요한 에포크와 속도 향상 배수다. 에포크는 학습 데이터를 한 차례 순회하는 양이다.
시험 오차는 따로 떼어 둔 벡터와 가장 가까운 중심점 사이 거리의 제곱을 평균한 값이다. 두 방법은 데이터셋과 시드별로 같은 GPU와 초기 중심점을 사용하고, 준비 실행 뒤 데이터 적재와 오차 평가를 뺀 학습 시간을 쟀다.
에포크는 시드별 도달 시점을 정렬해 가운데 두 값 중 큰 값으로, 속도 향상은 시드별 시간 배수의 중앙값, 값을 크기순으로 놓은 가운데 값으로 요약했다. SPACEV와 SimSearchNet++의 기준 구현은 벡터 길이의 제곱을 float32로 계산하도록 조정됐다.
표: Flash-KMeans 기준 오차에 도달한 e-means의 학습량과 속도 향상
조건: H100 80GB, PyTorch 2.14, Triton 3.8, CUTLASS DSL 4.7.1, Flash-KMeans 0.3.1·float16·25회 반복, 시드 10~19, SPACEV·SimSearchNet++ 기준 구현의 제곱 노름(벡터 크기의 제곱)은 float32다. e-means 기본 레시피·CuTe 커널·bfloat16 할당, float32 입력의 배치별 변환, 재사용을 위해 임시 저장한 정보의 CuTe 캐시 수정도 포함한다.
단위: 에포크, 배
| 데이터셋 | 에포크 | 속도 향상 |
|---|---|---|
| DEEP* 1M | 2.0 | 12.8 |
| DINOv3/4096 1M | 2.0 | 12.7 |
| SPACEV 1M | 2.4 | 9.5 |
| SimSearchNet++ 1M | 1.4 | 12.9 |
| DEEP* 10M | 2.0 | 27.8 |
| DINOv3/4096 10M | 1.4 | 23.3 |
| SPACEV 10M | 2.0 | 19.2 |
| SimSearchNet++ 10M | 1.6 | 23.8 |
| DEEP* 100M | 2.0 | 27.0 |
| SPACEV 100M | 1.4 | 35.9 |
1M·10M·100M은 각각 100만·1000만·1억 행 규모다. 시간 배수는 각 데이터셋에서 기준 방법의 학습 시간을 e-means의 시간으로 나눈 값이므로, 큰 값일수록 같은 오차에 더 빨리 도달했다는 의미다.
회사 발표 기준으로 SimSearchNet++ 100M을 미리 bfloat16으로 변환한 별도 입력 경로에서는 2.6 에포크, 19.9배를 기록했다. 표와 이 별도 결과의 측정 대상은 단일 GPU에서 실행한 군집화 학습이다.
4. 데이터 처리 절감과 함께 늘어나는 운영 책임
표본 상한은 읽고 학습하는 데이터양을 줄이고, 행 분산은 학습 데이터를 여러 장치에 나눠 처리하게 한다. 대신 분산 구성에서는 사용자가 프로세스 관리와 데이터 분배를 맡고, 중심점 복제본 사이의 통신 비용도 감당한다. 중심점 자체는 장치마다 유지하므로 데이터 분산과 별도로 중심점 메모리를 고려해 구성을 선택하게 된다.
표본 상한은 배열을 받는 구현에 적용되며 분산·중심점 분할 구현에서는 지정 시 오류를 낸다. 행 분산 학습은 마지막 배치를 포함한 전역 배치, 즉 모든 프로세스가 함께 처리하는 배치와 에포크별 행 수가 프로세스 수로 나누어떨어져야 한다. 표의 시간에는 별도 반영 중인 CuTe 커널 캐시 수정이 포함돼, 수정이 없는 코드에서는 한 차례 순회 전에 끝나는 부분 에포크의 실행 시간이 늘고 속도 향상 배수가 낮아질 수 있다.
Faiss 1.16.0의 선택 기준은 학습 행을 여러 장치에 나눌지 표본으로 줄일지이며, 성능표는 그 선택을 뒷받침하는 단일 GPU 기준선으로 읽을 만하다.