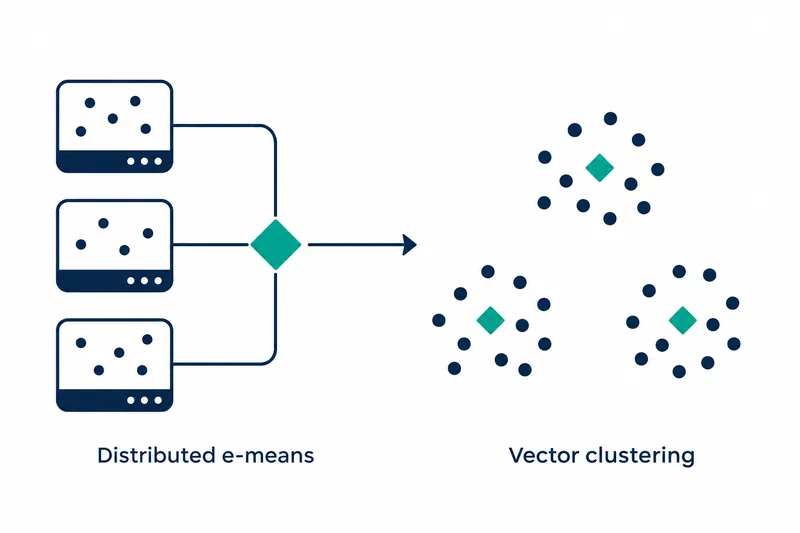
Faiss 1.16.0は、似たベクトルをまとめるクラスタリングに、複数のデバイスで分担する分散学習と学習標本の上限を追加した。大規模データを扱う開発者は、複数のデバイスにデータを分けて学習するか、無作為標本だけを選んで処理量を減らす方法を選べる。
1. データを集めずに要約情報で共同学習
e-meansはデータを小さなまとまりで処理し、クラスタの代表位置である重心を更新するツールだ。新しい分散実装では、独立して実行される作業単位である各プロセスが重心全体を保持する。担当するベクトルの和や個数などの要約情報を集約して重心を更新し、全体の学習誤差を集計する。
ユーザーはPyTorchの分散通信グループを作成し、各プロセスに互いに重複しない行を配分する。配列全体を一度に渡す代わりに、学習開始、データ蓄積、重心更新、1回の走査終了、結果確定という流れを自分で構成する。CPUではGlooを使い、原文のデモではGPUとCPUで2つのプロセスを使って実行する方法を示している。
2. 標本の上限で読み込みと学習のデータ量を削減
新しいmax_points_per_centroidオプションは、重心1つ当たりに使う学習行の最大数を定める。全行数が上限と重心数の積を超える場合、無作為選択を再現する基準値であるシードに従って無作為標本を抽出する。デフォルトはNoneで、従来どおり全行を学習する。
一度にまとめて処理するデータ数であるバッチサイズや、学習ステップの計算も標本サイズに合わせて調整される。NumPy入力では選択した行だけを読むため、ファイルをメモリアドレスとして扱うメモリマップデータセット全体をメモリに載せずに学習できる。以下は標本制限を追加した変更提案の例をそのまま示したものだ。
km = Emeans(d, k, max_points_per_centroid=256)
centroids, labels = km.train(x)   # labels[i] == -1 for rows outside the sample
返されるラベル配列は入力行数を維持し、標本に含まれない行にはクラスタ番号の代わりに-1が入る。このため、学習用の標本を減らしても、結果配列が元の入力のどの行に対応するかは維持される。
3. 同じ誤差に到達する時間を比較したベンチマーク
今回のリリースには、e-means論文の結果を再測定するスクリプトも含まれた。以下は同社の発表に基づき、NVIDIA H100 80GB 1台でFlash-KMeansが25回反復した後のテスト誤差に、e-meansが到達するまでに必要なエポック数と高速化倍率を示す。エポックとは学習データを1回走査する量だ。
テスト誤差は、別に取り分けたベクトルと最も近い重心との距離の2乗を平均した値だ。両手法はデータセットとシードごとに同じGPUと初期重心を使い、ウォームアップ後、データ読み込みと誤差評価を除いた学習時間を測定した。
エポック数はシードごとの到達時点を並べて中央の2値の大きい方とし、高速化はシードごとの時間倍率の中央値、つまり値を大きさ順に並べた中央の値で要約した。SPACEVとSimSearchNet++の基準実装は、ベクトルの長さの2乗をfloat32で計算するよう調整された。
表:Flash-KMeansの基準誤差に到達したe-meansの学習量と高速化
条件:H100 80GB、PyTorch 2.14、Triton 3.8、CUTLASS DSL 4.7.1、Flash-KMeans 0.3.1・float16・25回反復、シード10~19、SPACEV・SimSearchNet++基準実装の2乗ノルム(ベクトル長の2乗)はfloat32、e-means標準レシピ・CuTeカーネル・bfloat16割り当て、float32入力をバッチごとに変換、再利用用の一時保存情報、CuTeキャッシュの修正を含む
単位:エポック、倍
| データセット | エポック | 高速化 |
|---|---|---|
| DEEP* 1M | 2.0 | 12.8 |
| DINOv3/4096 1M | 2.0 | 12.7 |
| SPACEV 1M | 2.4 | 9.5 |
| SimSearchNet++ 1M | 1.4 | 12.9 |
| DEEP* 10M | 2.0 | 27.8 |
| DINOv3/4096 10M | 1.4 | 23.3 |
| SPACEV 10M | 2.0 | 19.2 |
| SimSearchNet++ 10M | 1.6 | 23.8 |
| DEEP* 100M | 2.0 | 27.0 |
| SPACEV 100M | 1.4 | 35.9 |
1M・10M・100Mはそれぞれ100万・1000万・1億行規模だ。時間倍率は各データセットで基準手法の学習時間をe-meansの時間で割った値なので、大きいほど同じ誤差に速く到達したことを意味する。
同社の発表によると、SimSearchNet++ 100Mを事前にbfloat16に変換した別の入力経路では、2.6エポック、19.9倍を記録した。表とこの別の結果の測定対象は、単一GPUで実行したクラスタリング学習だ。
4. データ処理の削減とともに増える運用責任
標本の上限は読み込みと学習のデータ量を減らし、行分散は学習データを複数のデバイスで分担処理できるようにする。一方、分散構成ではユーザーがプロセス管理とデータ配分を担い、重心の複製間の通信コストも負担する。重心自体は各デバイスで保持するため、データ分散とは別に重心用メモリを考慮して構成を選ぶことになる。
標本の上限は配列を受け取る実装に適用され、分散・重心分割実装で指定するとエラーになる。行分散学習では、最後のバッチを含む、全プロセスで共同処理するグローバルバッチと、エポックごとの行数がプロセス数で割り切れる必要がある。表の時間には別途反映中のCuTeカーネルキャッシュ修正が含まれる。修正のないコードでは、1回の走査前に終わる部分エポックの実行時間が増え、高速化倍率が低くなる可能性がある。
Faiss 1.16.0の選択基準は、学習行を複数のデバイスに分けるか、標本で減らすかであり、性能表はその選択を裏付ける単一GPUの基準として読むとよい。