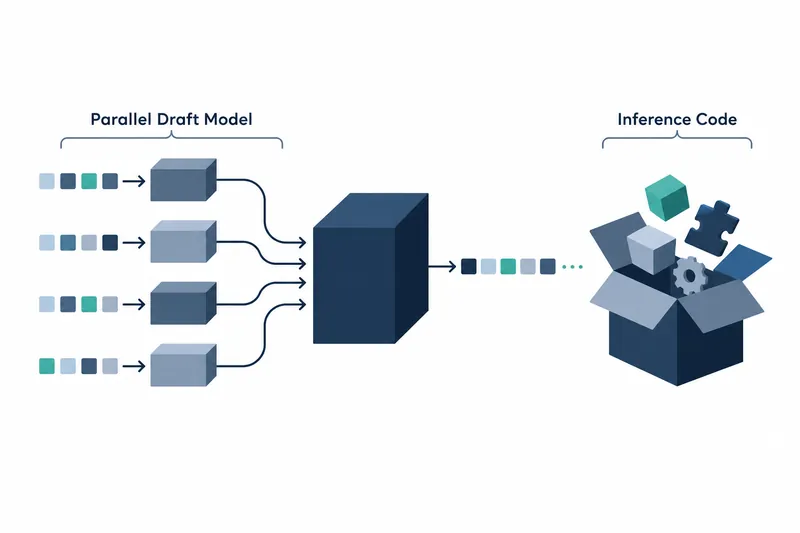
腾讯公开了在多个位置同时生成语言模型回答候选内容的辅助模型及运行代码。基于语言模型构建服务的开发者,如今可以测试先准备候选内容、再由主模型验证的方式能否加速回答生成。
1. 权重与推理代码已公开
据 GitHub 说明,DSpine 的推理代码和模型权重于 2026 年 10 月公开。论文公开时间标为同年 9 月。说明仅给出公开月份,Hugging Face 模型仓库的创建记录则为 10 月 16 日。
目前列为支持对象的主模型是 Qwen3-8B。训练代码和面向 Qwen3.8-27B 的草稿模型仍属后续计划。因此,此次公开侧重使用已发布权重进行推理,而非训练新草稿模型的流程。
模型卡和代码仓库说明均注明采用 Apache 2.0 许可证。开发者可以一并审查公开权重与运行代码。
2. 并行生成候选内容,同时反映前后关系
推测解码是由辅助模型预先提出构成回答片段的 token,再由主模型验证的方式。辅助模型并非代写完整答案,而是先准备供主模型核验的草稿。
DSpine 并行计算各位置的候选内容,同时让草稿模型的每一层接收前一个位置的预测特征。其核心是不仅沿 token 的生成顺序,还沿神经网络的层级反映前后关系。
3. 匹配服务器版本并接入公开权重
代码以推理服务器 SGLang 的插件形式发布。安装说明要求 Python 3.10 及以上版本和 CUDA 环境。以下为 GitHub 原文的安装示例。
git clone https://github.com/tencent/dspine.git
cd dspine
python -m pip install -e .
依赖版本固定为 SGLang 0.5.20。软件包配置说明其继承服务器内部实现,并在这一确切版本上开发和测试。不能认为只需给现有服务器添加配置即可,而应先确认版本兼容性。
安装后,在原文的服务器启动示例中同时指定主模型与公开的草稿权重。示例将每次提出的草稿 token 数设为 16,并使用 bfloat16 数据类型。这些值是运行示例,并未被列为各环境的最优值。
4. 区分接受长度改善与速度提升
公开结果为接受长度,即主模型从草稿中接受的长度。目标模型为 Qwen3-8B,说明指出,下文对比的三种方法均使用 Open-PerfectBlend 数据,在相同设置下重新训练。
采样温度是选择输出候选内容时调节随机性的设置。温度为 1 时,7 项任务的平均接受长度为 DSpine 6.98、DSpark 6.65。温度为 0 时,两者分别为 7.83 和 7.44。
DFlash2 在温度为 1 时的平均值为 6.53,温度为 0 时为 7.55。新方法在两种温度下的平均接受长度均高于另外两种方法,但不应对不同温度下的结果作优劣比较。
Hugging Face 说明称,服务器示例设置用于论文中的接受长度与吞吐量测量。不过,已保存的资料未给出实际吞吐量数值和测量硬件。仅凭接受长度,无法确定响应时间或每秒吞吐量改善了多少。
5. 综合考虑更长草稿的收益与额外模型的负担
预期收益在于一次验证可接受更长的草稿。但该结构需要在主模型之外加载草稿权重并进行计算,因此采用决策还应计入额外模型的存储空间、内存和计算负担。模型仓库记录显示,草稿权重的参数量为 1,237,763,840。
此次公开提供了测试并行草稿的运行途径,是否采用仍需实测更长草稿的收益能否抵消额外资源开销后再作判断。