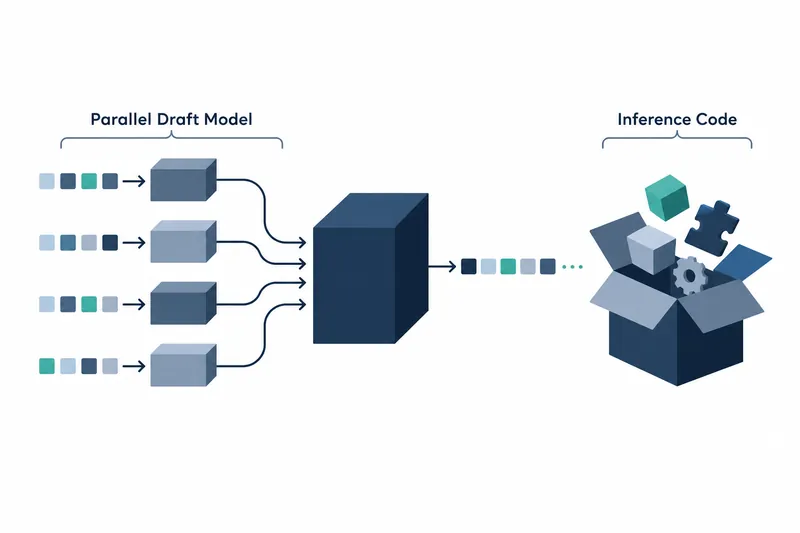
テンセントが言語モデルの回答候補を複数の位置で同時に生成する補助モデルと実行コードを公開した。言語モデルでサービスを開発する人は、候補を先に用意して本体モデルが検証する方式で回答生成を高速化できるか試せるようになった。
1. 重みと推論コードが公開された
GitHubの案内によると、DSpineの推論コードとモデルの重みは2026年10月に公開された。論文公開は同年9月と記されている。案内文は公開日を月単位でのみ示しており、Hugging Faceのモデルリポジトリ作成記録は10月16日だ。
現在、対応対象としてリンクされている本体モデルはQwen3-8Bだ。学習コードとQwen3.8-27B向けドラフトモデルは今後の計画にとどまる。したがって今回の公開は、新たなドラフトモデルの学習手順よりも、配布された重みを使う推論に重点を置いている。
モデルカードとコードリポジトリの案内にはApache 2.0ライセンスが明記されている。開発者は公開された重みと実行コードを併せて検討できる。
2. 候補を並列に生成しながら前後関係を反映する
投機的デコーディングは、補助モデルが回答の断片であるトークンを先に提案し、本体モデルがそれを検証する方式だ。補助モデルは完成した回答を代筆するのではなく、本体モデルが確認するドラフトを先に用意する役割を担う。
DSpineは各位置の候補を並列に計算しつつ、ドラフトモデルの各層で直前の位置の予測特徴を受け取るようにする。前後関係をトークンの生成順序だけでなく、ニューラルネットワークの層に沿って反映することが要点だ。
3. サーバーのバージョンを合わせて公開された重みを接続する
コードは推論サーバーSGLangのプラグインとして配布される。インストール案内ではPython 3.10以上とCUDA環境が必要とされている。以下はGitHub原文のインストール例だ。
git clone https://github.com/tencent/dspine.git
cd dspine
python -m pip install -e .
依存関係はSGLang 0.5.20に固定されている。パッケージ設定には、サーバーの内部実装を継承し、この特定のリリースで開発・テストしたと記されている。既存サーバーに設定を追加するだけで済むと考えず、まずバージョン互換性を確認する必要がある。
インストール後は、原文のサーバー起動例で本体モデルと公開されたドラフトの重みを一緒に指定する。例では、一度に提案するドラフトトークン数を16に設定し、bfloat16データ型を使っている。これらの値は実行例であり、環境ごとの最適値として示されたものではない。
4. 受理長の改善と速度向上を区別する
公開された結果は、本体モデルがドラフトから受け入れた長さを示す受理長だ。対象はQwen3-8Bで、以下で比較する3手法はいずれもOpen-PerfectBlendデータを使い、同じ設定で再学習したと明記されている。
サンプリング温度は、出力候補を選ぶ際のランダム性を調整する設定だ。温度1での7課題の平均受理長は、DSpineが6.98、DSparkが6.65だった。温度0ではそれぞれ7.83と7.44だった。
DFlash2の平均は温度1で6.53、温度0で7.55だった。新手法は両方の温度で他の2手法より平均受理長が長かったが、温度の異なる結果同士で優劣を比較してはならない。
Hugging Faceの案内では、サーバーの設定例が論文の受理長とスループット測定に使われたと説明されている。ただし、保存された資料には実際のスループット値と測定用ハードウェアが示されていない。受理長だけで応答時間や秒間スループットの改善幅を確定することはできない。
5. より長いドラフトの利点と追加モデルの負担を併せて見る
期待される利点は、1回の検証でより長いドラフトを受け入れることにある。一方、本体モデルに加えてドラフトの重みも読み込んで計算する構造のため、導入判断には追加モデルの保存領域とメモリ・計算負荷も含める必要がある。モデルリポジトリの記録では、ドラフトの重みのパラメーター数は1,237,763,840個だ。
今回の公開は並列ドラフトを試すための実行手段を提供するものであり、導入の可否は、より長いドラフトの利点が追加リソースの負担を相殺するかを実測して判断すべきだ。