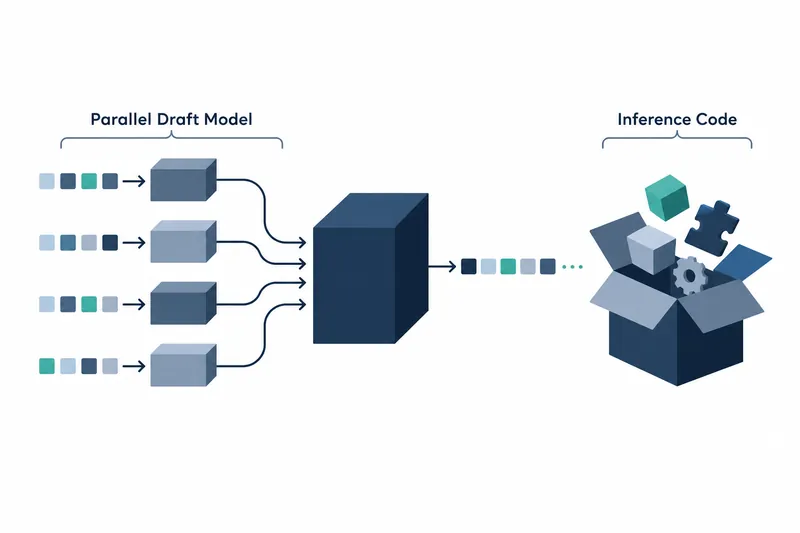
텐센트가 언어 모델의 답변 후보를 여러 위치에서 동시에 만드는 보조 모델과 실행 코드를 공개했다. 언어 모델로 서비스를 만드는 개발자는 후보를 먼저 준비하고 본 모델이 검증하는 방식으로 답변 생성을 가속할 수 있는지 시험할 수 있게 됐다.
1. 가중치와 추론 코드가 공개됐다
깃허브 안내에 따르면 DSpine의 추론 코드와 모델 가중치는 2026년 10월 공개됐다. 논문 공개는 같은 해 9월로 적혀 있다. 안내문은 공개일을 월 단위로만 제시하며, 허깅페이스의 모델 저장소 생성 기록은 10월 16일이다.
현재 지원 대상으로 연결된 본 모델은 Qwen3-8B다. 학습 코드와 Qwen3.8-27B용 초안 모델은 향후 계획으로 남아 있다. 따라서 이번 공개는 새 초안 모델을 학습하는 절차보다 배포된 가중치를 이용한 추론에 초점이 맞춰져 있다.
모델 카드와 코드 저장소 안내는 아파치 2.0 라이선스를 명시한다. 개발자는 공개된 가중치와 실행 코드를 함께 검토할 수 있다.
2. 후보를 병렬로 만들면서 앞뒤 관계를 반영한다
투기적 디코딩은 보조 모델이 답변의 조각인 토큰을 미리 제안하고, 본 모델이 이를 검증하는 방식이다. 보조 모델은 완성된 답을 대신 쓰기보다 본 모델이 확인할 초안을 먼저 준비하는 역할을 한다.
DSpine은 각 위치의 후보를 병렬로 계산하면서도, 초안 모델의 각 층에서 바로 앞 위치의 예측 특징을 전달받도록 한다. 앞뒤 관계를 토큰의 생성 순서만이 아니라 신경망의 층을 따라 반영하는 것이 핵심이다.
3. 서버 버전을 맞추고 공개 가중치를 연결한다
코드는 추론 서버인 SGLang의 플러그인으로 배포된다. 설치 안내는 파이썬 3.10 이상과 CUDA 환경을 요구한다. 아래는 깃허브 원문의 설치 예시다.
git clone https://github.com/tencent/dspine.git
cd dspine
python -m pip install -e .
의존성은 SGLang 0.5.20으로 고정돼 있다. 패키지 설정은 서버 내부 구현을 상속하며 이 정확한 릴리스에서 개발하고 시험했다고 밝힌다. 기존 서버에 설정만 더하면 된다고 보기보다 먼저 버전 호환성을 확인해야 한다.
설치 후에는 원문의 서버 실행 예시에서 본 모델과 공개된 초안 가중치를 함께 지정한다. 예시는 한 번에 제안할 초안 토큰 수를 16으로 설정하고 bfloat16 자료형을 사용한다. 이 값들은 실행 예시이지 환경별 최적값으로 제시된 것은 아니다.
4. 수용 길이의 개선을 속도 향상과 구분한다
공개 결과는 본 모델이 초안에서 받아들인 길이를 나타내는 수용 길이다. 대상은 Qwen3-8B이며, 아래에서 비교하는 세 방법은 모두 Open-PerfectBlend 데이터로 같은 설정에서 재학습했다고 명시돼 있다.
샘플링 온도는 출력 후보를 고를 때 무작위성을 조절하는 설정이다. 온도 1에서 7개 과제의 평균 수용 길이는 DSpine이 6.98, DSpark가 6.65였다. 온도 0에서는 각각 7.83과 7.44였다.
DFlash2의 평균은 온도 1에서 6.53, 온도 0에서 7.55였다. 새 방식은 두 온도 각각에서 나머지 두 방법보다 평균 수용 길이가 길었지만, 온도가 다른 결과끼리 우열을 비교해서는 안 된다.
허깅페이스 안내는 서버 예시 설정이 논문의 수용 길이와 처리량 측정에 쓰였다고 설명한다. 다만 저장된 자료에는 실제 처리량 수치와 측정 하드웨어가 제시되지 않았다. 수용 길이만으로 응답 시간이나 초당 처리량이 얼마나 개선되는지 확정할 수는 없다.
5. 더 긴 초안의 이익과 추가 모델의 부담을 함께 본다
기대 이익은 한 번의 검증에서 더 긴 초안을 받아들이는 데 있다. 반면 본 모델 외에 초안 가중치를 함께 불러와 계산하는 구조이므로, 도입 판단에는 추가 모델의 저장 공간과 메모리·연산 부담도 포함해야 한다. 모델 저장소의 기록상 초안 가중치의 매개변수 수는 1,237,763,840개다.
이번 공개는 병렬 초안을 시험할 실행 경로를 제공하며, 도입 여부는 더 긴 초안의 이익이 추가 자원 부담을 상쇄하는지 실측해 판단할 사안이다.