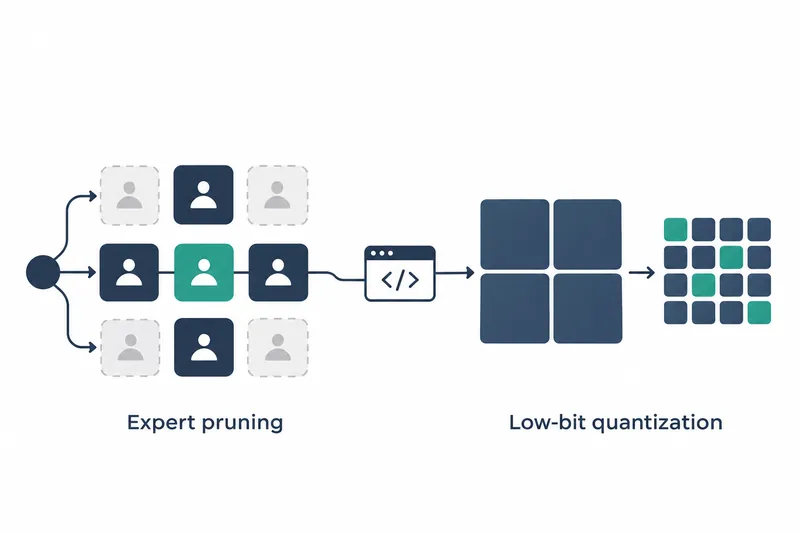
奥地利科学技术研究院的研究人员发布了一款面向编码和工具使用的压缩版大型 AI 模型,移除了部分计算模块并降低存储精度。对于希望在本地运行编码模型的开发者,它将 Transformer 的权重缩减至 72.1GB,提供了减轻文件和内存负担的选择。Transformer 是学习输入关系的神经网络结构,权重是模型学到的各连接数值。
1. 移除一半专家模块,以更小体积存储剩余权重
基础模型是拥有 7632 亿参数的混合专家模型。该结构设置了多个负责不同任务的专家模块,每次输入只选择其中一部分,每个 token 激活各层 384 个专家中的 6 个。
Coder 模型每层移除了 192 个专家。GSQ 量化降低剩余权重的存储精度,剪枝则直接移除专家模块。剩余权重保留 IQ2_XXS 构建版本中各张量的量化类型,张量是多维数值数组。模型卡给出的该版本比率为每个权重 2.00 比特。
2. 1 比特标注以原始 Transformer 大小为基准计算
模型卡中的每参数 1.05 比特,是将 72.12GB 的 Transformer 权重换算为比特,再除以原始 Transformer 的 5519 亿参数所得的有效比率。该计算将已移除的专家也计入分母,并按 0 比特计算;若只看剩余的 2801 亿参数,平均为 2.06 比特。
独立的 Engram 查找表不参与剪枝和量化搜索,以每个权重 4.50 比特存储。包含它的完整模型比率为每参数 1.92 比特。实际需要下载的文件组成如下。
表:Coder 模型的 Transformer 和查找文件容量
条件:GSQ-RCO Coder,移除一半专家,Transformer 保留 IQ2_XXS 的张量类型,Engram 使用 IQ4_NL
单位:GB(10 的 9 次方字节)
| 项目 | 容量 |
|---|---|
| Transformer 分片,即拆分为多个文件的存储片段 | 72.12 |
| Engram 查找文件 | 110.60 |
| 合计 | 182.72 |
Engram 是每个 token 读取一行的查找文件,运行时可通过内存映射将其保留在磁盘上。如果已下载剪枝前的构建版本,可以复用同一个 Engram 文件。
3. 多步骤任务的评分降幅大于单次代码生成
根据研究人员公布的结果,Coder 模型在推理强度为 50 时取得了以下评分。这些结果对比了各项评测中基础模型与压缩版的评分。
表:各编码评测中基础模型与压缩版的评分
条件:reasoning effort 50,基础模型 FP8 / FP4,Coder 模型移除一半专家并采用 IQ2_XXS 量化,Transformer 为 72.1GB
单位:评分、基础评分保留率(%)
| 项目 | 基础模型 | Coder 模型 | 保留率 |
|---|---|---|---|
| SWE-bench Verified | 81.20 | 77.00 | 94.8 |
| LiveCodeBench v6 | 89.71 | 88.57 | 98.7 |
模型卡说明,在真实代码仓库中执行多个步骤的第一项评测,其评分保留率低于单次代码生成评测。其解读是,这与连续执行多轮任务时误差累积的特性相符。
选择方法 RCO 挑选专家时,力求使输出与量化后的基准模型差异更小。为适配 GGUF 格式,各层保留相同数量的专家,但不是按单个专家的重要性排序,而是共同减少整个模型的输出差异。
4. 节省容量,专注特定能力
Transformer 从剪枝前版本的 138.2GB 缩减至 72.1GB,包含 Engram 的文件则从 248.84GB 缩减至 182.72GB。移除专家可同时减少存储空间和常驻内存占用。
在这个针对代码、工具使用、长上下文和图像处理的实验版本中,研究人员接受了其他能力下降这一压缩代价,并建议通用用途使用未剪枝的构建版本。用于调整输出误差的校准数据未涵盖的能力可能会减弱。
5. 下载文件后,链接查找文件再运行
运行需要 llama.cpp b11870 或更高版本。以下原文命令下载 Coder 分片和 Engram 文件,将查找文件链接为第六个分片,再从第一个分片启动运行。
# download the Coder and the Engram file (requires: pip install -U "huggingface_hub[cli]")
hf download ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-GGUF \
  --include "IQ2_XXS/*" "*Engram*" --local-dir .

# the Engram file is shard 6 of the Coder
ln -s ../DeepSeek-V4.1-Flash-Engram-IQ4_NL.gguf \
  IQ2_XXS/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-IQ2_XXS-00006-of-00006.gguf

llama-cli -m IQ2_XXS/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-IQ2_XXS-00001-of-00006.gguf -ngl 99
判断这个模型的实用性,不应只看 Transformer 容量小,而应看缩减后的容量能在多大程度上有效服务于编码任务。