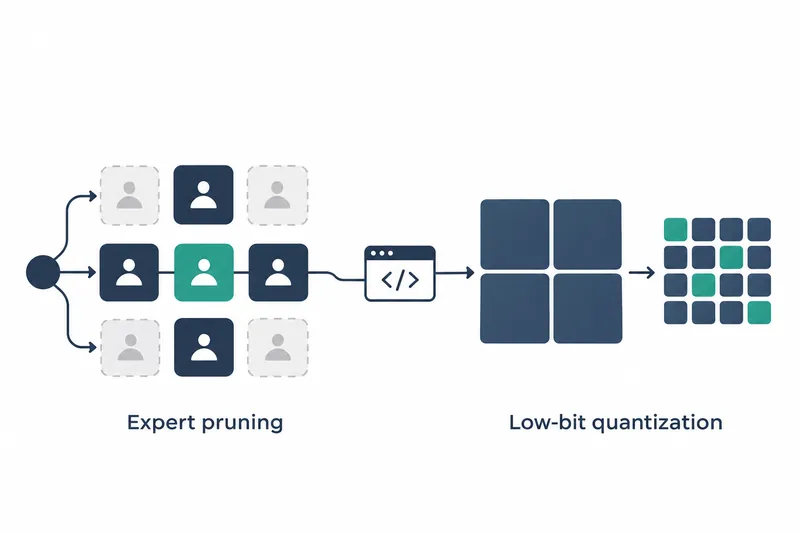
오스트리아 과학기술원 연구진이 코딩과 도구 사용에 맞춰 대형 AI 모델의 일부 연산 블록을 없애고 저장 정밀도를 낮춘 압축판을 공개했다. 로컬에서 코딩 모델을 실행하려는 개발자는 입력 관계를 학습하는 신경망 구조인 변환기의 가중치, 모델이 학습한 연결별 수치값을 72.1GB로 줄여 파일과 메모리 부담을 낮추는 선택지를 얻는다.
1. 전문가 블록을 절반 덜고 남은 값도 작게 저장
기반 모델은 7632억 파라미터의 혼합 전문가 모델이다. 여러 작업 담당 블록인 전문가를 두고 입력마다 일부만 골라 쓰는 구조로, 각 계층의 전문가 384개 중 토큰마다 6개를 활성화한다.
코더 모델은 계층마다 전문가 192개를 제거했다. GSQ 양자화는 남은 가중치의 저장 정밀도를 낮추고, 가지치기는 전문가 블록 자체를 없애는 방식이다. 남은 가중치는 IQ2_XXS 빌드의 다차원 수치 배열 자료인 텐서별 양자화 유형을 유지하며, 카드가 제시한 해당 빌드의 비율은 가중치당 2.00비트다.
2. 1비트 표기는 원본 변환기 크기를 기준으로 계산
모델 카드의 파라미터당 1.05비트는 변환기 가중치 72.12GB를 비트로 환산해 원본 변환기의 파라미터 5519억 개로 나눈 유효 비율이다. 제거한 전문가도 분모에 넣어 0비트로 세는 계산이며, 남은 2801억 파라미터만 보면 평균 2.06비트다.
별도 Engram 조회 테이블은 가지치기와 양자화 검색에서 제외하고 가중치당 4.50비트로 저장했다. 이를 포함한 전체 모델 비율은 파라미터당 1.92비트다. 실제로 받을 파일 구성은 다음과 같다.
표: 코더 모델의 변환기와 조회 파일 용량
조건: GSQ-RCO Coder, 전문가 절반 제거, 변환기는 IQ2_XXS의 텐서 유형 유지, Engram은 IQ4_NL
단위: GB(10의 9제곱 바이트)
| 항목 | 용량 |
|---|---|
| 변환기 샤드, 여러 파일로 나눈 저장 조각 | 72.12 |
| Engram 조회 파일 | 110.60 |
| 합계 | 182.72 |
Engram은 토큰마다 한 행씩 읽는 조회 파일로, 실행 중에는 메모리 매핑으로 디스크에 둘 수 있다. 이미 가지치기 전 빌드를 받았다면 같은 Engram 파일을 재사용할 수 있다.
3. 단일 코드 생성보다 여러 단계 작업에서 점수 감소
연구진 발표 기준, 추론 강도 50에서 코더 모델은 아래와 같은 점수를 기록했다. 각 평가에서 기본 모델과 압축판의 점수를 비교한 결과다.
표: 코딩 평가별 기본 모델과 압축판 점수
조건: reasoning effort 50, 기본 모델 FP8 / FP4, 코더 모델은 전문가 절반 제거와 IQ2_XXS 양자화, 변환기 72.1GB
단위: 점수, 기본 점수 유지율(%)
| 항목 | 기본 모델 | 코더 모델 | 유지율 |
|---|---|---|---|
| SWE-bench Verified | 81.20 | 77.00 | 94.8 |
| LiveCodeBench v6 | 89.71 | 88.57 | 98.7 |
카드는 실제 저장소에서 여러 단계를 수행하는 첫 평가의 유지율이 단일 코드 생성 평가보다 낮았다고 설명한다. 여러 차례 작업을 이어갈 때 오차가 누적되는 특성과 맞아떨어진다는 해석이다.
선택 기법인 RCO는 양자화된 기준 모델과 출력이 덜 달라지도록 전문가를 고른다. GGUF 형식에 맞춰 계층마다 같은 수를 남기되, 개별 중요도 순위가 아니라 전체 모델의 출력 차이를 함께 줄인다.
4. 용량을 아끼는 대신 특정 능력에 집중
변환기는 가지치기 전 빌드의 138.2GB에서 72.1GB로, Engram을 합친 파일은 248.84GB에서 182.72GB로 줄었다. 전문가 제거는 저장 공간과 상주 메모리를 함께 줄인다.
연구진은 코드·도구 사용·긴 문맥·이미지 처리에 맞춘 실험 릴리스에서 그 밖의 능력 저하를 압축의 대가로 받아들였으며, 범용 용도에는 가지치기하지 않은 빌드를 권한다. 출력 오차를 조정하는 데 쓰는 보정 데이터에 포함되지 않은 능력은 약해질 수 있다.
5. 파일을 받은 뒤 조회 파일을 연결해 실행
실행에는 llama.cpp b11870 이상이 필요하다. 아래 원문 명령은 코더 샤드와 Engram 파일을 받고, 조회 파일을 여섯 번째 샤드로 연결한 뒤 첫 샤드에서 실행을 시작한다.
# download the Coder and the Engram file (requires: pip install -U "huggingface_hub[cli]")
hf download ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-GGUF \
  --include "IQ2_XXS/*" "*Engram*" --local-dir .

# the Engram file is shard 6 of the Coder
ln -s ../DeepSeek-V4.1-Flash-Engram-IQ4_NL.gguf \
  IQ2_XXS/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-IQ2_XXS-00006-of-00006.gguf

llama-cli -m IQ2_XXS/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-IQ2_XXS-00001-of-00006.gguf -ngl 99
이 모델의 실용성은 작은 변환기 용량 자체보다, 줄어든 용량을 코딩 작업에 얼마나 잘 집중했는지로 판단해야 한다.