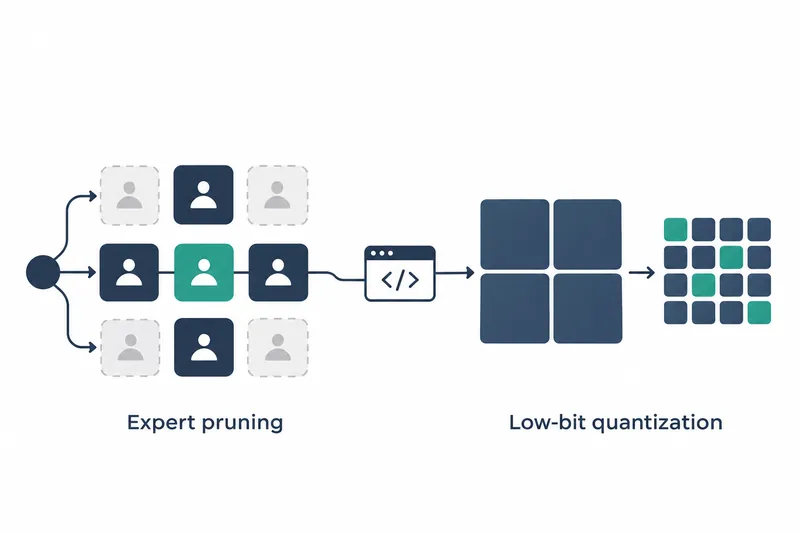
オーストリア科学技術研究所の研究陣が、コーディングとツール使用に合わせ、大規模AIモデルの一部の演算ブロックを削除し、保存精度を下げた圧縮版を公開した。ローカルでコーディングモデルを実行する開発者には、入力の関係を学ぶニューラルネットワーク構造であるTransformerの重み、つまりモデルが学習した接続ごとの数値を72.1GBに減らし、ファイルとメモリの負担を軽くする選択肢となる。
1. エキスパートブロックを半分減らし、残りの値も小さく保存
ベースモデルは7632億パラメータの混合エキスパートモデルだ。複数の作業担当ブロックであるエキスパートを備え、入力ごとに一部だけを選んで使う構造で、各層の384個のエキスパートのうち、トークンごとに6個を有効にする。
Coderモデルは各層で192個のエキスパートを削除した。GSQ量子化は残った重みの保存精度を下げ、枝刈りはエキスパートブロック自体を取り除く方式だ。残った重みは、IQ2_XXSビルドの多次元数値配列であるテンソルごとの量子化タイプを維持する。モデルカードが示す同ビルドの比率は、重み当たり2.00ビットだ。
2. 1ビット表記は元のTransformerの規模を基準に計算
モデルカードのパラメータ当たり1.05ビットは、Transformerの重み72.12GBをビットに換算し、元のTransformerの5519億個のパラメータで割った実効比率だ。削除したエキスパートも分母に含めて0ビットと数える計算で、残った2801億パラメータだけを見ると平均2.06ビットとなる。
別途用意されたEngram参照テーブルは枝刈りと量子化の探索から除外し、重み当たり4.50ビットで保存した。これを含むモデル全体の比率はパラメータ当たり1.92ビットだ。実際にダウンロードするファイルの構成は次のとおり。
表:CoderモデルのTransformerと参照ファイルの容量
条件:GSQ-RCO Coder、エキスパートを半分削除、TransformerはIQ2_XXSのテンソルタイプを維持、EngramはIQ4_NL
単位:GB(10の9乗バイト)
| 項目 | 容量 |
|---|---|
| Transformerシャード、複数ファイルに分割した保存断片 | 72.12 |
| Engram参照ファイル | 110.60 |
| 合計 | 182.72 |
Engramはトークンごとに1行ずつ読み出す参照ファイルで、実行中はメモリマッピングによりディスクに置ける。すでに枝刈り前のビルドをダウンロードしていれば、同じEngramファイルを再利用できる。
3. 単一のコード生成より複数段階の作業でスコアが低下
研究陣の発表によると、推論強度50でCoderモデルは以下のスコアを記録した。各評価でベースモデルと圧縮版のスコアを比較した結果だ。
表:コーディング評価別のベースモデルと圧縮版のスコア
条件:reasoning effort 50、ベースモデルはFP8 / FP4、Coderモデルはエキスパートを半分削除しIQ2_XXS量子化、Transformerは72.1GB
単位:スコア、ベースモデルのスコア維持率(%)
| 項目 | ベースモデル | Coderモデル | 維持率 |
|---|---|---|---|
| SWE-bench Verified | 81.20 | 77.00 | 94.8 |
| LiveCodeBench v6 | 89.71 | 88.57 | 98.7 |
モデルカードは、実際のリポジトリで複数の段階を実行する最初の評価の維持率が、単一のコード生成評価より低かったと説明する。作業を何度も続ける際に誤差が蓄積する特性と整合するという解釈だ。
選択手法のRCOは、量子化した基準モデルとの出力の違いが小さくなるようにエキスパートを選ぶ。GGUF形式に合わせて各層で同じ数を残すが、個別の重要度順位ではなく、モデル全体の出力差をまとめて減らす。
4. 容量を節約する代わりに特定の能力に集中
Transformerは枝刈り前のビルドの138.2GBから72.1GBへ、Engramを含むファイルは248.84GBから182.72GBへ縮小した。エキスパートの削除は、ストレージ容量と常駐メモリをともに減らす。
研究陣は、コード・ツール使用・長いコンテキスト・画像処理に合わせた実験的リリースで、それ以外の能力の低下を圧縮の代償として受け入れた。汎用用途には枝刈りしていないビルドを勧める。出力誤差の調整に使う較正データに含まれない能力は、弱まる可能性がある。
5. ファイルの取得後に参照ファイルをリンクして実行
実行にはllama.cpp b11870以降が必要だ。以下の原文のコマンドはCoderシャードとEngramファイルを取得し、参照ファイルを6番目のシャードとしてリンクした後、最初のシャードから実行を開始する。
# download the Coder and the Engram file (requires: pip install -U "huggingface_hub[cli]")
hf download ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-GGUF \
  --include "IQ2_XXS/*" "*Engram*" --local-dir .

# the Engram file is shard 6 of the Coder
ln -s ../DeepSeek-V4.1-Flash-Engram-IQ4_NL.gguf \
  IQ2_XXS/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-IQ2_XXS-00006-of-00006.gguf

llama-cli -m IQ2_XXS/DeepSeek-V4.1-Flash-1017-GSQ-RCO-Coder-IQ2_XXS-00001-of-00006.gguf -ngl 99
このモデルの実用性は、Transformerの容量の小ささ自体よりも、削減後の容量をコーディング作業にどれだけうまく集中させたかで判断すべきだ。