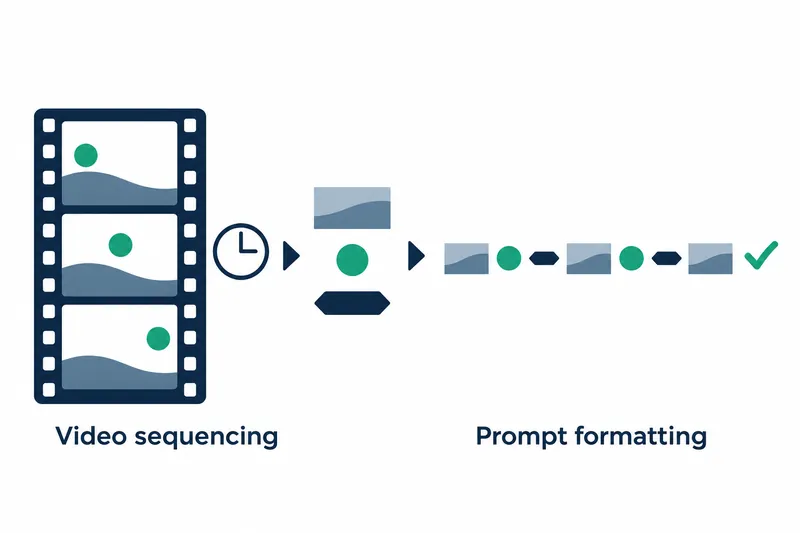
llama.cpp 完善了向视频理解模型传递场景和时间信息的方式。开发本地视频问答功能的开发者,可以按模型预期的顺序和尺寸组织视频输入。
1. 自动选择适配模型的视频输入
2026 年 11 月 4 日发布的 b12098 支持 Qwen3-VL 的视频提示格式。本次发布修改了向模型传递视频采样帧及时间标记的部分。
这一变更应用于处理视频、音频等多种输入格式的 mtmd 模块。识别出 Qwen3-VL 模型后,模块会选择对应的视频处理配置,帧选取规则和时间标记均遵循该配置。开发者无需手动拼装格式,而是交由各模型的处理路径完成。
2. 在帧之间放置时间信息
视频以每组两帧的形式传入,并在每组之前放置时间标记。这类似于在两张照片前附上拍摄时间,先告知该组的中间时刻。下方测试标记中的方括号数字表示原始视频的帧编号。
PR 测试设置了固定输入,用于与 transformers 4.57.1 的 Qwen3VLProcessor 生成的结果进行比较。以下代码是该测试预期字符串的一部分,指定了输入帧尺寸以及时间与帧的顺序。
        { {  720, 358, 24.0f, 240 }, { 704, 352 },
            "<0.3 seconds>[0][13]<1.3 seconds>[25][38]<2.4 seconds>[50][63]<3.4 seconds>[75][88]<4.5 seconds>[101][113]"
            "<5.5 seconds>[126][138]<6.6 seconds>[151][164]<7.6 seconds>[176][189]<8.6 seconds>[201][214]<9.7 seconds>[226][239]" },
3. 从整个视频中选取帧的规则
配置以每秒 2 帧为基准,根据视频时长计算选取数量。Qwen3-VL 视频处理将其限制在 4~768 帧范围内,但若原始帧数更少,则最多只选取实际原始帧数。因此,每秒采样基准和总选取数量上限共同决定输入规模。
确定选取数量后,便从原始视频的第一帧到最后一帧均匀分配帧编号。长视频达到上限时,相同数量的帧会分摊代表更长的时间段。这不是简单截取视频开头,而是从整个时段中筛选场景。
4. 根据帧数调整画面尺寸
帧尺寸采用与参考处理器相同的方式计算,后者是生成基准输入的程序。宽高会对齐模型处理的网格间距,并根据计入帧数的像素限额进行放大或缩小。测试在 patch_size 16 和 n_merge 2 的共同配置下,检查各输入对应的预期尺寸。
下表是在同一尺寸调整规则下使用不同输入的测试案例。宽高以像素为单位,帧数为传给尺寸计算的值。
表:共同尺寸调整规则下各输入的预期值
条件:patch_size 16、n_merge 2,以 Qwen3VLVideoProcessor smart_resize 为基准,像素下限 4096、上限 25165824,时间维度分组大小为 2
单位:帧数为帧,宽高为像素
| 案例 | 帧数 | 原始宽度 | 原始高度 | 计算宽度 | 计算高度 |
|---|---|---|---|---|---|
| 基本取整 | 20 | 720 | 358 | 704 | 352 |
| 超过上限 | 768 | 1920 | 1080 | 224 | 128 |
| 放大短边 | 4 | 16 | 40 | 32 | 64 |
| 低于下限 | 2 | 32 | 32 | 64 | 64 |
| 奇数分组取整 | 5 | 2760 | 1552 | 2752 | 1536 |
| 长纵向输入 | 4 | 250 | 6000 | 256 | 6016 |
测试注释包含短边小于网格间距时先放大、超过像素限额时缩小的案例。在输入较多帧的案例中,可以看出其通过降低每帧分辨率来控制整体输入规模的设计。
5. 参考格式对齐与视频信息量之间的权衡
此次变更的优势在于将时间标记、帧排列和画面尺寸与 Qwen3-VL 的参考处理方式对齐。代价是需要筛选帧并调整画面尺寸,因此长视频的场景选取间隔会变大,细节也会受像素限额影响而减少。
实现基于现有 LFM3 视频处理结构进行了整理,使输入顺序能在测试中复现。新增的验证组件被标记为内部使用,并非供应用程序直接调用。
表格和代码中的数值用于核对参考处理器的预期值,并非模型回答质量或处理速度的测量结果。
b12098 的核心是建立一条输入路径,将 Qwen3-VL 视频的帧和时间信息与参考格式对齐。