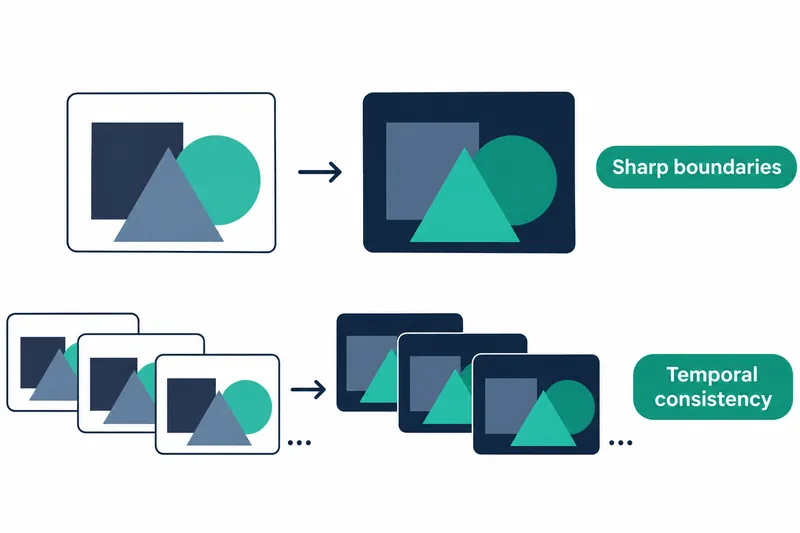
Apple 发布了从单张照片或普通相机视频中,以米为单位预测物体深度的模型。照片和视频编辑开发者可用它保留毛发般纤细的边界,同时减少视频中物体估计距离逐帧波动的现象。
1. 用一个模型处理照片和视频
单图深度模型能清晰捕捉各帧的边界,但距离可能逐帧变化。相反,参考多帧的视频模型能稳定深度变化,却往往会平滑边界细节。论文将这种权衡列为现有深度估计的难题。
Depth Pro 2 经过训练,可处理单张照片,也可同时处理最多 32 帧。其结构保留原始分辨率以呈现细节,并通过多帧信息共享稳定同一物体的深度。它先分析各帧内部的信息,再交替参考帧内和帧间信息,最终为每帧重建深度图,即逐像素记录距离的图像。
2. 用焦距校准深度的米制尺度
将深度换算为米时,可使用照片中记录的焦距,即镜头汇聚光线的光学距离值,也可通过单独的估计器获取。视频则取多帧估计值的中位数,共用一个焦距。就像校准尺子的刻度一样,焦距决定了预测深度的尺度。
根据公司公布的数据,在六个评测数据集上,焦距相对误差低于 25% 的照片比例的平均值如下。
表:焦距估计准确率
条件:论文表 6,未用于训练的六个数据集,焦距相对误差低于 25% 的比例的平均值
单位:%
| 模型 | 平均准确率 |
|---|---|
| Depth Pro 2 | 88.6 |
| Depth Pro | 71.7 |
| UniK3D-L | 57.8 |
在相同评测中,该模型的比例高于既有模型。这对缺少焦距信息的照片和视频的米制深度估计是一项重要改进。
3. 视频边界与时间稳定性评测
根据公司公布的数据,以下是在未用于训练的数据上的视频评测结果。边界 F1 表示识别真实物体边界的能力,越高越好;抖动表示跟踪同一点时深度波动的程度,越低越稳定。
表:视频边界清晰度与时间稳定性
条件:论文表 4(b)·5,50 帧片段,各模型官方推理分辨率,单图模型逐帧处理;逆深度尺度与基准点对齐在 F1 评测中逐帧进行,在抖动评测中每段视频进行 1 次,抖动评测跟踪未被遮挡的真值点
单位:F1 分数,抖动为原始值的 100 倍
| 模型 | Sintel F1 | Spring F1 | DyDToF F1 | Sintel 抖动 | Spring 抖动 |
|---|---|---|---|---|---|
| Depth Pro 2-H+ | 43.4 | 16.8 | 34.4 | 1.39 | 0.86 |
| InfiniDepth | 44.8 | 11.8 | 30.5 | 7.66 | 9.48 |
| Depth Pro | 36.3 | 12.7 | 24.8 | 11.26 | 8.99 |
| π3 | 11.6 | 4.2 | 6.8 | 2.13 | 1.04 |
| DepthCrafter | 24.8 | 7.7 | 15.9 | 2.09 | 1.07 |
| VGGT-Ω-1B | 10.8 | 4.9 | 7.5 | 2.36 | 0.99 |
在相同视频条件下,H+ 在三个数据集上的边界分数均高于既有 Depth Pro,且在两个数据集上的抖动更低。
InfiniDepth 在 Sintel 的边界分数上领先,但深度波动更大。这体现了仅边界清晰的结果与适合整段视频使用的结果之间的区别。
4. 选择视频长度与处理方式
视频文件默认每组处理 16 帧,与下一组重叠 4 帧,以缓解组间深度变化。根据公司公布的数据,H+ 在此设置下处理 720p DynamicReplica 的 300 帧视频,抖动为 0.291。
在单张 B200 上使用合成 720p 输入时,处理速度为每秒 21.7 帧,峰值预留内存为 10.0GiB,即运行器事先保留的内存空间。测量时提供焦距以排除估计器,并采用 PyTorch 即时执行,即调用运算后立即执行。
精度采用 bf16 自动混合精度,即根据运算采用不同精度,深度输出部分则使用 fp32 计算。数值为各设置运行三次的中位数。
对于相机输入,还提供每帧到达即输出结果的方式。它将过去帧的计算结果放入缓存,即用于复用的临时存储空间,供当前帧参考,从而减少等待未来帧的时间。
5. 性能优势与资源成本
高分辨率输入与时间信息可同时提升细节和稳定性,但提高分辨率及一次参考的帧数,也会增加内存与计算负担。根据公司公布的数据,在相同 1080p 片段上,小模型运行更快,大模型则占用更多内存。
表:不同模型大小的视频处理资源
条件:论文表 13,单张 B200,Spring 1920×1080 视频的 32 帧批量处理,PyTorch 即时执行·bf16 自动混合精度,包含焦距估计
| 模型 | 吞吐量(帧/秒) | 峰值预留内存(GiB) |
|---|---|---|
| Depth Pro 2-S | 44.8 | 8.0 |
| Depth Pro 2-B | 23.6 | 14.0 |
| Depth Pro 2-L | 9.1 | 21.7 |
| Depth Pro 2-H+ | 5.3 | 29.5 |
该测量是包含焦距估计的批量处理结果。开发者可根据目标分辨率下所需的处理速度与内存选择模型大小。
6. 用公开代码从照片开始测试
代码仓库中的照片处理示例如下。加载照片并输入模型后,即可获得每个像素以米为单位的深度。
import av
from depth_pro_2 import create_model_and_transforms, load_rgb, upright

model, transform = create_model_and_transforms("depthpro2-h")  # on the GPU if there is one

# A photo. f_px is the focal length recorded in the photo, or None.
image, f_px = load_rgb("assets/example.jpg")
depth = model.infer(transform(image), f_px=f_px)["depth"]  # meters, shape (height, width)
代码仓库提供推理代码,不含训练与评估代码,权重仅限非营利科学研究与学术开发使用。即时处理的视频开头可参考的历史帧较少,因此稳定性相对较低。
Depth Pro 2 的价值在于同时确保边界和帧间稳定性,采用何种模型大小,应根据目标视频的处理速度与内存预算来决定。