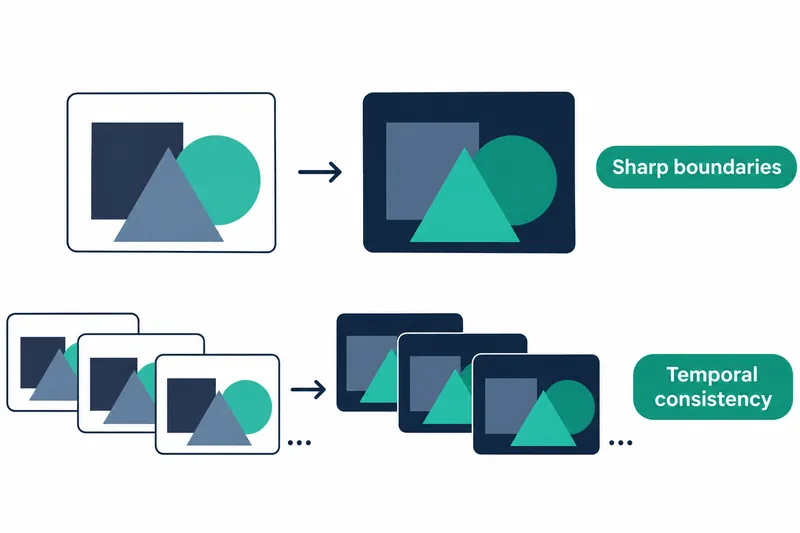
애플이 사진 한 장이나 일반 카메라 영상에서 물체까지의 깊이를 미터 단위로 예측하는 모델을 공개했다. 사진·영상 편집 개발자는 털처럼 가는 경계를 살리면서도 영상 속 물체의 추정 거리가 프레임마다 흔들리는 현상을 줄이는 데 활용할 수 있다.
1. 사진과 영상을 한 모델로 처리
단일 이미지 깊이 모델은 개별 프레임의 경계를 선명하게 잡는 대신 프레임마다 거리가 달라질 수 있다. 반대로 여러 프레임을 보는 영상 모델은 깊이 변화가 안정적이지만 세부 경계를 부드럽게 만드는 경향이 있다. 논문은 이 상충을 기존 깊이 추정의 과제로 제시한다.
Depth Pro 2는 사진 한 장부터 최대 32프레임까지 함께 처리하도록 학습했다. 원본 해상도를 유지해 세부를 살리고, 여러 프레임의 정보를 공유해 같은 물체의 깊이를 안정시키는 구조다. 각 프레임 안의 정보를 먼저 분석한 뒤 프레임 안팎을 번갈아 참조하고, 프레임마다 깊이 지도, 화소마다 거리를 담은 그림을 복원한다.
2. 초점거리로 깊이의 미터 기준을 맞춘다
깊이를 미터로 환산할 때는 사진에 기록된 초점거리, 렌즈가 빛을 모으는 광학적 거리값을 쓰거나 별도 추정기로 값을 구한다. 영상은 여러 프레임의 추정값에서 중앙값을 택해 하나의 초점거리를 공유한다. 자로 잰 거리의 눈금을 맞추듯, 초점거리가 예측한 깊이의 크기를 정하는 셈이다.
회사 발표 기준, 초점거리 상대 오차가 25% 미만인 사진 비율을 여섯 평가 자료에서 평균한 결과는 다음과 같다.
표: 초점거리 추정 정확도
조건: 논문 표 6, 학습에 쓰지 않은 여섯 데이터셋, 초점거리 상대 오차 25% 미만 비율의 평균
단위: %
| 모델 | 평균 정확도 |
|---|---|
| Depth Pro 2 | 88.6 |
| Depth Pro | 71.7 |
| UniK3D-L | 57.8 |
같은 평가에서 기존 모델보다 높은 비율을 기록했다. 초점거리 정보가 없는 사진과 영상의 미터 단위 깊이 추정에 중요한 개선이다.
3. 영상 경계와 시간 안정성 평가
회사 발표 기준, 아래는 학습에 쓰지 않은 자료의 영상 평가 결과다. 경계 F1은 실제 물체 경계를 얼마나 잘 찾아냈는지 나타내며 높을수록 좋고, 지터는 같은 지점을 따라갈 때 깊이가 흔들리는 정도로 낮을수록 안정적이다.
표: 영상의 경계 선명도와 시간 안정성
조건: 논문 표 4(b)·5, 50프레임 클립, 모델별 공식 추론 해상도, 단일 이미지 모델은 프레임별 처리; 역깊이 크기·기준점 정렬은 F1은 프레임별, 지터는 영상별 1회, 지터는 가려지지 않은 정답 지점 추적
단위: F1 점수, 지터는 원래 값의 100배
| 모델 | Sintel F1 | Spring F1 | DyDToF F1 | Sintel 지터 | Spring 지터 |
|---|---|---|---|---|---|
| Depth Pro 2-H+ | 43.4 | 16.8 | 34.4 | 1.39 | 0.86 |
| InfiniDepth | 44.8 | 11.8 | 30.5 | 7.66 | 9.48 |
| Depth Pro | 36.3 | 12.7 | 24.8 | 11.26 | 8.99 |
| π3 | 11.6 | 4.2 | 6.8 | 2.13 | 1.04 |
| DepthCrafter | 24.8 | 7.7 | 15.9 | 2.09 | 1.07 |
| VGGT-Ω-1B | 10.8 | 4.9 | 7.5 | 2.36 | 0.99 |
같은 영상 조건에서 H+는 기존 Depth Pro보다 세 자료의 경계 점수가 높고 두 자료의 지터가 낮았다.
InfiniDepth는 Sintel의 경계 점수에서 앞섰지만 깊이 흔들림은 더 컸다. 경계만 선명한 결과와 영상 전체에서 쓰기 좋은 결과의 차이를 보여 준다.
4. 영상 길이와 처리 방식 선택
영상 파일은 기본적으로 16프레임을 묶고 다음 묶음과 4프레임을 겹쳐 처리해 묶음 사이의 깊이 변화를 완화한다. 회사 발표 기준, H+는 이 설정으로 720p DynamicReplica 300프레임 영상에서 지터 0.291을 기록했다.
속도·메모리는 B200 한 장의 합성 720p 입력에서 초당 21.7프레임, 최대 예약 메모리, 실행기가 확보해 둔 메모리 공간인 10.0GiB였다. 초점거리를 제공해 추정기를 제외하고 PyTorch 즉시 실행, 연산을 호출하자마자 수행하는 방식으로 측정했다.
정밀도는 bf16 자동 혼합 정밀도, 계산별로 정밀도를 달리 적용하는 방식이며 깊이 출력부는 fp32로 계산했다. 수치는 설정별 세 차례 실행의 중앙값이다.
카메라 입력에는 프레임이 도착할 때마다 결과를 내는 방식도 제공한다. 과거 프레임의 계산 결과를 캐시, 다시 쓰도록 임시 저장한 공간에 두고 현재 프레임이 참조하게 해, 미래 프레임을 기다리는 시간을 줄인다.
5. 성능의 이점과 자원 비용
고해상도 입력과 시간 정보는 세부와 안정성을 함께 높이지만, 해상도와 한 번에 참조할 프레임 수를 늘리면 메모리·연산 부담도 커진다. 회사 발표 기준, 같은 1080p 클립에서 작은 모델은 빠르게, 큰 모델은 더 많은 메모리를 쓰며 동작했다.
표: 모델 크기별 영상 처리 자원
조건: 논문 표 13, B200 한 장, Spring 1920×1080 영상 32프레임 일괄 처리, PyTorch 즉시 실행·bf16 자동 혼합 정밀도, 초점거리 추정 포함
| 모델 | 처리량(초당 프레임) | 최대 예약 메모리(GiB) |
|---|---|---|
| Depth Pro 2-S | 44.8 | 8.0 |
| Depth Pro 2-B | 23.6 | 14.0 |
| Depth Pro 2-L | 9.1 | 21.7 |
| Depth Pro 2-H+ | 5.3 | 29.5 |
이 측정은 초점거리 추정까지 포함한 일괄 처리 결과다. 개발자는 목표 해상도에서 필요한 처리 속도와 메모리에 맞춰 크기를 고를 수 있다.
6. 공개 코드로 사진부터 시험한다
저장소의 사진 처리 예시는 다음과 같다. 사진을 불러와 모델에 넣으면 각 화소의 깊이를 미터 단위로 얻는다.
import av
from depth_pro_2 import create_model_and_transforms, load_rgb, upright

model, transform = create_model_and_transforms("depthpro2-h")  # on the GPU if there is one

# A photo. f_px is the focal length recorded in the photo, or None.
image, f_px = load_rgb("assets/example.jpg")
depth = model.infer(transform(image), f_px=f_px)["depth"]  # meters, shape (height, width)
저장소는 학습·평가 코드 없이 추론 코드를 제공하며, 가중치 이용은 비영리 과학 연구와 학술 개발로 제한된다. 즉시 처리하는 영상의 첫 부분은 참고할 과거 프레임이 적어 상대적으로 안정성이 낮다.
Depth Pro 2의 가치는 경계와 프레임 안정성을 함께 확보하는 데 있으며, 도입할 모델 크기는 목표 영상의 처리 속도와 메모리 예산으로 결정하는 편이 합리적이다.