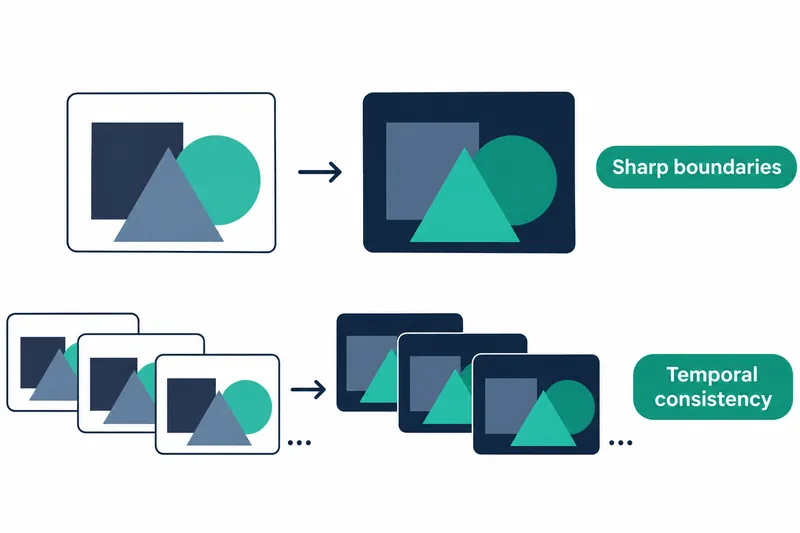
Appleは、写真1枚や一般的なカメラの動画から物体までの深度をメートル単位で予測するモデルを公開した。写真・動画編集の開発者は、毛のように細い境界を保ちながら、動画内の物体の推定距離がフレームごとに揺れる現象を減らすために活用できる。
1. 写真と動画を1つのモデルで処理
単一画像の深度モデルは、個々のフレームの境界を鮮明に捉える一方、フレームごとに距離が変わることがある。逆に、複数フレームを見る動画モデルは深度の変化が安定するが、細かな境界を滑らかにする傾向がある。論文はこのトレードオフを従来の深度推定の課題として示す。
Depth Pro 2は、写真1枚から最大32フレームまでをまとめて処理するように学習した。元の解像度を維持して細部を残し、複数フレームの情報を共有して同じ物体の深度を安定させる構造だ。各フレーム内の情報を先に解析し、フレーム内外を交互に参照して、画素ごとの距離を表す深度マップを各フレームで復元する。
2. 焦点距離で深度のメートル基準を合わせる
深度をメートルに換算する際は、写真に記録された焦点距離、つまりレンズが光を集める光学的な距離の値を使うか、別の推定器で値を求める。動画では複数フレームの推定値の中央値を選び、1つの焦点距離を共有する。定規で測る距離の目盛りを合わせるように、焦点距離が予測深度のスケールを決めるわけだ。
同社の発表によると、焦点距離の相対誤差が25%未満となる写真の割合を6つの評価資料で平均した結果は次のとおりだ。
表:焦点距離推定の精度
条件:論文の表6、学習に使っていない6つのデータセット、焦点距離の相対誤差が25%未満となる割合の平均
単位:%
| モデル | 平均精度 |
|---|---|
| Depth Pro 2 | 88.6 |
| Depth Pro | 71.7 |
| UniK3D-L | 57.8 |
同じ評価で従来モデルより高い割合を記録した。焦点距離の情報がない写真や動画のメートル単位の深度推定にとって重要な改善だ。
3. 動画の境界と時間的安定性の評価
同社の発表によると、以下は学習に使っていない資料による動画の評価結果だ。境界F1は実際の物体の境界をどれだけ正しく検出したかを示し、高いほどよい。ジッターは同じ点を追跡したときの深度の揺れの度合いで、低いほど安定している。
表:動画の境界の鮮明さと時間的安定性
条件:論文の表4(b)・5、50フレームのクリップ、各モデルの公式推論解像度、単一画像モデルはフレームごとに処理。逆深度のスケール・基準点の整列はF1ではフレームごと、ジッターでは動画ごとに1回実施し、ジッターは遮蔽されていない正解点を追跡
単位:F1スコア、ジッターは元の値の100倍
| モデル | Sintel F1 | Spring F1 | DyDToF F1 | Sintel ジッター | Spring ジッター |
|---|---|---|---|---|---|
| Depth Pro 2-H+ | 43.4 | 16.8 | 34.4 | 1.39 | 0.86 |
| InfiniDepth | 44.8 | 11.8 | 30.5 | 7.66 | 9.48 |
| Depth Pro | 36.3 | 12.7 | 24.8 | 11.26 | 8.99 |
| π3 | 11.6 | 4.2 | 6.8 | 2.13 | 1.04 |
| DepthCrafter | 24.8 | 7.7 | 15.9 | 2.09 | 1.07 |
| VGGT-Ω-1B | 10.8 | 4.9 | 7.5 | 2.36 | 0.99 |
同じ動画条件で、H+は従来のDepth Proより3つの資料で境界スコアが高く、2つの資料でジッターが低かった。
InfiniDepthはSintelの境界スコアで上回ったが、深度の揺れは大きかった。境界だけが鮮明な結果と、動画全体で使いやすい結果の違いを示している。
4. 動画の長さと処理方式の選択
動画ファイルは標準で16フレームをまとめ、次のまとまりと4フレームを重ねて処理し、まとまりの間での深度変化を和らげる。同社の発表によると、H+はこの設定で720pのDynamicReplicaの300フレーム動画においてジッター0.291を記録した。
速度・メモリは、B200 1基で合成720p入力を処理した場合、毎秒21.7フレーム、最大予約メモリ、つまり実行環境が確保したメモリ領域は10.0GiBだった。焦点距離を与えて推定器を除外し、演算を呼び出すと即座に実行するPyTorchの即時実行方式で測定した。
精度は、計算ごとに精度を変えるbf16自動混合精度を用い、深度の出力部はfp32で計算した。数値は設定ごとに3回実行した中央値だ。
カメラ入力向けには、フレームが届くたびに結果を出す方式も提供する。過去フレームの計算結果を、再利用のために一時保存するキャッシュに置き、現在のフレームから参照させることで、未来のフレームを待つ時間を減らす。
5. 性能の利点と資源コスト
高解像度の入力と時間情報は細部と安定性をともに高めるが、解像度や一度に参照するフレーム数を増やすと、メモリ・演算の負担も増す。同社の発表によると、同じ1080pのクリップで、小型モデルは高速に動作し、大型モデルはより多くのメモリを使用した。
表:モデルサイズ別の動画処理資源
条件:論文の表13、B200 1基、Springの1920×1080動画を32フレーム一括処理、PyTorch即時実行・bf16自動混合精度、焦点距離推定を含む
| モデル | 処理量(毎秒フレーム数) | 最大予約メモリ(GiB) |
|---|---|---|
| Depth Pro 2-S | 44.8 | 8.0 |
| Depth Pro 2-B | 23.6 | 14.0 |
| Depth Pro 2-L | 9.1 | 21.7 |
| Depth Pro 2-H+ | 5.3 | 29.5 |
この測定は焦点距離推定まで含めた一括処理の結果だ。開発者は目標解像度で必要な処理速度とメモリに合わせてサイズを選べる。
6. 公開コードで写真から試す
リポジトリの写真処理の例は次のとおりだ。写真を読み込んでモデルに入力すると、各画素の深度をメートル単位で取得できる。
import av
from depth_pro_2 import create_model_and_transforms, load_rgb, upright

model, transform = create_model_and_transforms("depthpro2-h")  # on the GPU if there is one

# A photo. f_px is the focal length recorded in the photo, or None.
image, f_px = load_rgb("assets/example.jpg")
depth = model.infer(transform(image), f_px=f_px)["depth"]  # meters, shape (height, width)
リポジトリは学習・評価コードを含まず、推論コードを提供しており、重みの利用は非営利の科学研究と学術開発に制限される。即時処理する動画の冒頭は参照できる過去フレームが少なく、相対的に安定性が低い。
Depth Pro 2の価値は境界とフレーム間の安定性を両立する点にあり、導入するモデルのサイズは対象動画の処理速度とメモリ予算で決めるのが合理的だ。