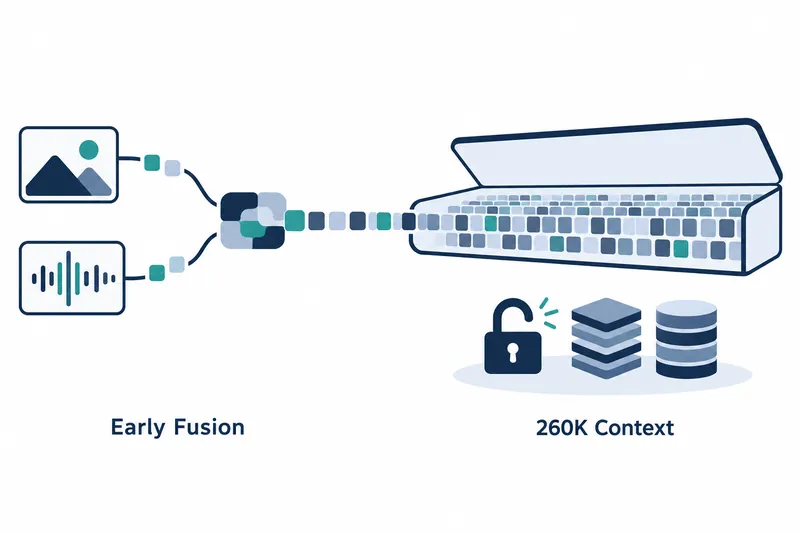
瑞士 AI 倡议发布的 Apertus 1.5 是一次更新,为原本处理文本的模型增加图像与音频输入,并将单次可读取的内容量扩大至四倍。开发者不仅能查看模型权重,还能查阅训练资料和各阶段权重,以评估应用可行性或复现训练过程。
1. 在现有模型基础上继续训练的更新版
该版本并未从头重建上一代模型,而是继续进行学习基础能力的预训练。以模型处理的片段 token 为单位,8B 模型新增 4 万亿个,70B 模型新增 2 万亿个,总训练量分别增至 19 万亿和 17 万亿个 token。
权重于 2026 年 7 月 24 日以 Apache 2.0 许可证公开。技术报告于 10 月 11 日发布,概述报告内容的发布说明于 10 月 15 日推出。
上下文长度为 262,144 个 token,是上一代的四倍。开发团队表示,用户可以选择在回答前进行推理的思考模式,模型的指令遵循和外部工具使用能力也有所改善。
2. 先将输入统一为 token 的设计
核心是在将输入转换为 token 的分词器中,尽早合并不同输入,即早期融合。它没有附加单独分析图像的视觉编码器,而是将图像、音频和文本放入同一 token 序列,在保持模型架构不变的同时增加可处理的 token 类型。
图像使用 Emu3.5 分词器处理。一张 512×512 图像会转换为 1,024 个 token。音频使用 WavTokenizer,每秒为 40 个 token。开发团队表示,口语理解仍处于实验阶段。
3. 训练过程与公开资料
预训练先通过独立的图像和音频学习新输入,再与描述文本、转写文本配对以建立语言联系,随后进行数学、代码资料和长上下文训练。训练 token 中超过一半为纯文本,旨在保留原有语言能力。
在调整回答方式的后训练中,模型使用 370 万个文本样本及图像、语音资料学习标准答案示例。随后再次学习长上下文,并纳入可验证奖励与回答偏好。在公开的最终模型中,只有 8B 应用了最后的宪章对齐阶段。
基础模型和后训练各阶段的权重一并公开,研究者可以调查回答特征在哪个阶段发生变化。报告包含资料构成、训练设置,以及通过改变特定因素来检验效果的实验。
模型运行说明见发布页面的模型卡和快速入门指南。以下并非运行模型的代码,而是报告页面提供的论文阅读命令。
hf papers read 2610.155424. 性能主张与应用注意事项
开发团队报告称,8B 模型在指令遵循和多语言任务上优于规模相近的开放权重模型,思考模式有助于数学推理。但团队也表示,整体表现仍落后于顶尖开放权重模型。
报告认为,其图像与音频理解能力足以与完全开放的多模态模型竞争。但在视觉识别,以及英语等资料丰富语言的语音转写方面,专业模型更胜一筹。
输入范围和上下文的扩大是优势,但图像与音频也会转换为 token,占用上下文空间。此外,输出仅限于文本,因此不能将其视为生成图像或语音的模型。
比较分数时,应同时查看评估执行者、模型访问方式及回答生成设置。该项目在评估结果中记录这些信息,并通过公开评估工具,让用户能够在相同设置下重新进行文本评估。
Apertus 1.5 的意义与其说在于最高性能本身,不如说在于它让开发者能同时审视现有架构的输入与上下文扩展,以及各阶段训练的公开资料。