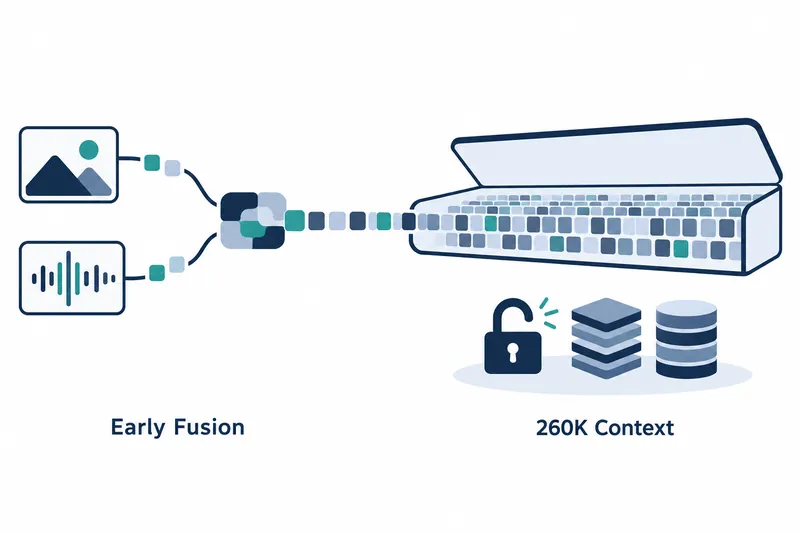
스위스 AI 이니셔티브가 공개한 Apertus 1.5는 글을 다루던 모델에 이미지·오디오 입력을 더하고, 한 번에 읽을 수 있는 분량을 네 배로 늘린 갱신판이다. 개발자는 모델 가중치뿐 아니라 학습 자료와 단계별 가중치도 살펴보며 적용 가능성을 검토하거나 학습 과정을 재현할 수 있다.
1. 기존 모델을 이어 학습한 갱신판
이전 세대를 처음부터 다시 만들지 않고, 기본 능력을 익히는 사전학습을 이어갔다. 모델이 처리하는 조각인 토큰을 기준으로, 8B 모델에는 4조 개를, 70B 모델에는 2조 개를 추가해 총 학습량을 각각 19조, 17조 토큰으로 늘렸다.
가중치는 2026년 7월 24일 Apache 2.0 라이선스로 공개됐다. 기술 보고서는 10월 11일 공개됐고, 이를 요약한 출시 설명은 10월 15일 나왔다.
문맥 길이는 262,144토큰으로 이전 세대의 네 배다. 답하기 전에 추론하는 사고 모드를 선택할 수 있고, 지시 따르기와 외부 도구 사용도 개선했다고 개발팀은 설명했다.
2. 입력을 토큰으로 먼저 합치는 설계
핵심은 입력을 토큰으로 바꾸는 토크나이저에서 서로 다른 입력을 일찍 합치는 조기 융합이다. 이미지를 따로 분석하는 시각 인코더를 붙이는 대신 이미지·오디오·텍스트를 같은 토큰 줄에 넣고, 모델 구조는 그대로 둔 채 처리할 토큰의 종류를 늘렸다.
이미지는 Emu3.5 토크나이저로 처리한다. 512×512 이미지 한 장은 1,024토큰으로 바뀐다. 오디오는 WavTokenizer를 사용하며 초당 40토큰이다. 음성 언어 이해는 아직 실험 단계라고 개발팀은 밝혔다.
3. 학습 과정과 공개 자료
사전학습은 단독 이미지·오디오로 새 입력을 익힌 뒤 설명문·전사문과 짝지어 언어와 연결하고, 수학·코드 자료와 긴 문맥 학습으로 이어졌다. 학습 토큰의 절반 이상은 텍스트만으로 구성해 기존 언어 능력을 보존하려 했다.
답변 방식을 다듬는 사후학습에서는 370만 텍스트 표본과 이미지·음성 자료로 정답 예시를 학습했다. 이어 긴 문맥을 다시 익히고, 검증 가능한 보상과 답변 선호도를 반영했다. 공개된 최종 모델 가운데 헌장에 맞추는 마지막 정렬 단계는 8B에만 적용됐다.
기본 모델과 사후학습 단계별 가중치가 함께 공개돼, 연구자는 어느 단계에서 답변 특성이 바뀌었는지 조사할 수 있다. 보고서는 자료 구성, 학습 설정, 특정 요소를 바꿔 효과를 확인하는 실험을 담는다.
모델 실행 안내는 배포 페이지의 모델 카드와 빠른 시작 가이드에 있다. 아래는 모델 실행 코드가 아니라 보고서 페이지가 안내하는 논문 읽기 명령이다.
hf papers read 2610.155424. 성능 주장과 적용 시 주의점
개발팀은 8B 모델이 비슷한 크기의 공개 가중치 모델보다 지시 따르기와 다국어 작업에서 앞섰고, 사고 모드가 수학 추론을 돕는다고 보고했다. 다만 전체적으로는 최상위 공개 가중치 모델에 뒤처진다고도 밝혔다.
이미지·오디오 이해는 완전 공개 멀티모달 모델과 경쟁할 만한 수준이라는 것이 보고서의 평가다. 반면 시각 인식이나 영어 등 자료가 풍부한 언어의 음성 전사에서는 전문 모델이 앞선다고 설명했다.
입력 범위와 문맥이 커진 점은 이점이지만, 이미지·오디오도 토큰으로 바뀌어 문맥 공간을 차지한다. 또한 결과 생성은 텍스트에 한정되므로 이미지나 음성을 만들어 주는 모델로 볼 수는 없다.
점수를 비교할 때는 평가 수행자와 모델 접근 방식, 답변 생성 설정을 함께 봐야 한다. 프로젝트는 평가 결과에 이런 정보를 기록하고, 공개 평가 도구를 통해 같은 설정으로 텍스트 평가를 다시 수행할 수 있게 했다.
Apertus 1.5는 최고 성능 자체보다 기존 구조의 입력·문맥 확장과 단계별 학습 공개를 함께 검토하려는 개발자에게 의미가 큰 갱신판이다.