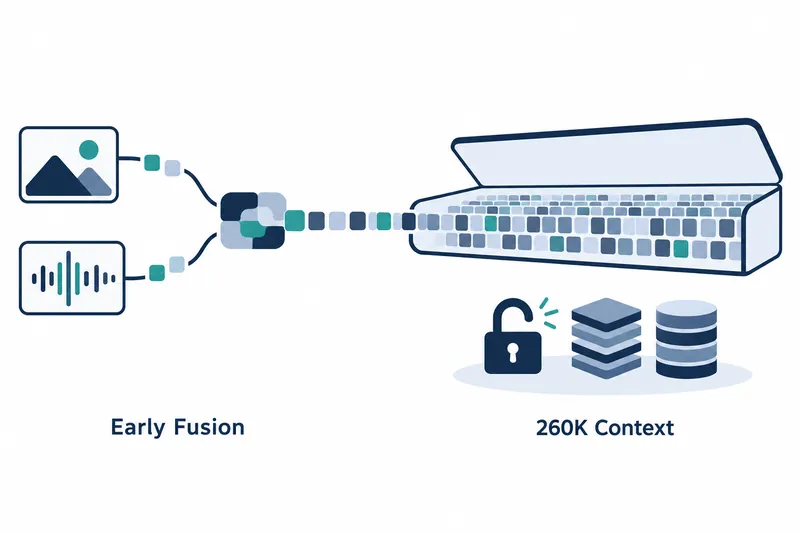
スイスAIイニシアチブが公開したApertus 1.5は、文章を扱っていたモデルに画像・音声入力を加え、一度に読める量を4倍に増やした更新版だ。開発者はモデルの重みだけでなく、学習資料や段階別の重みも調べ、適用可能性の検討や学習過程の再現ができる。
1. 既存モデルの学習を継続した更新版
前世代を最初から作り直すのではなく、基本能力を身につける事前学習を継続した。モデルが処理する断片であるトークンを基準に、8Bモデルには4兆個、70Bモデルには2兆個を追加し、総学習量をそれぞれ19兆、17兆トークンに増やした。
重みは2026年7月24日にApache 2.0ライセンスで公開された。技術報告書は10月11日に公開され、その要約となるリリース解説は10月15日に出た。
文脈長は262,144トークンで、前世代の4倍だ。回答前に推論する思考モードを選べ、指示への追従や外部ツールの使用も改善したと開発チームは説明した。
2. 入力をまずトークンとして統合する設計
核心は、入力をトークンに変えるトークナイザーで異なる入力を早期に統合する早期融合だ。画像を別途解析する視覚エンコーダーを付ける代わりに、画像・音声・テキストを同じトークン列に入れ、モデル構造を変えずに処理するトークンの種類を増やした。
画像はEmu3.5トークナイザーで処理する。512×512の画像1枚は1,024トークンに変換される。音声はWavTokenizerを使い、毎秒40トークンとなる。音声言語理解はまだ実験段階だと開発チームは述べた。
3. 学習過程と公開資料
事前学習では、単独の画像・音声で新たな入力を学んだ後、説明文・書き起こしと組み合わせて言語と結びつけ、数学・コードの資料と長い文脈の学習へ進んだ。学習トークンの半分以上をテキストのみで構成し、既存の言語能力の維持を図った。
回答方法を調整する事後学習では、370万のテキストサンプルと画像・音声資料で正解例を学習した。続いて長い文脈を再学習し、検証可能な報酬と回答の選好を反映した。公開された最終モデルのうち、憲章に合わせる最後のアラインメント段階は8Bのみに適用された。
ベースモデルと事後学習の段階別の重みが併せて公開され、研究者はどの段階で回答の特性が変わったかを調べられる。報告書には資料構成、学習設定、特定の要素を変えて効果を確認する実験が記されている。
モデルの実行案内は、配布ページのモデルカードとクイックスタートガイドにある。以下はモデル実行コードではなく、報告書のページで案内されている論文を読むためのコマンドだ。
hf papers read 2610.155424. 性能に関する主張と適用時の注意点
開発チームは、8Bモデルが同程度の規模の重み公開モデルより指示への追従と多言語タスクで優れ、思考モードが数学的推論を助けると報告した。ただし、全体としては最上位の重み公開モデルに及ばないとも述べた。
画像・音声理解は、完全公開のマルチモーダルモデルと競える水準だというのが報告書の評価だ。一方、視覚認識や、英語など資料が豊富な言語の音声書き起こしでは、専門モデルが上回ると説明した。
入力範囲と文脈の拡大は利点だが、画像・音声もトークンに変換され、文脈の領域を占める。また、生成結果はテキストに限られるため、画像や音声を生成するモデルとはみなせない。
スコアを比較する際は、評価実施者やモデルへのアクセス方法、回答生成の設定を併せて確認する必要がある。プロジェクトは評価結果にこれらの情報を記録し、公開評価ツールで同じ設定のテキスト評価を再実行できるようにした。
Apertus 1.5は、最高性能そのものよりも、既存構造の入力・文脈の拡張と段階別の学習公開を併せて検討したい開発者にとって意義の大きい更新版だ。