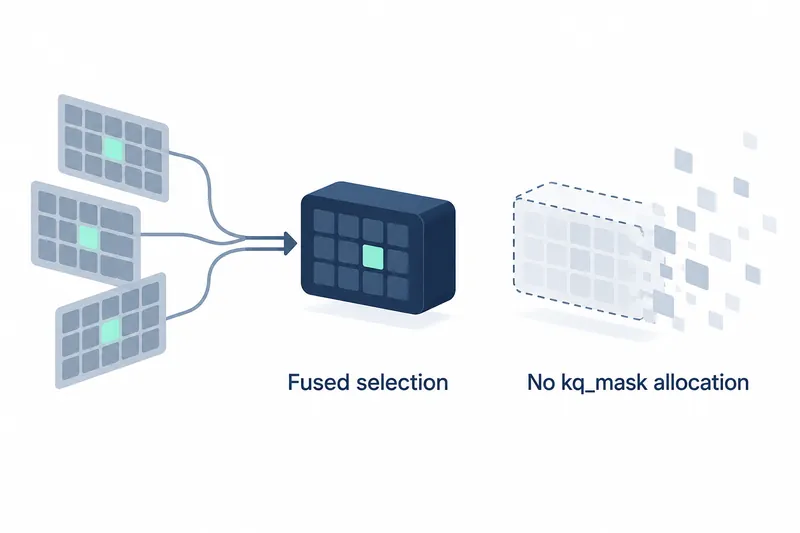
llama.cpp에 특정 모델의 어텐션, 입력 간 관계를 계산하는 기능의 처리에서 중간 메모리 버퍼, 임시 데이터를 담아 두는 공간을 만들지 않는 변경이 병합됐다. Qwen 계열의 해당 모델을 실행할 때 그래픽 메모리와 호스트 메모리, CPU가 사용하는 메모리를 함께 아낄 수 있어, 메모리가 빠듯한 환경에서 큰 모델을 다룰 여유가 생긴다.
1. 모델의 어텐션 처리에서 불필요한 버퍼 제거
2026년 10월 23일 병합된 풀 리퀘스트, 코드 변경 검토를 요청하는 절차 30965는 qwen4exp에 적용되는 변경이다. 제출자는 이 모델의 어텐션 계층 12개가 모두 QSA 방식이므로 kq_mask를 별도로 할당할 필요가 없다고 설명했다.
별도 표식을 담아 두는 공간을 만드는 대신, 필요한 선택 결과를 한데 결합하는 방식이다. 커밋 설명에 따르면 여러 처리 흐름을 함께 쓸 때 선택 결과의 배열 형태가 맞지 않아 발생하던 메모리 사전 확보 단계의 오류도 수정했다.
2. 계산 버퍼, 임시 연산 결과를 담는 공간에서 확인된 메모리 감소
제출자 sanmai는 계산 버퍼만 집계해 기존 master 빌드, 기준 코드로 만든 실행 파일과 변경 빌드를 비교했다. 아래 표의 ubatch는 한 번에 계산하는 토큰 묶음의 크기다.
측정은 5090@400W에서 진행됐다. CUDA0는 GPU 쪽, CUDA_Host는 호스트 쪽 버퍼를 가리킨다.
표: 빌드별 계산 버퍼 메모리
조건: Qwen3.8-Flash-Next UD-Q4_K_XL, 5090@400W, --load-mode dio, -cmoe --moe-cache-mib 8000 -ctk q8_0 -ctv q5_1
단위: MiB
| 항목 | master | PR |
|---|---|---|
| CUDA0 버퍼, ubatch 4096 | 7088 | 5046 |
| CUDA0 버퍼, ubatch 8192 | 13327 | 9237 |
| CUDA_Host 버퍼, ubatch 4096 | 2765 | 717 |
| CUDA_Host 버퍼, ubatch 8192 | 5526 | 1430 |
두 버퍼 모두 변경 빌드에서 작아졌다. 제출자는 이를 토큰 묶음 크기 4096에서 GPU와 호스트 메모리 각각 2GB, 8192에서 각각 4GB 절감으로 요약했다. 모델 계산에 필요한 임시 작업 공간이 양쪽에서 함께 줄어든 결과다.
3. 속도와 실제 모델 검증
제출자는 다른 조건이 같을 때 토큰 생성 속도가 40% 향상됐다고 밝혔다. 공개된 변경 빌드 측정에서 ubatch 4096, 전문가 캐시, 모델 전문가 정보를 임시 보관하는 저장소 17750 MiB일 때 입력 처리 속도는 초당 1004토큰, 생성 속도는 초당 45.5토큰, 최고 그래픽 메모리 사용량은 32066 MiB였다.
ubatch 8192, 전문가 캐시 13400 MiB에서는 입력 처리 속도가 초당 1470토큰, 생성 속도가 초당 41.2토큰, 최고 그래픽 메모리 사용량이 32036 MiB였다. 두 측정은 앞서 제시한 5090@400W와 같은 로딩 방식을 사용했다.
원문의 속도 표에는 기존 빌드의 기준 수치가 없으며, 두 실행도 캐시 설정이 달라 서로의 우열을 비교하기 어렵다. 계산 버퍼 표 역시 전체 메모리가 아닌 임시 계산 공간을 집계한 결과다.
리뷰 승인자 ServeurpersoCom은 실제 UD-Q4_K_XL 모델로 확인했다고 밝혔다. 컨텍스트, 모델이 참고하는 입력 범위 16384에서 다음 토큰 후보의 점수인 로짓이 기존 빌드와 바이트 단위로 같았고, 컨텍스트 262144와 토큰 묶음 크기 8192에서는 계산 버퍼와 고정 호스트 버퍼가 각각 4GiB씩 줄었다는 내용이다.
4. 공개된 실행 명령으로 조건 확인
제출자는 Qwen3.8-Flash-Next의 UD-Q4_K_XL 모델에 사용한 실행 명령을 공개했다. 이 명령은 전문가 캐시를 13400 MiB로 설정한 측정에 해당하며, 로딩 방식과 토큰 묶음 크기도 함께 확인할 수 있다.
llama-server -hf unsloth/Qwen3.8-Flash-Next-GGUF:UD-Q4_K_XL \
    --no-mmproj -ctk q8_0 -ctv q5_1 --cache-ram 32768 \
    -b 8192 -ub 8192 \
    -cmoe --moe-cache-mib 13400 --load-mode dio
제출자는 이 접근의 효과가 16GB·24GB 그래픽 카드 사용자에게 가장 크게 느껴질 것이라고 전망했다. 확보한 공간의 가치는 메모리 한계에 얼마나 가까운 조건으로 실행하느냐에 달려 있다는 판단이다.
5. 모델 맞춤 최적화의 의미
이득은 GPU와 호스트의 계산 공간 절감이고, 그 대가로 필요한 작업은 모델별 실행 경로를 맞추는 개발·검증이다. 이번 변경에서도 배열 형태 수정과 실제 모델의 로짓 비교가 함께 이뤄졌다. 사용자의 설정 조합보다 구현 쪽에 작업이 집중된 최적화다.
변경은 자동 점검 19개를 통과해 master에 병합됐다. 해당 모델을 사용하는 개발자에게는 병합 내용을 포함한 빌드로 메모리 절감을 활용할 수 있는 경로가 열린 셈이다.
이번 병합은 QSA 모델에서 필요하지 않은 버퍼를 제거해, 특히 메모리 한계가 가까운 실행 환경에 실질적인 여유를 더한다.