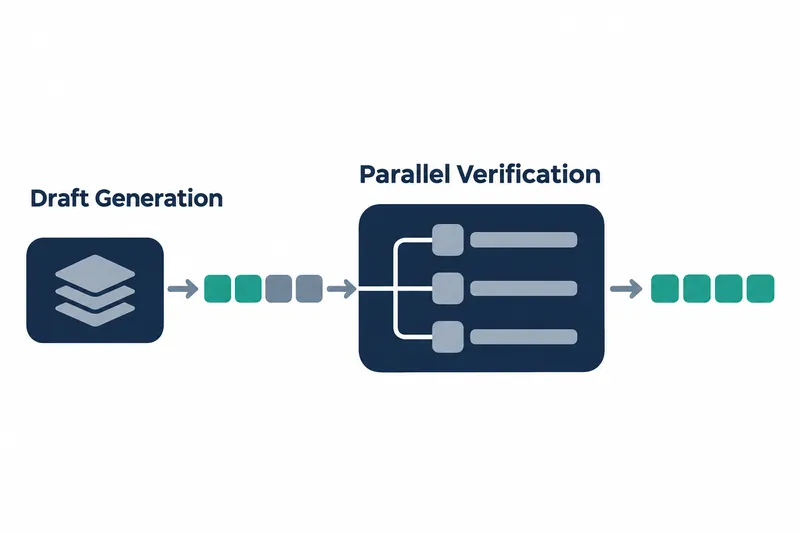
텐센트가 대형 언어 모델의 답변 생성을 돕는 보조 모델을 공개했다. 언어 모델을 서비스하는 개발자는 여러 토큰 후보를 한꺼번에 만들고 검증해 처리량을 높이는 데 이 모델을 활용할 수 있다.
1. 앞자리 예측을 뒤자리 계산에 전달
DSpine은 Qwen3.8-27B가 확인할 후보를 제안하는 드래프트 모델이다. 이런 스펙큘레이티브 디코딩에서는 보조 모델이 후보를 먼저 만들고 목표 모델이 한 번에 확인한다. 앞쪽 후보가 틀리면 뒤쪽도 버려져 앞뒤가 맞는 후보를 만드는 일이 중요하다.
각 층에서 앞자리의 예측 정보를 바로 뒷자리로 넘기고, 받는 쪽이 반영할 양을 조절하면서 모든 위치를 병렬로 계산한다. 토큰을 선택할 때는 이웃 후보 조합의 점수를 미리 계산해 둔 전환 캐시를 활용해 순차 계산을 줄인다.
2. Qwen3.8-27B와 함께 쓰는 공개 모델
텐센트가 공개한 학습 완료 모델 파일인 체크포인트는 Qwen3.8-27B용 5층 드래프트 모델이다. 블록 크기는 16이고, 한 번에 참조하는 최근 문맥의 범위인 슬라이딩 윈도우는 8,192토큰이다.
약 20억 개의 파라미터를 담은 BF16 가중치 파일은 약 4.05GB이며, 라이선스는 Apache 2.0이다. 목표 모델과 함께 운영할 때는 이 보조 가중치도 준비해야 한다.
모델 카드의 설치 예시는 다음과 같다.
git clone https://github.com/Tencent/DSpine.git
cd DSpine
pip install -e .
설치 뒤에는 SGLang에서 목표 모델과 드래프트 모델의 경로를 지정해 함께 실행한다. 답변을 만드는 목표 모델은 그대로 두고, 후보를 만드는 보조 모델을 붙이는 방식이다.
3. 모델 카드에서 보고한 수용 길이
수용 길이는 검증을 거쳐 한 라운드에서 평균적으로 진행한 토큰 수다. 회사 발표 기준 아래 다섯 과제의 온도 0 평가에서 DSpine의 수용 길이가 DFlash2보다 길었다. 두 보조 모델은 한 번에 다루는 블록 크기가 각각 16과 8이다.
표: 일반 벤치마크의 온도 0 수용 길이
조건: Qwen3.8-27B, SGLang 0.5.22, BF16, FlashAttention 3, 동시성 8, xhigh 추론 모드, 최대 4,096개 신규 토큰, 온도 0; DSpine 블록 16, DFlash2 블록 8; DSpine은 동적 검증과 ReplaySSM 사용
단위: 평균 토큰/라운드
| 항목 | DFlash2 | DSpine |
|---|---|---|
| GSM8K | 5.69 | 7.20 |
| MATH-500 | 5.49 | 6.49 |
| HumanEval | 4.87 | 5.71 |
| MBPP | 5.04 | 6.14 |
| MT-Bench | 4.11 | 4.48 |
같은 실행 환경에서도 과제에 따라 수용 길이 차이는 달랐다. 회사 발표 기준 온도 1의 샘플링 평가에서도 다섯 과제 모두 수용 길이가 늘었다.
4. 사무 작업 재생에서 자기회귀 대비 3.84배
회사 발표 기준 사무 작업 평가에서 DSpine의 종단 처리량은 앞선 토큰을 바탕으로 차례로 생성하는 자기회귀 방식의 3.84배였다. 이는 도구 호출을 포함한 대화 기록을 순서대로 재생하며, 전체 출력 토큰 수를 동시 재생의 전체 경과 시간으로 나눈 결과다.
표: 사무 작업 재생의 종단 처리량
조건: WorkBuddy Office, Qwen3.8-27B, SGLang 0.5.22, BF16, FlashAttention 3, 동시성 8, low 추론 모드, 온도 1.0, 누적 확률 상한 0.95, 상위 후보 20개를 쓰는 샘플링, 대화 20개. CodeBuddy의 외부와 분리해 실행하는 환경인 샌드박스 기록 재생, 앞부분 계산 결과를 저장해 재사용하는 접두사 캐시, 요청당 최대 32,768개 신규 토큰; DSpine 블록 16, DFlash2 블록 8; DSpine은 동적 검증과 ReplaySSM 사용
| 항목 | 처리량(토큰/초) | 자기회귀 대비 배수 |
|---|---|---|
| 자기회귀 | 210.03 | — |
| DFlash2 | 664.77 | 3.17 |
| DSpine | 805.53 | 3.84 |
이 조건에서는 수용 길이의 개선이 실제 처리량 증가로도 이어졌다. 모델 카드의 다른 에이전트 과제에서도 회사 발표 기준 DSpine은 비교 모델보다 높은 수용 길이를 기록했다.
5. 검증 효율을 높이는 대신 후보 계산 추가
연구진은 별도 논문에서 Qwen3-8B의 온도 0 평균 수용 길이가 DFlash의 3.77에서 새 모델의 4.82로 늘었다고 보고했다. 추론 모드를 끄고 매 라운드 후보 15개를 제안해 일곱 과제의 평균을 낸 결과다.
논문의 SGLang 처리량도 DFlash보다 평균 23.3% 높았다. 측정 과제는 수학·코드 분야의 네 가지였다.
이 서빙 평가는 단일 GPU, BF16, FlashAttention-3, 온도 0, 동시성 2~32, 최대 출력 2,048토큰으로 진행했다. 논문과 모델 카드는 대상 모델과 실행 조건이 달라 결과를 직접 비교하기 어렵다.
이득은 검증 한 번으로 더 많은 토큰을 확정하는 데서 나온다. 논문의 Qwen3-8B 지연 분석에서 검증은 라운드 시간의 72~76%였으며, 새 모델의 라운드 비용은 7.14밀리초로 DFlash2의 7.19밀리초와 비슷했다. 생성 토큰당 디코딩 시간은 DFlash2보다 10.9% 적었다.
대가는 보조 모델의 추가 계산이다. 층별 정보 전달은 다섯 층을 합쳐 라운드당 최대 0.15밀리초를 더했고, 전환 캐시도 후보 조합을 미리 점수화하는 계산을 추가했다. 더 긴 후보 수용이 이 비용을 상쇄한 셈이다.
DSpine의 도입 가치는 후보를 빨리 만드는 데 그치지 않고, 검증 한 번으로 더 많은 토큰을 확정해 추가 계산을 상쇄하는 데 있다.