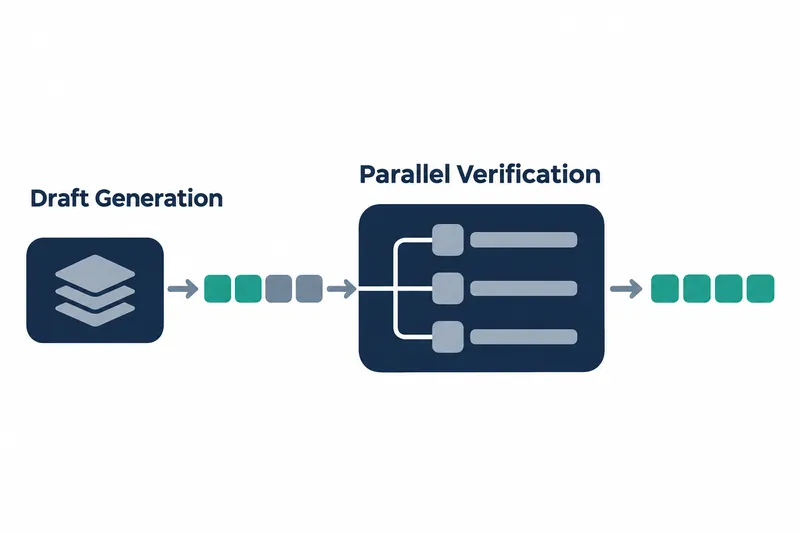
腾讯发布了一款辅助大语言模型生成回答的模型。部署语言模型服务的开发者可以利用它一次生成并验证多个候选 token,以提高吞吐量。
1. 将前一位置的预测传递给后一位置的计算
DSpine 是为 Qwen3.8-27B 提出待验证候选的草稿模型。在这种推测解码中,辅助模型先生成候选,目标模型再一次性验证。若前面的候选出错,后面的也会被丢弃,因此生成前后一致的候选十分重要。
每一层都将前一位置的预测信息传给紧邻的后一位置,由接收方调节采纳量,同时并行计算所有位置。选择 token 时,利用预先计算相邻候选组合得分的转移缓存,减少串行计算。
2. 与 Qwen3.8-27B 配套使用的公开模型
腾讯公开的已训练模型文件,即检查点,是面向 Qwen3.8-27B 的 5 层草稿模型。块大小为 16,滑动窗口即一次参考的最近上下文范围为 8,192 个 token。
包含约 20 亿个参数的 BF16 权重文件约为 4.05GB,许可证为 Apache 2.0。与目标模型一同运行时,也需要准备这些辅助权重。
模型卡中的安装示例如下。
git clone https://github.com/Tencent/DSpine.git
cd DSpine
pip install -e .
安装后,在 SGLang 中指定目标模型和草稿模型的路径,一起运行。其方式是保留生成回答的目标模型,再接入生成候选的辅助模型。
3. 模型卡报告的接受长度
接受长度指经过验证后,每轮平均推进的 token 数。根据公司公布的数据,在以下五项任务的温度 0 评测中,DSpine 的接受长度均高于 DFlash2。两款辅助模型每次处理的块大小分别为 16 和 8。
表:通用基准测试中温度 0 的接受长度
条件:Qwen3.8-27B、SGLang 0.5.22、BF16、FlashAttention 3、并发数 8、xhigh 推理模式、最多 4,096 个新 token、温度 0;DSpine 块大小 16,DFlash2 块大小 8;DSpine 使用动态验证和 ReplaySSM
单位:平均 token 数/轮
| 项目 | DFlash2 | DSpine |
|---|---|---|
| GSM8K | 5.69 | 7.20 |
| MATH-500 | 5.49 | 6.49 |
| HumanEval | 4.87 | 5.71 |
| MBPP | 5.04 | 6.14 |
| MT-Bench | 4.11 | 4.48 |
即使运行环境相同,接受长度的差距也因任务而异。根据公司公布的数据,在温度 1 的采样评测中,五项任务的接受长度也均有所提升。
4. 办公任务回放中达到自回归的 3.84 倍
根据公司公布的数据,在办公任务评测中,DSpine 的端到端吞吐量是基于前序 token 逐个生成的自回归方式的 3.84 倍。该结果通过依次回放包含工具调用的对话记录,以总输出 token 数除以并发回放的总耗时得出。
表:办公任务回放的端到端吞吐量
条件:WorkBuddy Office、Qwen3.8-27B、SGLang 0.5.22、BF16、FlashAttention 3、并发数 8、low 推理模式、温度 1.0、累积概率上限 0.95、使用前 20 个候选的采样、20 段对话、CodeBuddy 隔离运行环境即沙箱的记录回放、保存并复用前部计算结果的前缀缓存、每请求最多 32,768 个新 token。DSpine 块大小 16,DFlash2 块大小 8;DSpine 使用动态验证和 ReplaySSM
| 项目 | 吞吐量(token/秒) | 相对自回归的倍数 |
|---|---|---|
| 自回归 | 210.03 | — |
| DFlash2 | 664.77 | 3.17 |
| DSpine | 805.53 | 3.84 |
在这些条件下,接受长度的改善也转化为实际吞吐量的提升。根据公司公布的数据,在模型卡的其他智能体任务中,DSpine 的接受长度也高于对比模型。
5. 提高验证效率,但增加候选计算
研究团队在另一篇论文中报告,Qwen3-8B 在温度 0 下的平均接受长度从 DFlash 的 3.77 提高到新模型的 4.82。该结果关闭了推理模式,每轮提出 15 个候选,并对七项任务取平均值。
论文中的 SGLang 吞吐量也比 DFlash 平均高 23.3%。测试任务为数学和代码领域的四项任务。
该服务评测采用单 GPU、BF16、FlashAttention-3、温度 0、并发数 2~32,最大输出为 2,048 个 token。论文与模型卡的目标模型及运行条件不同,难以直接比较结果。
收益来自一次验证能确认更多 token。论文对 Qwen3-8B 的延迟分析显示,验证占每轮耗时的 72~76%,新模型每轮耗时为 7.14 毫秒,与 DFlash2 的 7.19 毫秒相近。每个生成 token 的解码耗时比 DFlash2 少 10.9%。
代价是辅助模型的额外计算。逐层信息传递在五层合计每轮最多增加 0.15 毫秒,转移缓存也增加了预先为候选组合评分的计算。更长的候选接受长度抵消了这些成本。
DSpine 的引入价值不仅在于快速生成候选,更在于通过一次验证确认更多 token,从而抵消额外计算。