テンセントが大規模言語モデルの回答生成を支援する補助モデルを公開した。言語モデルを提供する開発者は、複数のトークン候補をまとめて生成・検証し、処理量を高めるためにこのモデルを活用できる。
1. 前の位置の予測を次の位置の計算に伝達
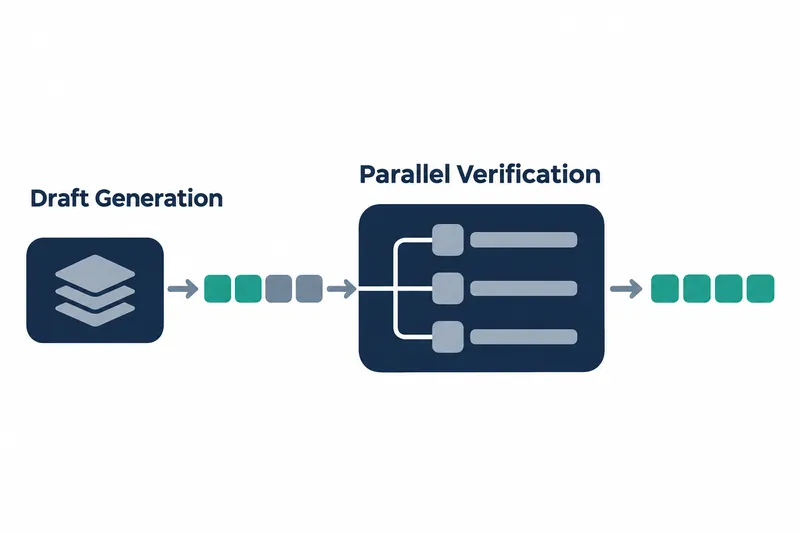
DSpineはQwen3.8-27Bが検証する候補を提案するドラフトモデルだ。このような投機的デコーディングでは、補助モデルが先に候補を生成し、ターゲットモデルがまとめて検証する。前方の候補を誤ると後方も破棄されるため、前後の整合性がある候補の生成が重要だ。
各層で前の位置の予測情報を直後の位置に渡し、受け手が反映量を調節しながら全位置を並列に計算する。トークン選択時には、隣接候補の組み合わせのスコアを事前計算した遷移キャッシュを使い、逐次計算を減らす。
2. Qwen3.8-27Bと組み合わせる公開モデル
テンセントが公開した学習済みモデルファイルであるチェックポイントは、Qwen3.8-27B用の5層ドラフトモデルだ。ブロックサイズは16で、一度に参照する直近の文脈範囲を示すスライディングウィンドウは8,192トークンだ。
約20億個のパラメータを含むBF16重みファイルは約4.05GBで、ライセンスはApache 2.0だ。ターゲットモデルと一緒に運用する際は、この補助重みも用意する必要がある。
モデルカードのインストール例は次のとおりだ。
git clone https://github.com/Tencent/DSpine.git
cd DSpine
pip install -e .
インストール後はSGLangでターゲットモデルとドラフトモデルのパスを指定し、一緒に実行する。回答を生成するターゲットモデルはそのままに、候補を生成する補助モデルを追加する方式だ。
3. モデルカードで報告された受容長
受容長は、検証を経て1ラウンドで平均何トークン進んだかを表す。同社の発表によると、以下の五つの課題の温度0評価でDSpineの受容長はDFlash2より長かった。二つの補助モデルが一度に扱うブロックサイズは、それぞれ16と8だ。
表:一般ベンチマークの温度0での受容長
条件:Qwen3.8-27B、SGLang 0.5.22、BF16、FlashAttention 3、同時実行数8、xhigh推論モード、最大4,096新規トークン、温度0;DSpineブロック16、DFlash2ブロック8;DSpineは動的検証とReplaySSMを使用
単位:平均トークン/ラウンド
| 項目 | DFlash2 | DSpine |
|---|---|---|
| GSM8K | 5.69 | 7.20 |
| MATH-500 | 5.49 | 6.49 |
| HumanEval | 4.87 | 5.71 |
| MBPP | 5.04 | 6.14 |
| MT-Bench | 4.11 | 4.48 |
同じ実行環境でも課題によって受容長の差は異なった。同社の発表によると、温度1のサンプリング評価でも五つの課題すべてで受容長が伸びた。
4. 事務作業の再生で自己回帰比3.84倍
同社の発表によると、事務作業評価でDSpineのエンドツーエンド処理量は、先行トークンに基づき順番に生成する自己回帰方式の3.84倍だった。これはツール呼び出しを含む会話記録を順に再生し、総出力トークン数を同時再生の総経過時間で割った結果だ。
表:事務作業再生のエンドツーエンド処理量
条件:WorkBuddy Office、Qwen3.8-27B、SGLang 0.5.22、BF16、FlashAttention 3、同時実行数8、low推論モード、温度1.0、累積確率上限0.95、上位候補20個でのサンプリング、会話20件。CodeBuddyの外部から隔離した環境であるサンドボックスの記録再生、前半の計算結果を保存して再利用するプレフィックスキャッシュ、要求当たり最大32,768新規トークン;DSpineブロック16、DFlash2ブロック8;DSpineは動的検証とReplaySSMを使用
| 項目 | 処理量(トークン/秒) | 自己回帰比の倍率 |
|---|---|---|
| 自己回帰 | 210.03 | — |
| DFlash2 | 664.77 | 3.17 |
| DSpine | 805.53 | 3.84 |
この条件では受容長の改善が実際の処理量増加にもつながった。同社の発表によると、モデルカードの他のエージェント課題でもDSpineは比較モデルより高い受容長を記録した。
5. 検証効率を高める代わりに候補計算を追加
研究陣は別の論文で、Qwen3-8Bの温度0での平均受容長がDFlashの3.77から新モデルの4.82に伸びたと報告した。推論モードをオフにし、各ラウンドで候補15個を提案して七つの課題の平均を取った結果だ。
論文のSGLang処理量もDFlashより平均23.3%高かった。測定課題は数学・コード分野の四つだった。
このサービング評価は単一GPU、BF16、FlashAttention-3、温度0、同時実行数2~32、最大出力2,048トークンで実施した。論文とモデルカードでは対象モデルと実行条件が異なるため、結果の直接比較は難しい。
利点は1回の検証でより多くのトークンを確定できる点にある。論文のQwen3-8Bの遅延分析では、検証がラウンド時間の72~76%を占め、新モデルのラウンドコストは7.14ミリ秒でDFlash2の7.19ミリ秒と同程度だった。生成トークン当たりのデコーディング時間はDFlash2より10.9%少なかった。
代償は補助モデルの追加計算だ。層ごとの情報伝達は五つの層を合わせてラウンド当たり最大0.15ミリ秒を追加し、遷移キャッシュも候補の組み合わせを事前にスコア化する計算を追加した。より長い候補の受容がこのコストを相殺したことになる。
DSpineの導入価値は候補を速く生成するだけでなく、1回の検証でより多くのトークンを確定し、追加計算を相殺する点にある。