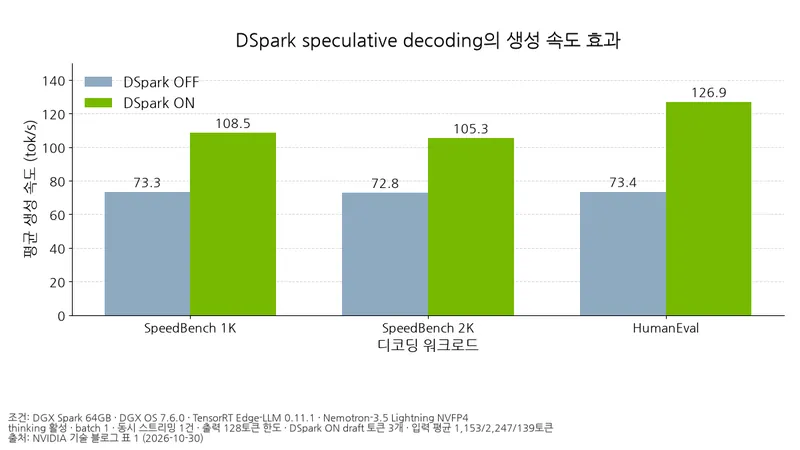
NVIDIA가 2026년 10월 30일 공개한 튜토리얼은 명령 몇 개로 로컬 OpenAI 호환 API 서버를 띄워, 클라우드 API 대신 기기에서 에이전트를 시험하는 절차를 담았다. 후보 토큰을 미리 제안하는 가속 기능을 켠 회사 측 측정에서는 첫 응답 대기 시간은 거의 그대로였지만 이후 문장을 생성하는 속도가 빨라졌다.
대상은 DGX Spark 64GB에서 실행한 Nemotron-3.5 Lightning이다. 아래 수치는 모두 NVIDIA 발표 기준이다.
결과
조건: DGX Spark 64GB·DGX OS 7.6.0(Ubuntu 24.04.4 LTS)·Edge-LLM 0.11.1·Nemotron-3.5 Lightning 30B-A3B NVFP4(4비트 부동소수점 양자화)·추론 과정을 수행하는 thinking 설정 활성·배치 크기 1·동시 스트리밍 1건·출력 128토큰 한도·DSpark 사용 시 후보 토큰 3개. 평균 입력은 표 순서대로 1,153/2,247/139토큰. 출처는 NVIDIA 기술 블로그 표 1.
표: DSpark 사용 여부별 생성 속도와 첫 토큰 지연
단위: 생성 속도 tok/s, 첫 토큰 지연 ms
| 디코딩 워크로드 | DSpark 미사용 평균 생성 속도 | DSpark 사용 평균 생성 속도 | DSpark 미사용 첫 토큰 지연 중앙값 | DSpark 사용 첫 토큰 지연 중앙값 |
|---|---|---|---|---|
| SpeedBench 1K | 73.3 | 108.5 | 201.0 | 203.0 |
| SpeedBench 2K | 72.8 | 105.3 | 329.5 | 331.6 |
| HumanEval 프롬프트 | 73.4 | 126.9 | 98.1 | 98.7 |
표의 값으로 계산하면 HumanEval 생성 속도는 73.4→126.9 tok/s로 약 72.9%, 두 SpeedBench 결과는 약 44.6~48.0% 올랐다. 반면 첫 토큰까지 걸린 시간(TTFT)의 중앙값은 모두 2.1ms 이내 차이였다. 생성 속도는 첫 토큰 시간을 뺀 값이므로, 개선은 첫 응답보다 이후 토큰을 이어 붙이는 구간에 집중됐다.
입력이 가장 긴 SpeedBench 2K에서 TTFT가 가장 길고, HumanEval에서 가장 짧다. DSpark을 켜도 이 순서는 그대로여서, 후보 토큰 검증을 더하는 비용이 첫 토큰 지연을 크게 밀어내지는 않았다.
기기·방식별 성능 문서 비교
조건: TensorRT Edge-LLM 0.10.0 런타임 처리량 대시보드, llm_inference 측정, Nemotron-3.5-Lightning-30B-A3B NVFP4, 배치 크기 1, 입력 처리 구간 66토큰. 출처는 NVIDIA 공식 성능 문서.
표: 추론 가속 방식·기기별 생성 속도와 평균 채택 길이
단위: 생성 속도 tok/s, 평균 채택 길이 토큰/검증 단계
| 추론 가속 방식 | DGX Spark (GB10) 생성 속도 | 평균 채택 길이 | Jetson AGX Thor 생성 속도 | 평균 채택 길이 |
|---|---|---|---|---|
| 기본 생성 | 75.6 | — | 81.6 | — |
| MTP | 93.2 | 2.70 | 95.3 | 2.69 |
| DFlash | 61.5 | 2.23 | 58.7 | 2.22 |
MTP는 다음 토큰 여러 개를 예측하도록 학습시키는 기법이고, DFlash는 초안 모델로 후보 묶음을 통째로 만드는 방식이다. 평균 채택 길이는 검증 1회당 받아들인 토큰 수다. MTP는 두 기기 모두 기본 생성보다 빨랐지만 DFlash는 느렸다. 채택된 토큰 수뿐 아니라 후보 생성·검증에 드는 비용도 속도 이득을 좌우하므로, 채택 길이와 최종 생성 속도를 함께 볼 필요가 있다.
왜 이런 차이가 나나
DSpark을 켰을 때 줄어드는 것은 주 모델을 반복 실행하는 횟수다. 초안 모델이 후보 토큰 묶음을 먼저 제안하고 주 모델이 그 묶음을 한 번에 검증하기 때문이다.
고를 때 기준
대화형 요청이 주 목적이면 Nemotron-3.5 Lightning 모델 카드는 DSpark을 DGX Spark와 저동시성·지연 민감 서빙의 기본 권장으로 안내한다. 작업에 따라 가속을 끄거나 DFlash·MTP가 더 맞을 수 있어 후보 토큰 수를 바꿔 비교하는 편이 낫다. 데이터센터 배치 처리량이 목표라면 NVIDIA는 Nemotron-3.5 Lightning 모델 카드에서 1× H100 최대 처리량 배치의 vLLM과 humming 백엔드 구성이 speculative decoding을 쓰지 않는 편이 가장 빠르다고 안내한다. 이 권고는 H100 배치에 대한 것이다.
로컬에서 실행하기
튜토리얼은 CUDA 13·TensorRT 10.16.1.11·Python 3.10~3.12 환경을 전제로 한다. 시스템 패키지에 접근하는 가상환경에 tensorrt-edgellm[server]==0.11.1을 설치한 뒤 다음 명령으로 대화를 시작한다.
trtedge chat nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4로컬 API는 같은 모델 ID를 지정한 trtedge serve로 띄운다. 같은 요청으로 가속을 끈 기준값과 후보 토큰 3개를 켠 결과를 비교할 수 있다.
생성 구간을 빠르게 하는 이득과 첫 응답을 기다리는 시간은 별개이므로, 로컬 대화의 가속 효과는 두 지표를 나눠 판단하는 편이 낫다.