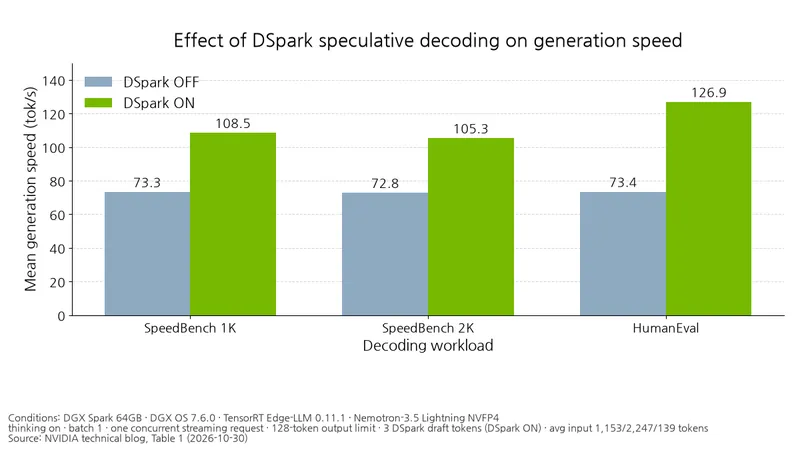
NVIDIA 于 2026年10月30日发布的教程介绍了如何用几条命令启动兼容 OpenAI 的本地 API 服务器,在设备上而非通过云端 API 测试智能体。在该公司启用预先提出候选 token 的加速功能后,测量显示首次响应等待时间几乎不变,但后续文本生成速度加快。
测试对象是在 DGX Spark 64GB 上运行的 Nemotron-3.5 Lightning。以下数值均以 NVIDIA 公布的数据为准。
结果
条件:DGX Spark 64GB·DGX OS 7.6.0(Ubuntu 24.04.4 LTS)·Edge-LLM 0.11.1·Nemotron-3.5 Lightning 30B-A3B NVFP4(4位浮点量化)·启用执行推理过程的 thinking 设置·批大小 1·并发流 1路·输出上限 128个 token·使用 DSpark 时候选 token 为 3个。平均输入按表中顺序为 1,153/2,247/139个 token。来源为 NVIDIA 技术博客表 1。
表:使用与不使用 DSpark 时的生成速度和首 token 延迟
单位:生成速度 tok/s,首 token 延迟 ms
| 解码工作负载 | 未使用 DSpark 的平均生成速度 | 使用 DSpark 的平均生成速度 | 未使用 DSpark 的首 token 延迟中位数 | 使用 DSpark 的首 token 延迟中位数 |
|---|---|---|---|---|
| SpeedBench 1K | 73.3 | 108.5 | 201.0 | 203.0 |
| SpeedBench 2K | 72.8 | 105.3 | 329.5 | 331.6 |
| HumanEval 提示词 | 73.4 | 126.9 | 98.1 | 98.7 |
根据表中数值计算,HumanEval 生成速度从 73.4→126.9 tok/s,提高约 72.9%,两项 SpeedBench 结果提高约 44.6~48.0%。而首 token 延迟(TTFT)的中位数差异均在 2.1ms 以内。生成速度不计首 token 耗时,因此改善集中在后续 token 的连续生成阶段,而非首次响应。
输入最长的 SpeedBench 2K 的 TTFT 最长,HumanEval 最短。启用 DSpark 后,这一顺序不变,说明增加候选 token 验证的开销并未显著推高首 token 延迟。
性能文档中的设备与方法对比
条件:TensorRT Edge-LLM 0.10.0 运行时吞吐量仪表板,llm_inference 测量,Nemotron-3.5-Lightning-30B-A3B NVFP4,批大小 1,输入处理阶段 66个 token。来源为 NVIDIA 官方性能文档。
表:不同推理加速方法与设备的生成速度和平均接受长度
单位:生成速度 tok/s,平均接受长度 token/验证步骤
| 推理加速方法 | DGX Spark (GB10) 生成速度 | 平均接受长度 | Jetson AGX Thor 生成速度 | 平均接受长度 |
|---|---|---|---|---|
| 基础生成 | 75.6 | — | 81.6 | — |
| MTP | 93.2 | 2.70 | 95.3 | 2.69 |
| DFlash | 61.5 | 2.23 | 58.7 | 2.22 |
MTP 是通过训练来预测多个后续 token 的技术,DFlash 则用草稿模型一次生成整组候选。平均接受长度指每次验证接受的 token 数。MTP 在两款设备上均快于基础生成,但 DFlash 更慢。速度收益不仅取决于接受的 token 数,也受候选生成与验证开销影响,因此需要结合接受长度和最终生成速度来判断。
为何出现这些差异
启用 DSpark 后,减少的是主模型的重复运行次数。因为草稿模型先提出一组候选 token,再由主模型一次性验证整组候选。
选择依据
如果主要用于交互式请求,Nemotron-3.5 Lightning 模型卡将 DSpark 列为 DGX Spark 以及低并发、延迟敏感型服务的默认推荐。某些任务可能更适合关闭加速或使用 DFlash、MTP,因此宜调整候选 token 数进行比较。如果目标是数据中心批处理吞吐量,NVIDIA 在 Nemotron-3.5 Lightning 模型卡中指出,1× H100 最大吞吐量批处理下,vLLM 与 humming 后端配置不使用 speculative decoding 时最快。此建议针对 H100 批处理。
在本地运行
教程以 CUDA 13·TensorRT 10.16.1.11·Python 3.10~3.12 环境为前提。在可访问系统包的虚拟环境中安装 tensorrt-edgellm[server]==0.11.1 后,使用以下命令开始对话。
trtedge chat nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4本地 API 通过指定相同模型 ID 的 trtedge serve 启动。可用相同请求,对比关闭加速的基准值与启用 3个候选 token 时的结果。
生成阶段的提速收益与首次响应等待时间是两回事,因此评估本地对话的加速效果时,宜分别考察这两项指标。