NVIDIAが2026年10月30日に公開したチュートリアルは、数個のコマンドでローカルのOpenAI互換APIサーバーを起動し、クラウドAPIの代わりに機器上でエージェントを試す手順を紹介している。候補トークンを先に提案する高速化機能を有効にした同社の測定では、最初の応答までの待ち時間はほぼ変わらなかったが、その後の文章の生成速度は向上した。
対象はDGX Spark 64GBで実行したNemotron-3.5 Lightningだ。以下の数値はいずれもNVIDIAの発表に基づく。
結果
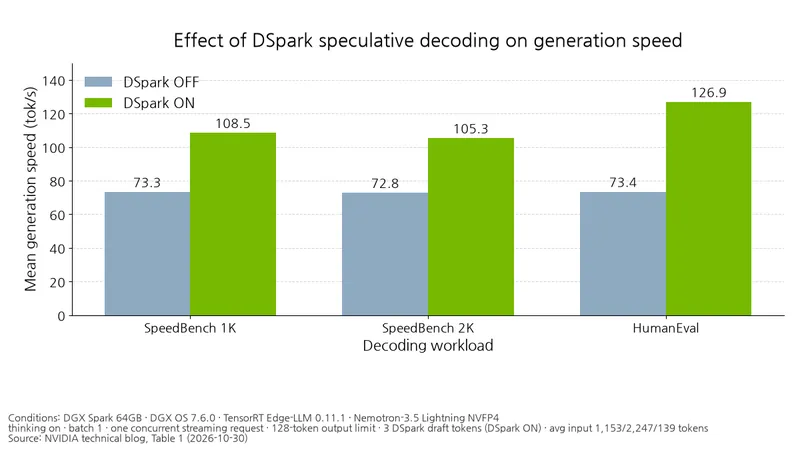
条件:DGX Spark 64GB・DGX OS 7.6.0(Ubuntu 24.04.4 LTS)・Edge-LLM 0.11.1・Nemotron-3.5 Lightning 30B-A3B NVFP4(4ビット浮動小数点量子化)。推論過程を実行するthinking設定が有効、バッチサイズ1、同時ストリーミング1件、出力上限128トークン、DSpark使用時の候補トークンは3個。平均入力は表の順に1,153/2,247/139トークン。出典はNVIDIA技術ブログの表1。
表:DSparkの使用有無による生成速度と最初のトークンの遅延
単位:生成速度 tok/s、最初のトークンの遅延 ms
| デコーディングのワークロード | DSpark未使用時の平均生成速度 | DSpark使用時の平均生成速度 | DSpark未使用時の最初のトークンの遅延中央値 | DSpark使用時の最初のトークンの遅延中央値 |
|---|---|---|---|---|
| SpeedBench 1K | 73.3 | 108.5 | 201.0 | 203.0 |
| SpeedBench 2K | 72.8 | 105.3 | 329.5 | 331.6 |
| HumanEvalプロンプト | 73.4 | 126.9 | 98.1 | 98.7 |
表の値から計算すると、HumanEvalの生成速度は73.4→126.9 tok/sと約72.9%、2つのSpeedBenchの結果は約44.6~48.0%向上した。一方、最初のトークンまでの時間(TTFT)の中央値の差はいずれも2.1ms以内だった。生成速度は最初のトークンまでの時間を除いた値なので、改善は最初の応答よりも、その後のトークンをつなぐ区間に集中していた。
入力が最も長いSpeedBench 2KでTTFTが最も長く、HumanEvalで最も短い。DSparkを有効にしてもこの順序は変わらず、候補トークンの検証を追加するコストが最初のトークンの遅延を大きく増やすことはなかった。
機器・方式別の性能ドキュメント比較
条件:TensorRT Edge-LLM 0.10.0ランタイムのスループットダッシュボード、llm_inferenceによる測定、Nemotron-3.5-Lightning-30B-A3B NVFP4、バッチサイズ1、入力処理区間66トークン。出典はNVIDIA公式の性能ドキュメント。
表:推論高速化方式・機器別の生成速度と平均採用長
単位:生成速度 tok/s、平均採用長 トークン/検証ステップ
| 推論高速化方式 | DGX Spark (GB10)の生成速度 | 平均採用長 | Jetson AGX Thorの生成速度 | 平均採用長 |
|---|---|---|---|---|
| 通常生成 | 75.6 | — | 81.6 | — |
| MTP | 93.2 | 2.70 | 95.3 | 2.69 |
| DFlash | 61.5 | 2.23 | 58.7 | 2.22 |
MTPは次の複数のトークンを予測するよう学習させる手法で、DFlashはドラフトモデルで候補のまとまりを一括生成する方式だ。平均採用長は検証1回あたりに採用されたトークン数を指す。MTPは両機器とも通常生成より速かったが、DFlashは遅かった。採用されたトークン数だけでなく候補の生成・検証コストも速度向上を左右するため、採用長と最終的な生成速度を併せて見る必要がある。
なぜこのような差が生じるのか
DSparkを有効にしたときに減るのは、メインモデルを繰り返し実行する回数だ。ドラフトモデルが候補トークンのまとまりを先に提案し、メインモデルがそれを一度に検証するためだ。
選ぶ際の基準
対話型リクエストが主な目的なら、Nemotron-3.5 Lightningのモデルカードは、DGX Sparkや低同時実行数で遅延に敏感なサービングにDSparkを標準で推奨している。タスクによっては高速化を無効にしたり、DFlash・MTPを使ったりする方が適する場合もあるため、候補トークン数を変えて比較するのがよい。データセンターのバッチスループットが目的の場合、NVIDIAは同モデルカードで、1× H100の最大スループット向けバッチにおけるvLLMとhummingバックエンドの構成は、speculative decodingを使わない方が最も速いと案内している。この推奨はH100のバッチ処理に関するものだ。
ローカルで実行する
チュートリアルはCUDA 13・TensorRT 10.16.1.11・Python 3.10~3.12の環境を前提としている。システムパッケージにアクセスできる仮想環境にtensorrt-edgellm[server]==0.11.1をインストールした後、次のコマンドで対話を始める。
trtedge chat nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4ローカルAPIは同じモデルIDを指定したtrtedge serveで起動する。同じリクエストで、高速化を無効にした基準値と候補トークン3個を有効にした結果を比較できる。
生成区間を高速化する利点と最初の応答を待つ時間は別なので、ローカル対話の高速化効果は2つの指標を分けて判断するのがよい。