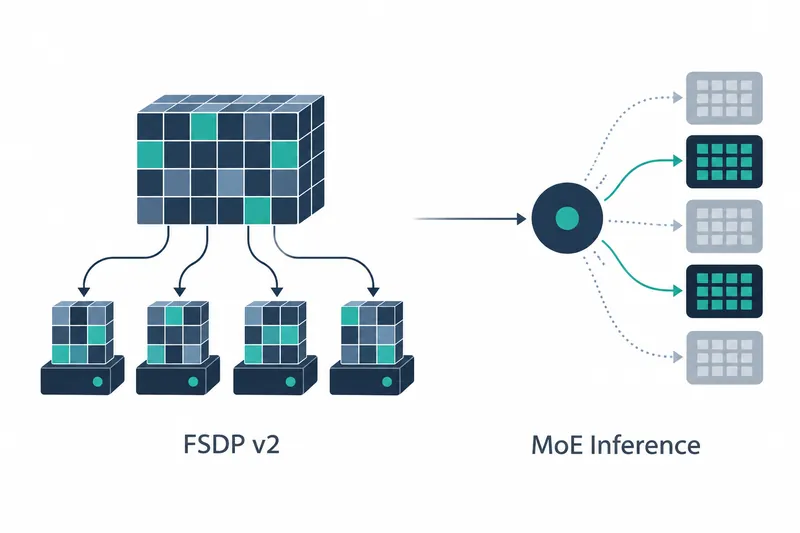
NVIDIA가 대형 모델을 여러 장치에 나눠 학습하고 서비스하는 개발팀을 위한 Megatron Core 0.20.0을 공개했다. 학습에서는 모델을 나눠 맡기는 구성을 더 세밀하게 고를 수 있고, 추론에서는 함께 처리하는 요청 묶음이 바뀌어도 출력이 일정하게 유지되는 실행 경로를 추가했다.
1. 모델을 나눠 맡기는 학습 구성을 세밀화했다
핵심은 실험 단계인 Megatron-FSDP v2 어댑터, 기존 학습 체계에 기능을 잇는 모듈이다. FSDP는 학습에 필요한 상태를 여러 장치에 나눠 보관하는 방식으로, 이번 어댑터는 입력 문맥·전문가 모듈·모델 단계별로 일을 나누는 병렬화와 하이브리드 데이터 병렬 분할을 지원한다. Megatron Bridge 통합도 함께 추가됐다.
하이브리드 FSDP에서는 장치 간 연결망인 NVLink로 묶인 영역의 안쪽과 바깥쪽에 서로 다른 분할 수준을 지정할 수 있다. 모델 전체를 고르게 계산하는 밀집 구간과 일부 전문가 모듈을 골라 계산하는 혼합 전문가 구간에도 별도 설정을 줄 수 있다. 하드웨어 연결 구조와 모델 구간에 맞춰 분할 방식을 각각 고르는 구성이다.
학습 상태의 저장과 복원도 통합 대상이다. PyTorch 분산 체크포인트 방식으로 모델과 옵티마이저 상태를 저장하고 불러오는 경로가 추가됐다. 옵티마이저는 학습 중 가중치를 갱신하는 구성 요소이므로, 이 변경은 모델뿐 아니라 학습을 이어가는 데 필요한 상태를 함께 다루는 데 의미가 있다.
2. 요청 묶음이 달라져도 MoE 계산을 일정하게 한다
혼합 전문가 모델인 MoE의 추론에는 배치 불변 실행이 들어갔다. 같은 요청이 어떤 다른 요청과 묶여 처리되느냐에 따라 계산 결과가 흔들리는 일을 막는 경로다. 지원 정밀도는 BF16, 16비트 부동소수점 형식과 MXFP8, 마이크로스케일링 8비트 수 형식이며, 대상에는 vLLM의 융합 전문가 연산, 여러 연산을 합쳐 수행하는 방식과 전문가 행렬곱, 전문가 가중치를 행렬로 곱하는 계산이 포함된다.
요청별 난수 시드 처리도 보강했다. 난수 생성의 출발값을 지정한 요청은 배치 구성이나 요청 이동, 다른 요청의 난수 소비에 영향을 받지 않도록 했다. 전문가 계산의 일관성과 함께, 요청을 섞어 처리하는 서비스에서 결과를 재현하는 데 중요한 변경이다.
추론 엔진에서는 전문가 텐서 병렬화도 지원한다. 전문가 내부의 텐서 계산을 여러 장치에 나누는 방식이다. 학습 어댑터와 별도로 추론 엔진의 병렬 실행 선택지가 추가됐다는 점에서, 학습 구성과 서비스 구성을 각각 검토할 근거가 생겼다.
3. 연산 효율의 이익은 구성 검토 부담과 함께 온다
새 학습 어댑터는 MXFP8 연산과 양자화된 파라미터 수집, 혼합 정밀도, 여러 수 정밀도를 함께 쓰는 옵티마이저를 지원한다. 양자화는 수를 더 적은 비트로 표현하는 방식이다. 메모리와 연산 효율을 겨냥한 선택지가 늘어난 만큼, 도입팀은 정밀도뿐 아니라 병렬화와 상태 복원 경로까지 함께 맞춰야 한다.
이 구성 검토에는 구체적인 조건이 있다. 어댑터의 텐서 병렬 크기와 전문가 텐서 병렬 크기는 각각 1이어야 하며, 옵티마이저 체크포인팅은 현재 전문가 병렬 레이아웃을 제외한다.
지원되는 밀집 모델 구성에는 학습 반복 전체를 CUDA 그래프로 캡처하고 재생하는 기능도 추가됐다. GPU 작업 순서를 묶어 다시 실행하는 경로다. 추론에서는 vLLM 전문가 행렬곱 버퍼를 유지해 그래프 실행에 활용하도록 했으며, 회사 발표 기준 융합 MoE 경로의 성능 개선도 릴리스 변경 목록에 포함됐다.
4. 저장과 연결 처리 때문에 추론이 막히는 일을 줄였다
운영 측면에서는 생성된 토큰을 저장용으로 준비하는 작업을 추론 루프 밖으로 옮겼다. 느린 체크포인트 쓰기가 디코딩을 멈추게 하던 경로를 손본 것이다. 결과 저장을 처리하면서도 생성 작업을 이어가는 데 초점을 맞춘 변경이다.
HTTP 프런트엔드는 데이터 병렬 크기에 맞춰 확장되며, 토큰화, 텍스트를 모델 입력 단위로 나누는 작업도 요청 처리를 조율하는 이벤트 루프 밖으로 옮겼다. 여러 요청을 받는 입구와 실제 추론 실행 사이의 처리 흐름을 개선하는 작업이다.
클라이언트 연결이 끊기면 해당 요청의 생성도 중단한다. 사용자가 떠난 뒤에도 남은 작업이 처리 용량을 차지하는 상황을 막기 위한 조치다. 배치 불변 실행이 출력의 재현성을 다룬다면, 이 변경은 서비스가 쓰는 처리 용량을 관리하는 쪽에 가깝다.
이번 릴리스의 도입 가치는 학습팀에는 분할 구성의 유연성에, 추론팀에는 요청 묶음과 운영 흐름이 달라져도 서비스를 일관되게 실행하는 데 있다.