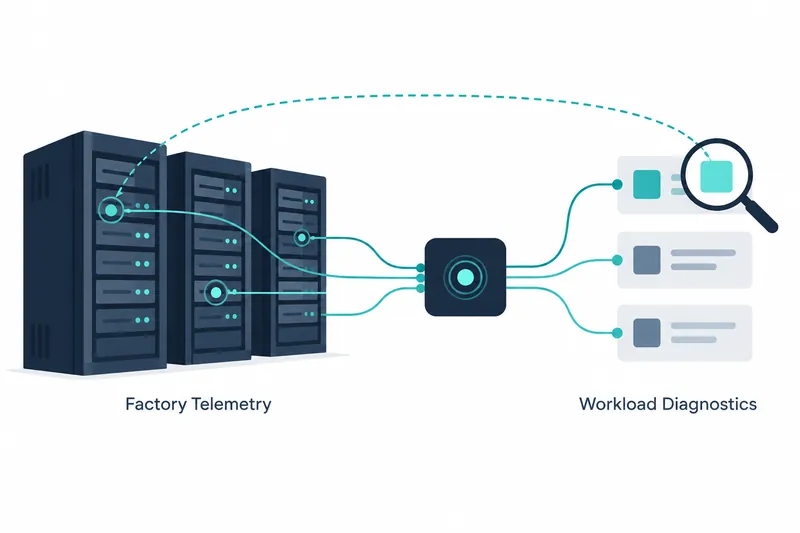
NVIDIA의 Minerva는 GPU와 네트워크, 스토리지, 작업 스케줄러의 신호를 한데 모아 어떤 작업이 영향을 받는지 보여주는 운영 플랫폼이다. AI 공장 운영자는 장비별 경보를 따로 뒤지는 대신 작업의 성능 저하와 관련된 장비·경로를 함께 살펴 원인 조사와 대응을 시작할 수 있다.
1. 장비 상태에서 작업 영향으로
분산 학습, 여러 장치가 나눠 계산하는 학습은 가장 느린 장치의 속도에 맞춰 진행된다. 장치가 완전히 멈추지 않아도 부하 중에만 나타나는 미세한 오류가 전체 작업을 늦출 수 있고, 한 결함이 여러 장비의 신호와 경보로 번지기도 한다.
Minerva는 GPU, 스위치, 네트워크 카드, 저장 장치와 스케줄러 등에서 메트릭, 수치로 기록한 상태 측정값과 로그, 연결 정보를 수집한다. 자동으로 관계를 찾아 장비와 작업의 연결 지도인 지식 그래프를 만들며, NVIDIA 기술 블로그는 시간당 수십억 개의 메트릭·로그 데이터 점을 처리한다고 설명한다.
이 구조에서는 이상 인터페이스에서 해당 노드와 네트워크 경로, 영향받는 작업으로 범위를 좁힐 수 있다. 반대로 작업 식별자에서 GPU와 호스트, 네트워크 장비, 관련 로그를 따라가며 조사할 수도 있다. 기존의 장비별 화면을 넘나드는 대신 작업을 중심에 놓는 방식이다.
2. 알려진 오류와 낯선 이상을 함께 탐지
지도 학습 모델은 이미 알려진 중요 오류를 찾아 조치 안내와 연결하고, 비지도 모델, 정답 없이 데이터의 패턴을 찾는 모델은 정해진 오류 서명, 오류를 구별하는 고유한 패턴이 없는 동작을 같은 종류의 장비와 비교한다. 온도와 전력, 클록, 사용률, 작업 상태를 함께 살피면 사양 범위 안에 있는 값이라도 동료 장치와 다른 열화를 포착할 수 있다. 로그에서도 자연어 처리 기반 탐지가 처음 나타난 패턴을 찾아낸다.
회사 발표 기준, 여러 노드에 걸친 학습 작업이 동시에 실행되던 데이터센터에서 약 40만 개 인터페이스 중 대역폭이 떨어진 NVLink 연결 하나를 찾아 영향받은 작업을 확인했다. 진단은 몇 시간이 아닌 몇 분 만에 이뤄졌으며, 운영팀은 문제 노드를 작업 배정에서 빼고 작업을 재배치한 뒤 링크를 격리해 수리했다.
3. 여러 경보를 한 사건으로 묶는다
장비의 연결 구조를 이용하는 상관관계 엔진, 연결된 신호를 묶어 원인을 찾는 기능은 의존 경로, 한 장비의 상태가 영향을 주는 연결 경로가 같은 이벤트와 이상을 하나의 장애 사건으로 묶는다. NVIDIA는 지원 시나리오에서 알림과 티켓이 크게 줄었다고 밝혔다. 운영자는 작은 조사 범위에서 원인을 확인한 뒤 플랫폼 화면이나 기존 업무 흐름으로 대응을 이어갈 수 있다.
회사 발표 기준, 스위치 재시작으로 혼잡이 번진 사례에서 수신 일시정지 프레임 등 81개 이벤트와 이상이 하나의 장애 사건으로 묶였다. NVIDIA는 이를 통해 수리 시간을 줄이고 클러스터 가동 시간을 약 54시간 절약한 것으로 추정했다.
다른 사례에서는 저전력 상태에서 깨어나지 못한 NVMe 저장 장치가 입출력 오류를 일으켜 해당 노드의 작업들을 늦췄다. 회사 발표 기준, 원인을 찾아 노드를 작업 배정에서 제외하고 고장 장비를 반송한 조치로 절약한 작업 실행 시간은 추정 5,530시간이다.
대화형 도우미 Sherlock은 실시간 원격 측정과 지식 그래프를 바탕으로 특정 작업의 지연 이유나 상태가 바뀐 장비를 질문할 수 있게 한다. 외부 AI 도구도 MCP 서버를 통해 같은 운영 정보를 조회할 수 있다.
4. 현장 수집과 중앙 분석, 도입 조건
수집기 스택은 감시 장비에 직접 접근해야 하므로 현장에 둔다. 데이터를 끌어오거나 밀어 넣는 방식을 지원하고, 플랫폼 스택은 관계 모델링과 보강, 기계학습, 저장 및 표시를 맡는다. 데이터 홀마다 수집기를 두고 플랫폼을 별도로 운영하는 구성도 가능하다.
1.0.1 가이드는 테스트 클러스터의 노드별 최소 조건으로 가상 CPU 64개, 메모리 128GB, 디스크 1TB를 제시한다. 이 조건은 단일 랙 또는 Spectrum 스위치 10대와 통합한 테스트 환경 기준이다.
다만 해당 버전 릴리스 노트는 클라우드·서비스형 배포를 지원하지 않는다고 밝힌다. 외부 도구 연결용 MCP 서버는 베타 기능이며 조회 전용이다.
이 접근은 흩어진 데이터와 경보를 작업 맥락에 붙여 조사 시간을 줄이는 대신, 현장 수집 인프라와 저장·처리 자원 관리를 요구한다. 보존 설정과 데이터량에 따라 필요한 자원도 늘어난다.
다음은 네트워크 모델에 등록된 장비를 유지보수 상태로 표시하는 가이드의 요청 예시다.
curl --request PUT \
--url "https://<platform-host>/minerva/api/v2/network/leaf01" \
--header "Content-Type: application/json" \
--header "X-Api-Key: <api-key>" \
--data '{"status":{"admin_state":"MAINTENANCE"}}'
5. 데이터 종류에 따라 다른 보관 기간
가이드의 수집 현황 문서는 데이터 종류별 일반 보관 기간을 제시한다. 일반 메트릭·이벤트 저장소가 가장 길고, 패킷 단위 이벤트 저장소가 가장 짧아 조사할 데이터의 종류에 따라 과거 기록을 볼 수 있는 범위가 달라진다.
표: 데이터 저장소별 일반 보관 기간
조건: NVIDIA Minerva 1.0.1 가이드의 데이터 소스별 일반 보관 기간
단위: 일
| 데이터 저장소 | 보관 기간 |
|---|---|
| 일반 메트릭·이벤트(raw_v1) | ~120 |
| 패킷 단위 폐기 이벤트(packet_v1) | ~7 |
| 시스템 로그 기반 시계열(syslog_v1) | ~30 |
| 구성 요소·큐·링크 등(system_v1) | ~10 |
| 인터페이스별 메트릭(interface_v1) | ~10 |
Minerva의 핵심 가치는 장비 신호를 작업 영향과 연결해 AI 공장의 고장 조사를 더 좁고 빠르게 시작하게 하는 데 있다.