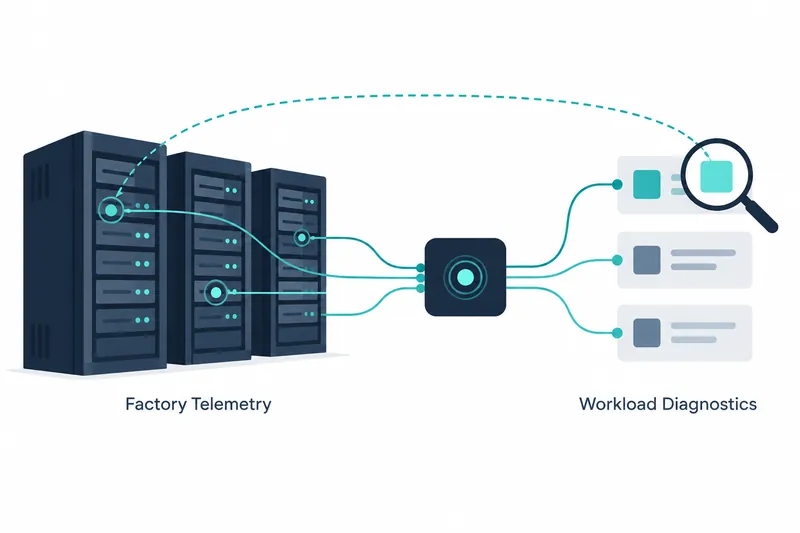
NVIDIAのMinervaは、GPU、ネットワーク、ストレージ、ジョブスケジューラーの信号を集約し、どのジョブが影響を受けているかを示す運用プラットフォームだ。AIファクトリーの運用者は、機器ごとのアラートを個別に探す代わりに、ジョブの性能低下に関係する機器や経路を併せて確認し、原因調査と対応を始められる。
1. 機器の状態からジョブへの影響へ
分散学習、つまり複数のデバイスで計算を分担する学習は、最も遅いデバイスの速度に合わせて進む。デバイスが完全に停止しなくても、負荷時にだけ現れる微細なエラーがジョブ全体を遅らせる場合があり、1つの不具合が複数の機器の信号やアラートに波及することもある。
MinervaはGPU、スイッチ、ネットワークカード、ストレージ機器、スケジューラーなどから、状態を数値で記録したメトリクスやログ、接続情報を収集する。関係を自動で見つけ、機器とジョブのつながりを示すナレッジグラフを構築する。NVIDIAの技術ブログによると、1時間に数十億のメトリクス・ログのデータポイントを処理する。
この構造では、異常のあるインターフェースから該当ノードやネットワーク経路、影響を受けるジョブへと範囲を絞れる。逆に、ジョブ識別子からGPU、ホスト、ネットワーク機器、関連ログをたどって調査することもできる。従来の機器別画面を行き来する代わりに、ジョブを中心に据える方式だ。
2. 既知のエラーと未知の異常を併せて検知
教師あり学習モデルは既知の重要なエラーを見つけ、対処案内に結び付ける。正解データなしでパターンを探す教師なしモデルは、エラーを識別する固有のパターンである既定のエラーシグネチャがない動作を、同種の機器と比較する。温度、電力、クロック、使用率、ジョブの状態を併せて調べると、仕様範囲内の値でも同種のデバイスと異なる劣化を捉えられる。ログでも、自然言語処理に基づく検知が初出のパターンを見つける。
同社の発表によると、複数ノードにまたがる学習ジョブが同時に実行されていたデータセンターで、約40万のインターフェースから帯域幅が低下したNVLink接続を1つ見つけ、影響を受けたジョブを特定した。診断は数時間ではなく数分で完了し、運用チームは問題のノードをジョブ割り当てから外してジョブを再配置した後、リンクを隔離して修理した。
3. 複数のアラートを1つのインシデントに集約
機器の接続構造を利用する相関エンジンは、関連する信号をまとめて原因を探す機能だ。ある機器の状態が影響を及ぼす依存経路が同じイベントや異常を、1つの障害インシデントにまとめる。NVIDIAは、対応シナリオで通知とチケットが大幅に減ったと述べた。運用者は絞られた調査範囲で原因を確認し、プラットフォームの画面や既存の業務フローで対応を続けられる。
同社の発表によると、スイッチの再起動で輻輳が広がった事例では、受信ポーズフレームなど81件のイベントと異常が1つの障害インシデントにまとめられた。NVIDIAは、これにより修理時間を短縮し、クラスターの稼働時間を約54時間節約したと推定した。
別の事例では、低電力状態から復帰できなかったNVMeストレージ機器が入出力エラーを起こし、該当ノードのジョブを遅らせた。同社の発表によると、原因を突き止めてノードをジョブ割り当てから除外し、故障機器を返送した措置により節約したジョブ実行時間は、推定5,530時間だ。
対話型アシスタントSherlockでは、リアルタイムのテレメトリーとナレッジグラフに基づき、特定のジョブが遅れる理由や状態が変わった機器について質問できる。外部のAIツールもMCPサーバーを通じて同じ運用情報を照会できる。
4. 現場での収集と中央での分析、導入条件
コレクタースタックは監視対象機器に直接アクセスする必要があるため、現場に配置する。データのプル方式とプッシュ方式に対応し、プラットフォームスタックは関係のモデリングと補強、機械学習、保存、表示を担う。データホールごとにコレクターを配置し、プラットフォームを別に運用する構成も可能だ。
1.0.1ガイドは、テストクラスターのノードごとの最小要件として、仮想CPU 64個、メモリー128GB、ディスク1TBを示す。この条件は、単一ラックまたはSpectrumスイッチ10台と統合したテスト環境を基準としている。
ただし、同バージョンのリリースノートは、クラウド・サービス型のデプロイに対応していないと明記する。外部ツール接続用のMCPサーバーはベータ機能で、照会専用だ。
このアプローチは、分散したデータやアラートをジョブの文脈に結び付けて調査時間を短縮する一方、現場の収集インフラと保存・処理リソースの管理を求める。保持設定とデータ量に応じて必要なリソースも増える。
以下は、ネットワークモデルに登録された機器をメンテナンス状態にする、ガイドのリクエスト例だ。
curl --request PUT \
--url "https://<platform-host>/minerva/api/v2/network/leaf01" \
--header "Content-Type: application/json" \
--header "X-Api-Key: <api-key>" \
--data '{"status":{"admin_state":"MAINTENANCE"}}'
5. データの種類で異なる保持期間
ガイドの収集状況に関する文書は、データの種類ごとに一般的な保持期間を示す。一般メトリクス・イベントのストアが最も長く、パケット単位のイベントストアが最も短いため、調査するデータの種類によって過去の記録を参照できる範囲が異なる。
表:データストア別の一般的な保持期間
条件:NVIDIA Minerva 1.0.1ガイドのデータソース別の一般的な保持期間
単位:日
| データストア | 保持期間 |
|---|---|
| 一般メトリクス・イベント(raw_v1) | ~120 |
| パケット単位の破棄イベント(packet_v1) | ~7 |
| システムログに基づく時系列(syslog_v1) | ~30 |
| コンポーネント・キュー・リンクなど(system_v1) | ~10 |
| インターフェース別メトリクス(interface_v1) | ~10 |
Minervaの中核的な価値は、機器の信号をジョブへの影響と結び付け、AIファクトリーの障害調査を、より絞られた範囲で素早く始められる点にある。