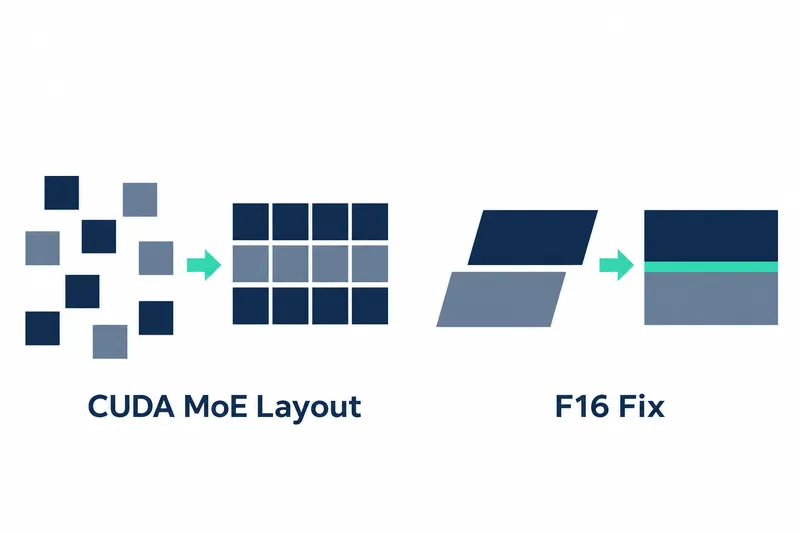
llama.cpp가 여러 전문가로 계산을 나누는 인공지능 모델의 GPU 처리 효율을 높인 새 버전을 공개했다. 해당 모델을 실행하는 개발자는 작업 배치 개선과 함께 반정밀도 연산의 성능 저하 수정도 적용할 수 있다.
1. 전문가별 작업을 타일 단위로 재배치
이번 변경은 CUDA에서 혼합 전문가 모델의 행렬곱, 행과 열로 배열된 수를 곱하는 연산을 실행할 때, 보조 연산이 타일이라는 작은 계산 묶음을 미리 배정하도록 한다. 전문가별로 계산 범위만 전달하던 방식보다 주 연산이 맡을 타일 수와 부대 작업을 줄이고, 전문가 사이의 작업 배분도 유연하게 만든다.
2. 중형 혼합 전문가 모델에서 확인된 처리량
변경 제안(PR) 작성자 설명에 따르면 데이터 배치 변경 자체의 성능 개선 폭은 2~4%이며, 나머지는 더 작은 타일로 계산 낭비를 줄인 데서 나온다. 이전에 일부 그래픽 처리 장치에만 적용하던 작은 타일 선호 최적화도 더 넓은 GPU에 적용했다.
아래는 PR 작성자가 공개한 중형 모델 측정값의 일부다. 모델은 gemma4 26B.A4B이며 양자화, 모델 수치 정밀도를 낮추는 과정은 Q4_0이다.
프롬프트 8192토큰 처리 시험에서 한 번에 나누어 처리하는 묶음 크기인 마이크로배치를 64로 맞췄다. 표는 기존 master와 변경판 bea596f39을 비교한 것으로, 각 GPU가 자기 기준값에서 얼마나 달라졌는지를 보여준다.
표: GPU별 중형 혼합 전문가 모델 처리량
조건: gemma4 26B.A4B Q4_0, pp8192, 마이크로배치 64, master와 bea596f39 비교(PR 벤치마크 표)
단위: 처리량은 초당 토큰(t/s), 속도 향상은 배
| GPU | master | bea596f39 | 속도 향상 |
|---|---|---|---|
| MI60 / MI50 | 453.58 | 649.18 | 1.43 |
| MI100 | 765.78 | 962.42 | 1.26 |
| P40 | 428.34 | 600.66 | 1.40 |
| RTX 3090 | 1611.88 | 1950.45 | 1.21 |
| RTX 4090 | 3785.17 | 3906.79 | 1.03 |
| RTX 5090 | 4690.15 | 4870.64 | 1.04 |
| RX 6800 | 408.49 | 601.58 | 1.47 |
| RX 9060 XT | 920.30 | 936.63 | 1.02 |
| Strix Halo | 631.28 | 647.92 | 1.03 |
| V100-PCIE-32GB | 625.76 | 625.11 | 1.00 |
같은 모델과 설정에서 RX 6800은 기존 대비 1.47배, MI60 / MI50는 1.43배를 기록했다. 표에 함께 실린 다른 장치 중에는 변화가 작은 경우도 있어, 이 최적화의 효과가 하드웨어에 따라 달라지는 양상을 보였다.
3. F16 성능 저하는 빈 작업을 건너뛰어 수정
PR 검토에서 반정밀도(F16) 연산의 성능 저하가 보고됐고, 제안된 수정은 배정된 열이 없는 전문가의 계산 작업을 즉시 끝내도록 했다. 변경 코드는 다음과 같다.
    const int expert_end   = ts.col_high;
    const int ncols_expert = expert_end - expert_start;

    if (ncols_expert == 0) {
        return;
    }

    GGML_UNUSED(channel_ratio);
아래는 작은 혼합 전문가 모델에서 성능 저하가 나타났던 측정값으로, 기존 대비 배율이 1보다 낮다.
표: F16 수정 전의 처리량 저하 사례
조건: granitemoe 3B.A800M F16, pp8192, 마이크로배치 32, master와 bea596f39 비교(PR 벤치마크 표)
단위: 처리량은 초당 토큰(t/s), 속도 향상은 배
| GPU | master | bea596f39 | 속도 향상 |
|---|---|---|---|
| RTX 3090 | 2655.92 | 2111.88 | 0.80 |
| RTX 4090 | 3686.06 | 3096.57 | 0.84 |
빈 작업을 건너뛰는 수정은 비교 대상 bea596f39 이후에 추가돼, 이 표는 수정 전 결과다. PR 작성자는 Granite 3.0에서 후속 보정 연산(fixup kernel)의 실행 여부가 전체 시간에 큰 영향을 줘 측정값 변동이 크다고 설명했다.
4. 이득과 비용을 함께 볼 필요
작은 타일은 계산 범위에 맞춰 작업을 더 촘촘히 배정해 낭비를 줄인다. 대신 새 배치 정보를 미리 계산하고 저장하는 일이 보조 연산으로 옮겨간다. 변경 코드도 전문가별 계산 범위 대신 타일별 정보를 담을 임시 메모리를 할당하는 구조다.
전문가로 계산을 나누지 않는 밀집 모델, 전문가 분기 없이 계산하는 모델의 확인 시험에서는 변화가 작았다. PR의 llama 8B Q4_0 모델, pp1024 시험에서 기존 대비 배율은 0.99~1.03이었다.
이번 개선은 밀집 모델 전반의 속도 향상보다 혼합 전문가 모델의 계산 낭비 감소에 초점을 맞췄다. b12144 릴리스 노트에는 CUDA 변경과 함께 반정밀도 성능 저하 수정이 포함됐다.
b12144는 혼합 전문가 모델의 CUDA 처리를 개선하고 F16 회귀를 고친 릴리스로, 체감 성능은 GPU와 모델 조건에 맞춰 판단해야 한다.