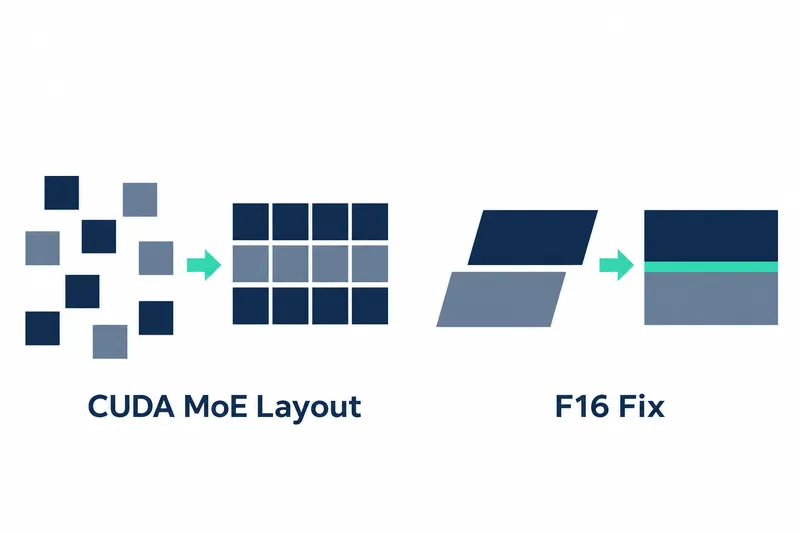
llama.cppは、複数のエキスパートに計算を分担させるAIモデルのGPU処理効率を高めた新バージョンを公開した。このモデルを実行する開発者は、作業配置の改善とともに半精度演算の性能低下の修正も適用できる。
1. エキスパート別の作業をタイル単位で再配置
今回の変更では、CUDAで混合エキスパートモデルの行列積、つまり行と列に並べた数の乗算を実行する際、補助演算がタイルという小さな計算単位を事前に割り当てる。エキスパート別に計算範囲だけを渡す方式より、主演算が担うタイル数と付随作業を減らし、エキスパート間の作業配分も柔軟にする。
2. 中規模の混合エキスパートモデルで確認されたスループット
変更提案(PR)の作成者によると、データ配置の変更自体による性能改善幅は2~4%で、残りはより小さなタイルで計算の無駄を減らしたことによる。従来は一部のGPUだけに適用していた、小さなタイルを優先する最適化も、より幅広いGPUに適用した。
以下はPR作成者が公開した中規模モデルの測定値の一部である。モデルはgemma4 26B.A4Bで、モデルの数値精度を下げる量子化方式はQ4_0である。
プロンプト8192トークンの処理試験で、一度に分割処理するまとまりの大きさであるマイクロバッチを64に設定した。表は従来のmasterと変更版bea596f39を比較し、各GPUが自身の基準値からどれだけ変化したかを示す。
表:GPU別の中規模混合エキスパートモデルのスループット
条件:gemma4 26B.A4B Q4_0、pp8192、マイクロバッチ64、masterとbea596f39の比較(PRベンチマーク表)
単位:スループットは毎秒トークン(t/s)、速度向上は倍
| GPU | master | bea596f39 | 速度向上 |
|---|---|---|---|
| MI60 / MI50 | 453.58 | 649.18 | 1.43 |
| MI100 | 765.78 | 962.42 | 1.26 |
| P40 | 428.34 | 600.66 | 1.40 |
| RTX 3090 | 1611.88 | 1950.45 | 1.21 |
| RTX 4090 | 3785.17 | 3906.79 | 1.03 |
| RTX 5090 | 4690.15 | 4870.64 | 1.04 |
| RX 6800 | 408.49 | 601.58 | 1.47 |
| RX 9060 XT | 920.30 | 936.63 | 1.02 |
| Strix Halo | 631.28 | 647.92 | 1.03 |
| V100-PCIE-32GB | 625.76 | 625.11 | 1.00 |
同じモデルと設定で、RX 6800は従来比1.47倍、MI60 / MI50は1.43倍を記録した。表に掲載された他のデバイスには変化が小さいものもあり、この最適化の効果がハードウェアによって異なる傾向を示した。
3. F16性能低下は空の作業をスキップして修正
PRレビューで半精度(F16)演算の性能低下が報告され、提案された修正では、列が割り当てられていないエキスパートの計算作業を即座に終了するようにした。変更コードは次のとおりである。
    const int expert_end   = ts.col_high;
    const int ncols_expert = expert_end - expert_start;

    if (ncols_expert == 0) {
        return;
    }

    GGML_UNUSED(channel_ratio);
以下は小規模の混合エキスパートモデルで性能低下が現れた測定値で、従来比の倍率が1を下回っている。
表:F16修正前のスループット低下の例
条件:granitemoe 3B.A800M F16、pp8192、マイクロバッチ32、masterとbea596f39の比較(PRベンチマーク表)
単位:スループットは毎秒トークン(t/s)、速度向上は倍
| GPU | master | bea596f39 | 速度向上 |
|---|---|---|---|
| RTX 3090 | 2655.92 | 2111.88 | 0.80 |
| RTX 4090 | 3686.06 | 3096.57 | 0.84 |
空の作業をスキップする修正は比較対象のbea596f39より後に追加されたため、この表は修正前の結果である。PR作成者は、Granite 3.0では後続の補正演算(fixup kernel)の実行有無が全体の時間に大きく影響し、測定値の変動が大きいと説明した。
4. 利点とコストを併せて見る必要
小さなタイルは、計算範囲に合わせて作業をより細かく割り当て、無駄を減らす。一方、新しい配置情報を事前に計算して保存する作業は補助演算に移る。変更コードも、エキスパート別の計算範囲ではなく、タイル別の情報を格納する一時メモリを確保する構造である。
エキスパートに計算を分担させず、エキスパートへの分岐なしで計算する密なモデルの確認試験では、変化は小さかった。PRのllama 8B Q4_0モデルのpp1024試験では、従来比の倍率は0.99~1.03だった。
今回の改善は、密なモデル全般の高速化よりも、混合エキスパートモデルの計算の無駄の削減に重点を置いた。b12144のリリースノートには、CUDAの変更とともに半精度演算の性能低下の修正が含まれている。
b12144は混合エキスパートモデルのCUDA処理を改善し、F16の性能リグレッションを修正したリリースであり、体感性能はGPUとモデルの条件に合わせて判断する必要がある。