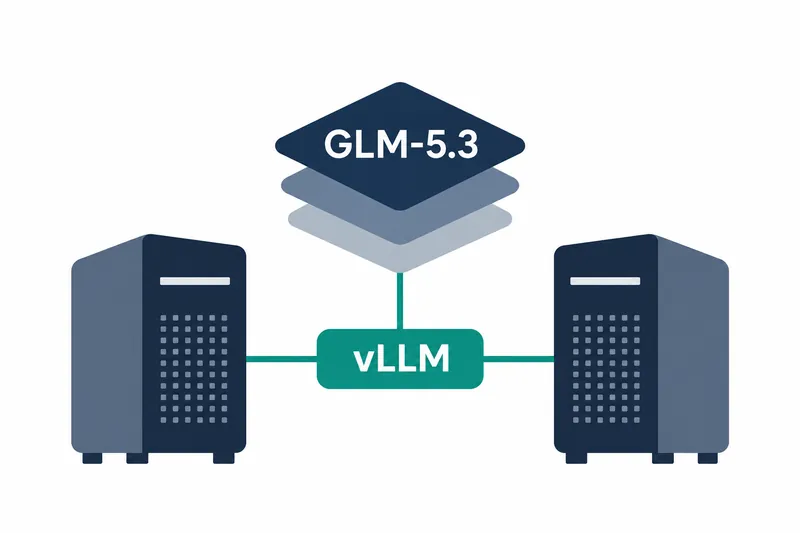
NVIDIA가 두 대의 DGX Station에서 대형 언어 모델 GLM-5.3을 함께 실행하고 하나의 API로 제공하는 절차를 공개했다. GPU 한 장에 들어가지 않는 모델을 두 GPU에 나눠 올려 직접 운영하려는 개발팀은 이 구성을 바탕으로 로컬 추론 서비스를 만들고 동시 요청 성능을 시험할 수 있다.
1. 양자화해도 단일 GPU보다 큰 모델
GLM-5.3 NVFP4는 전체 매개변수가 7530억 개이고 토큰마다 활성화되는 매개변수는 400억 개다. 작업에 맞는 일부만 골라 계산하지만, 선택 후보인 가중치 전체는 메모리에 있어야 한다. NVIDIA 블로그에 따르면 체크포인트 크기는 약 464GB로, GB300 GPU 한 장의 252GB 메모리를 넘는다.
모델 카드, 모델 사양과 사용 정보를 담은 문서는 전문가 혼합 구조, 입력마다 일부 하위 모델을 골라 쓰는 방식의 선형 연산에 4비트 양자화를 적용했다고 설명한다. 해당 가중치와 활성화의 정밀도를 8비트에서 4비트로 낮춰 디스크와 GPU 메모리 요구량을 약 1.66배 줄였다는 것이 NVIDIA의 설명이다.
안내된 구성은 CPU 메모리로 가중치를 넘기는 대신 두 GPU에 가중치와 계산을 나누는 텐서 병렬 방식을 쓴다. 한쪽이 API 요청을 받되 두 기기가 매 요청을 함께 처리하므로, 이용자는 하나의 OpenAI 호환 API에 접속하면 된다.
2. 모델 사본과 고속 연결을 양쪽에 준비
각 Station은 체크포인트, 학습된 모델 상태를 저장한 파일 전체 사본을 디스크에 보관하므로 모델용으로 각각 464GB 이상의 여유 공간이 필요하다. 안내 절차는 한쪽에서 모델을 내려받아 다른 쪽으로 복사하고 파일 목록과 크기를 비교한다. 실제 GPU에 적재할 때 vLLM이 두 GPU에 가중치를 분할한다.
두 기기는 ConnectX-8 연결을 통해 GPU 메모리 사이에서 계산 결과를 직접 주고받는 RDMA 통신을 쓴다. NVIDIA는 연결 속도 400000Mb/s, 큰 패킷의 전송 성공과 시간 동기화를 준비 단계에서 확인하도록 안내한다.
기동 뒤에는 API 상태와 통신 로그를 확인한다. 각 GPU에 올라가는 가중치는 기동 로그 기준 약 218GiB로, 전체 모델의 절반 정도다.
3. 작업자를 먼저 띄우고 단일 API로 요청
안내된 vLLM 0.30.0 구성은 다중 토큰 예측인 MTP로 한 단계에 네 토큰의 초안을 만들고 전체 모델로 검증해 출력을 앞당긴다. 프리픽스 캐싱으로 이미 처리한 프롬프트 앞부분의 재계산도 줄인다.
FP8 KV 캐시는 진행 중인 요청의 문맥을 저장하며, 16비트 저장보다 캐시 메모리를 절반으로 줄인다.
작업자 노드를 먼저 시작하고 API를 제공하는 노드를 나중에 시작한다. 로그에 서비스 시작 완료가 표시되면 상태 검사와 요청으로 응답을 확인한다. 원문의 요청 예시는 두 기기의 컨테이너와 환경 변수 설정을 마친 뒤 사용한다.
docker exec "$CONTAINER" curl -fsS --max-time 120 \
 "http://127.0.0.1:$PORT/v1/chat/completions" \
 -H 'Content-Type: application/json' \
 -d '{"model":"nvidia/GLM-5.3-NVFP4",
 "messages":[{"role":"user","content":"Quarterly units sold: Q1 = 120; Q2 = 180; Q3 = 150. Summarize the trend in one sentence and calculate the percentage change from Q1 to Q2."}],
 "temperature":0,"max_tokens":4096,
 "chat_template_kwargs":{"reasoning_effort":"low"}}' |
python3 -c 'import json,sys; c=json.load(sys.stdin)["choices"][0];
print(c["message"]["content"]); print("finish_reason:",c["finish_reason"])'
예시는 응답 내용과 종료 이유를 함께 출력해 정상 완료 여부를 확인한다. 이 요청의 추론 강도는 낮음이며, 아래 부하 시험은 기본값인 최고 강도로 진행됐다.
4. 동시 요청을 늘리면 처리량과 응답 속도가 엇갈린다
NVIDIA는 AIPerf와 SPEED-Bench Coding 대화 80건으로 부하를 측정했다. 각 단계에서 동시 요청 수의 세 배를 예열 요청으로 보내고 열 배를 측정했으며 예열은 통계에서 제외했다. 출력 토큰에는 답변 전 추론도 포함된다.
아래는 동시 처리 상한을 16으로 고정한 회사 발표 기준 결과다.
표: 동시 처리 상한 16에서 요청 수에 따른 처리량과 지연
조건: GB300 GPU를 갖춘 DGX Station 두 대, GLM-5.3 NVFP4, 텐서 병렬도 2, vLLM 동시 처리 상한 16, 컨텍스트 상한 98304토큰, SPEED-Bench Coding, 프리픽스 캐싱·네 토큰 MTP·FP8 KV 캐시, 추론 강도 max, 출력 상한 8192토큰
단위: 처리량 tok/s, 지연 s
| 동시 요청 수 | 전체 처리량 (tok/s) | 평균 사용자당 처리량 (tok/s) | 평균 요청 지연 (s) |
|---|---|---|---|
| 1 | 107.4 | 115.3 | 49.84 |
| 8 | 386.0 | — | 114.17 |
| 16 | 607.8 | — | 136.46 |
회사 발표 기준으로 이 설정에서 동시 요청 16개의 전체 처리량은 607.8tok/s였다. 동시 요청이 늘수록 전체 처리량은 높아졌지만 평균 지연도 길어졌다. 여러 이용자를 수용하는 능력과 각 이용자가 기다리는 시간 사이의 교환 관계가 드러난다.
동시 처리 상한을 32로 바꾼 별도 시험에서는 동시 요청도 32개로 보냈다. 나머지 조건을 유지한 이 시험의 회사 발표 기준 전체 처리량은 385.0tok/s, 평균 사용자당 처리량은 13.0tok/s, 평균 요청 지연은 453.54초였다.
5. 로컬 실행의 대가는 두 기기와 연결망 운영
두 기기를 묶으면 한 GPU 메모리보다 큰 모델을 로컬에서 실행할 수 있고, NVIDIA는 민감한 데이터의 로컬 추론과 에이전트 실험, 토큰별 이용료 없이 프롬프트를 반복하는 활용을 제시한다. 대신 두 GPU와 연결망을 계속 확보해야 하며 각 Station에 모델 전체 사본을 저장해야 한다. RDMA 연결과 동기화, 네트워크 접근 통제까지 운영 범위에 들어간다.
안내 구성의 API는 기본적으로 인증 없이 요청 수신 기기의 모든 네트워크 인터페이스에 열리므로 외부에 제공하기 전 방화벽과 인증, TLS, 통신 내용을 암호화하는 보안 규약 설정이 필요하다.
GLM-5.3을 두 Station에 나누는 구성은 단일 GPU의 메모리 한계를 넘지만, 처리량 최적점은 부하에 따라 달라져 직접 측정해야 한다.