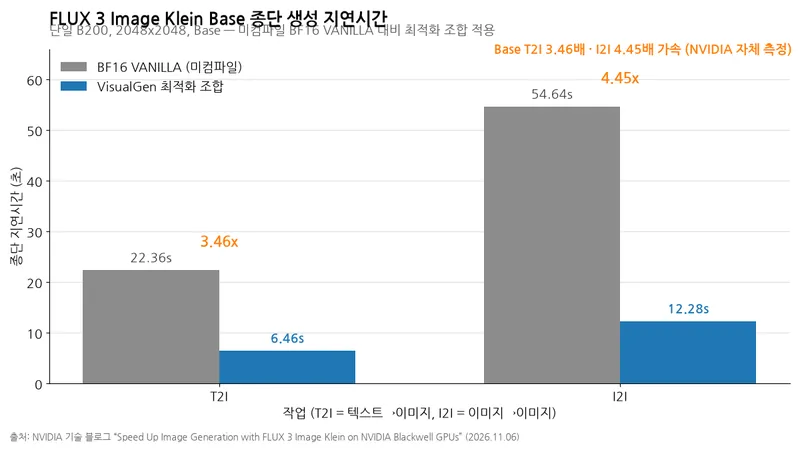
이미지 생성·편집 서버의 대기시간을 줄일 최적화 조합이 공개됐다. NVIDIA 측정에서 FLUX 3 Image Klein Base의 텍스트→이미지 생성은 22.36초에서 6.46초로, 이미지→이미지 편집은 54.64초에서 12.28초로 줄었다. 속도 이득과 함께 기준 출력과의 차이를 나타내는 LPIPS 지표도 붙어 있어 무엇을 포기하는지 비교할 수 있다.
측정 방법
NVIDIA는 2026년 11월 6일 TensorRT LLM의 확산 모델 전용 런타임 VisualGen 튜토리얼을 공개했다. Base 외에 생성 단계를 줄이도록 학습한 단계 축소 모델도 다루며, 이 16스텝 모델의 종단 이득은 최대 2.34배였다.
종단 지연시간은 프롬프트 확장·업샘플링을 제외한 생성 파이프라인 시간이며, LPIPS는 낮을수록 기준 출력에 가깝다. 먼저 잡음을 단계적으로 제거하는 디노이징이 차지하는 시간을 봤다. T2I는 텍스트→이미지 생성, I2I는 이미지 편집이다.
표: FLUX 3 Image Klein 파이프라인 단계별 지연시간
조건: 단일 B200, 2048×2048, NVFP4·VANILLA 어텐션(이미지의 여러 부분 사이에서 필요한 정보를 골라 참조하는 연산)·torch.compile, Base 50스텝·CFG 3.5, 단계 축소 모델 16스텝·CFG 없음, CFG는 정·부정 프롬프트로 조건 강도를 조절하는 방식, 워밍업 2회 후 10회 요청 평균, NVIDIA 자체 측정
단위: ms, s
| 작업 | 모델 | 텍스트+준비 (ms) | 디노이징 (s) | 디코딩+후처리 (ms) | 합계 (s) | 디노이징 비중 (%) |
|---|---|---|---|---|---|---|
| T2I | Base | 47 | 14.24 | 416 | 14.70 | 96.8 |
| T2I | 단계 축소 | 24 | 2.28 | 410 | 2.71 | 84.0 |
| I2I | Base | 468 | 39.40 | 417 | 40.29 | 97.8 |
| I2I | 단계 축소 | 407 | 6.65 | 418 | 7.48 | 89.0 |
결과
표: 단일 GPU 종단 지연시간 전후 비교
조건: B200 1장, 2048×2048, Base, 미컴파일 BF16 VANILLA 대비 컴파일+NVFP4 PrimsTS+Sol-Attention+Cache-DiT, LPIPS는 기준 출력 대비 예시 이미지 값, NVIDIA 자체 측정
단위: s, 배
| 작업 | 종단 지연시간 (s) | 종단 속도 개선 (배) | LPIPS |
|---|---|---|---|
| T2I | 22.36 → 6.46 | 3.46 | 0.095 |
| I2I | 54.64 → 12.28 | 4.45 | 0.045 |
표: 다중 GPU 확장 시 종단 지연시간과 디노이징 이득
조건: DGX B200 1장→8장, 2048×2048, NVFP4 T2I, Base는 CFG 2그룹·Ulysses 4, 단계 축소 모델은 Ulysses 8, NVIDIA 자체 측정
단위: s, 배
| 모델 | 종단 지연시간 중앙값 (s) | 디노이징 속도 개선 (배) |
|---|---|---|
| Base | 14.90 → 3.00 | 6.01 |
| 단계 축소 | 2.73 → 1.08 | 4.44 |
전체 시간의 대부분은 디노이징이 차지하고 나머지 단계는 수백 ms 수준에 머문다. 그래서 NVIDIA가 손댔던 최적화는 대부분 디노이징 구간, 즉 어텐션과 행렬곱 연산을 겨냥했다.
왜 이런 차이가 나나
아래 개별 기법은 NVIDIA의 B200 1장·2048×2048 Base NVFP4 T2I 측정이다. 기본 어텐션 백엔드 VANILLA의 BF16 어텐션은 이미지를 점진적으로 정제하는 확산 트랜스포머(DiT)의 GPU 커널 시간 약 60%를 차지했다.
양자화는 블랙웰의 저정밀 형식인 NVFP4를 쓴다. Blackwell 1장에서 BF16 대비 생성 속도는 최대 T2I 1.62배·I2I 1.58배였다. BFL이 미리 양자화한 DiT 체크포인트를 불러오므로 별도 양자화가 필요 없다. 행렬곱은 FlashInfer의 PrimsTS 커널이 맡아, B200에서 자동 튜닝된 TensorRT LLM NVFP4 GEMM 구현 대비 T2I를 1.02~1.10배 앞당겼다고 NVIDIA가 측정했다.
VANILLA BF16 어텐션 대비 cuDNN FP8이 생성 1.08배, 오차가 큰 토큰만 보정하는 VC-Attention FP8(ρ=0.005)이 1.18배였다. 후자의 CUDA Graphs 활성 예시 LPIPS는 0.086이다.
불필요한 연산을 건너뛰는 Sol-Attention(τ=1.0)은 초기 16스텝을 촘촘히 계산하면 품질 우선으로 1.24배, 12스텝이면 속도 우선으로 1.30배였다. 이는 컴파일된 촘촘한 VANILLA 대비 디노이징+오토인코더 디코딩 배수다. 12스텝의 CUDA Graphs 활성 예시 LPIPS는 차 장면 0.151·고양이 장면 0.140으로, 서로 다른 이미지의 값이다. τ를 더 올리면 품질이 떨어지는 대신 추가 속도 이득은 크지 않았다.
Cache-DiT는 가중치를 수정하지 않고 스텝 사이의 중간 트랜스포머 출력을 재사용한다. 출력 변화량의 허용 기준인 잔차 차이 임계값 0.24에서 캐시 미적용 대비 생성 1.94배, 예시 LPIPS 0.033이었다.
여러 장을 쓸 때 Base는 정·부정 프롬프트를 GPU 그룹에 나누는 CFG 병렬과 시퀀스를 나누는 Ulysses 병렬을 함께 쓴다. 단계 축소 모델은 Ulysses만 쓴다.
위 2048×2048 확장 표의 종단 이득은 Base 14.90/3.00≈4.97배, 단계 축소 2.73/1.08≈2.53배로, 디노이징의 6.01·4.44배보다 작다. 8장 단계 축소 모델은 시간의 약 절반이 디노이징 밖에 남아 GPU 수만큼 전체 응답이 빨라지지 않는다.
별도 1024×1024 NVFP4·VANILLA 실험에서는 컴파일에 커널 실행을 기록·재사용하는 CUDA Graphs를 더해 GPU당 작업량 감소에 따른 실행 부담을 줄였다. NVIDIA 측정에서 B200 8장 Base는 1.823→0.809초, 단계 축소는 0.791→0.366초였다.
고를 때 기준
한 장으로 응답 시간을 낮추는 게 목표라면 NVFP4 체크포인트와 torch.compile, Cache-DiT부터 켜고, Sol-Attention은 품질을 보고 얹는 편이 낫다. 품질 손실을 거의 허용하지 않을 상황이면 Sol-Attention은 빼고, Cache-DiT와 NVFP4도 실제 업무 이미지를 기준 출력과 비교해 조합을 정한다.
다른 하드웨어의 별도 실험으로, RTX PRO 6000 Blackwell Server Edition 1장에서는 컴파일과 CuTe DSL NVFP4, Cache-DiT 조합으로 1.73~3.25배가 나온다고 NVIDIA가 말한다.
NVFP4 선택은 YAML에 다음을 넣는다. 설치·실행과 나머지 설정은 아래 배포 안내를 따른다.
pipeline_config:
  variant: nvfp4
비교 대상은 NVIDIA가 측정한 자체 서버 환경이고 다른 GPU 구성에서 같은 비율이 나온다는 보장은 없다.
디노이징 병목을 줄일수록 그 밖의 시간이 확장의 제약이 되므로, GPU 수보다 종단 지연시간과 LPIPS를 함께 살펴야 하며 VisualGen은 아직 베타 단계다.