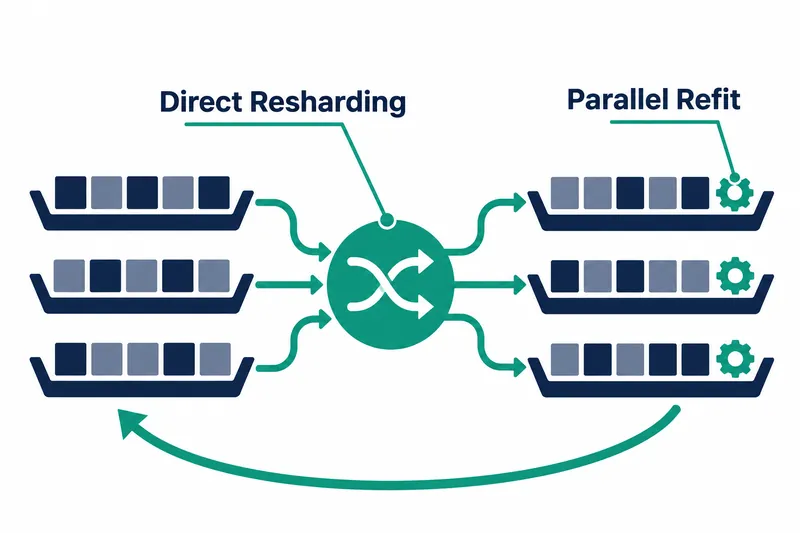
NVIDIA가 강화학습 모델의 학습용 GPU에서 추론용 GPU로 갱신된 가중치를 옮기는 통신 방식 ‘Reshard’를 공개했다. 학습과 추론을 별도 GPU에서 실행하는 개발팀은 전체 가중치를 모았다가 보내는 대신 필요한 조각을 직접 전달해 갱신 대기 시간을 줄일 수 있다.
1. 전체 가중치를 모았다가 다시 보내는 방식
강화학습 후학습, 사전 학습 뒤 추가로 훈련하는 과정은 현재 정책으로 추론해 학습 자료를 만들고, 업데이트된 가중치를 추론 GPU에 주기적으로 반영한다. 이 갱신 작업을 가중치 재적재(refit)라고 한다. 학습과 추론은 계산 특성이 달라 가중치 분할 방식도 다르므로, 두 GPU 집단 사이에서 큰 데이터를 효율적으로 옮기는 일이 과제가 된다.
기존의 대표 방식은 학습 GPU들이 각자 가진 조각을 모아 전체 매개변수를 만든 다음, 이를 추론 GPU에 전달하는 구조다. 추론 GPU는 필요한 부분만 남기지만, 받는 과정에서 전체 매개변수를 거친다.
NVIDIA는 매개변수당 2바이트인 BF16 가중치를 가정해 Kimi K3의 2.8조 매개변수는 약 5.6TB, Qwen 3.8 2.4T A95B의 2.4조 매개변수는 약 4.8TB라고 추산했다. 모으기와 전송을 합친 논리 데이터량, 각 단계의 데이터 크기를 더한 값은 각각 약 11.2TB와 약 9.6TB다.
2. 필요한 조각끼리 직접 연결
Reshard는 PyTorch의 분산 텐서 표현인 DTensor로 출발지와 도착지의 가중치 배치를 기술하고, 필요한 영역만 전달한다. 행 방향으로 나눈 행렬을 열 방향으로 다시 나눠 담는다면, 각 GPU가 맡을 열에 해당하는 부분만 받아 조립하는 식이다.
NCCL M2N Reshard는 이를 구현한 NCCL 기반 오픈소스 라이브러리다. 개발팀은 양쪽 배치를 설명하고 전송을 호출하며, 구체적인 통신 경로는 라이브러리에 맡긴다.
3. 네트워크 전송과 GPU 내부 교환
GPU 사이의 고속 연결인 NVLink를 공유하는 도착 GPU들은 같은 데이터를 복제할 때 서로 다른 부분을 네트워크로 받은 뒤 나눠 갖는다. 두 전송은 겹쳐 진행되며, 같은 데이터를 복제본마다 네트워크로 반복해서 보내는 부담을 줄인다.
4. NeMo RL에서 확인한 지연 감소
NVIDIA의 NeMo RL 측정에서 Reshard는 회사 발표 기준으로 기존 모으기·전송 방식보다 재적재가 2.7~5.7배 빨랐다. 아래는 하드웨어·모델·병렬 배치가 서로 다른 사례이며, 각 사례 안에서 두 방식의 지연을 비교한 결과다.
DGX H100(NVL8)의 Qwen 3 235B는 회사 발표 기준 6.4초에서 1.9초로 줄었다. 학습은 텐서 4·파이프라인 8·전문가 16 병렬, 추론은 텐서 8·데이터 16 병렬 구성이다. 각각 가중치 조각, 모델의 연속된 단계, 전문가 묶음, 같은 모델의 복제본을 GPU에 나눠 배치하는 방식이다.
DeepSeek v3 671B는 학습에 파이프라인 16·전문가 16 병렬, 추론에 텐서 32·데이터 8 병렬을 썼다. 이 구성에서 회사 발표 기준 DGX H100(NVL8)은 14.9초에서 2.6초로, DGX GB200(NVL72)은 6.1초에서 2.3초로 줄었다.
DGX GB200(NVL72)의 Nemotron Ultra v3는 회사 발표 기준 8.2초에서 2.3초로 줄었다. 학습은 텐서 8·전문가 32·파이프라인 2 병렬, 추론은 텐서 8·데이터 8 병렬 구성이다.
별도의 재적재 전용 마이크로벤치마크, 특정 작업만 따로 재는 성능 시험에서는 회사 발표 기준 BF16 Qwen3.8 2.4T 모델의 재적재에 4.3초가 걸렸다. 이 수치는 조 단위 매개변수 모델에서의 재적재 결과로 제시됐다.
5. 적용 방식과 비용의 이동
NeMo RL은 각 층에서 값을 변환하는 피드포워드 투영 가중치에 Reshard를 쓰고, 나머지는 기존 모으기·전송 경로에 남긴다. 회사 발표 기준 최신 대형 언어 모델에서 이 가중치는 매개변수의 약 95%를 차지한다. 데이터량이 큰 부분에 최적화를 집중하면서 다른 가중치의 다양한 형태는 기존 경로로 처리하는 선택이다.
설정은 다음과 같다.
policy:
  generation:
    colocated:
      enabled: false
    refit_transport: nccl_reshard
이 기능은 NeMo RL 문서에서 실험 기능으로 표시됐다. 학습과 생성을 별도 GPU에서 실행하고 Megatron으로 학습해야 하며, 생성 백엔드는 vLLM 또는 Megatron으로 한정되고 생성 쪽 파이프라인 병렬은 지원되지 않는다.
중복 네트워크 전송을 줄이는 대신 복제본을 완성하는 작업 일부는 도착 GPU 사이의 NVLink 통신으로 옮겨간다. Reshard 대용량 경로에서 처리하는 양자화 가중치, 표현 정밀도를 낮춘 가중치는 BF16으로 풀어 전송하고 목적지에서 필요에 따라 다시 양자화하므로, 전송 절약과 함께 형식 변환 비용도 살펴야 한다.
Reshard의 가치는 큰 모델의 갱신 대기를 줄이도록 전체 매개변수의 반복 전송을 필요한 조각의 전달로 바꾸는 데 있다.