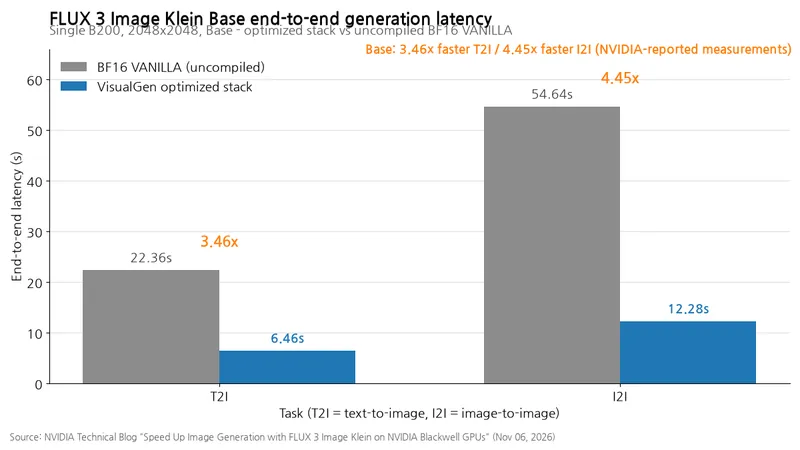
画像生成・編集サーバーの待ち時間を短縮する最適化の組み合わせが公開された。NVIDIAの測定では、FLUX 3 Image Klein Baseのテキスト→画像生成が22.36秒から6.46秒に、画像→画像編集が54.64秒から12.28秒に短縮された。速度向上に加え、基準出力との差を示すLPIPS指標もあり、何を犠牲にするかを比較できる。
測定方法
NVIDIAは2026年11月6日、TensorRT LLMの拡散モデル専用ランタイムVisualGenのチュートリアルを公開した。Baseのほか、生成ステップを減らすよう学習したステップ削減モデルも扱い、この16ステップモデルのエンドツーエンドの高速化は最大2.34倍だった。
エンドツーエンドのレイテンシは、プロンプト拡張・アップサンプリングを除いた生成パイプラインの時間で、LPIPSは低いほど基準出力に近い。まず、ノイズを段階的に除去するデノイジングの所要時間を見た。T2Iはテキスト→画像生成、I2Iは画像編集を指す。
表:FLUX 3 Image Kleinパイプラインの段階別レイテンシ
条件:単一B200、2048×2048、NVFP4・VANILLAアテンション(画像の各部分間で必要な情報を選んで参照する演算)・torch.compile、Baseは50ステップ・CFG 3.5、ステップ削減モデルは16ステップ・CFGなし。CFGは正・負のプロンプトで条件の強さを調整する方式。ウォームアップ2回後の10回のリクエスト平均、NVIDIAの自社測定。
単位:ms、s
| 処理 | モデル | テキスト+準備 (ms) | デノイジング (s) | デコード+後処理 (ms) | 合計 (s) | デノイジングの割合 (%) |
|---|---|---|---|---|---|---|
| T2I | Base | 47 | 14.24 | 416 | 14.70 | 96.8 |
| T2I | ステップ削減 | 24 | 2.28 | 410 | 2.71 | 84.0 |
| I2I | Base | 468 | 39.40 | 417 | 40.29 | 97.8 |
| I2I | ステップ削減 | 407 | 6.65 | 418 | 7.48 | 89.0 |
結果
表:単一GPUのエンドツーエンドのレイテンシの前後比較
条件:B200 1基、2048×2048、Base、未コンパイルのBF16 VANILLAに対しコンパイル+NVFP4 PrimsTS+Sol-Attention+Cache-DiT、LPIPSは基準出力に対するサンプル画像の値、NVIDIAの自社測定
単位:s、倍
| 処理 | エンドツーエンドのレイテンシ (s) | エンドツーエンドの高速化 (倍) | LPIPS |
|---|---|---|---|
| T2I | 22.36 → 6.46 | 3.46 | 0.095 |
| I2I | 54.64 → 12.28 | 4.45 | 0.045 |
表:複数GPUへの拡張時のエンドツーエンドのレイテンシとデノイジングの高速化
条件:DGX B200 1基→8基、2048×2048、NVFP4 T2I、BaseはCFG 2グループ・Ulysses 4、ステップ削減モデルはUlysses 8、NVIDIAの自社測定
単位:s、倍
| モデル | エンドツーエンドのレイテンシ中央値 (s) | デノイジングの高速化 (倍) |
|---|---|---|
| Base | 14.90 → 3.00 | 6.01 |
| ステップ削減 | 2.73 → 1.08 | 4.44 |
全体の時間の大部分をデノイジングが占め、残りの段階は数百ms程度にとどまる。そのため、NVIDIAが行った最適化の大半はデノイジング区間、つまりアテンションと行列積の演算を対象とした。
なぜ差が生じるのか
以下の個別手法は、NVIDIAによるB200 1基・2048×2048 Base NVFP4 T2Iの測定だ。標準アテンションバックエンドVANILLAのBF16アテンションは、画像を徐々に精緻化する拡散Transformer(DiT)のGPUカーネル時間の約60%を占めた。
量子化にはBlackwellの低精度形式NVFP4を使う。Blackwell 1基でのBF16比の生成速度は、最大でT2Iが1.62倍、I2Iが1.58倍だった。BFLが事前に量子化したDiTチェックポイントを読み込むため、別途量子化は不要だ。行列積にはFlashInferのPrimsTSカーネルを使い、B200で自動チューニングしたTensorRT LLM NVFP4 GEMM実装に対し、T2Iが1.02~1.10倍高速化したとNVIDIAは測定した。
VANILLA BF16アテンション比で、cuDNN FP8は生成が1.08倍、誤差の大きいトークンだけを補正するVC-Attention FP8(ρ=0.005)は1.18倍だった。後者でCUDA Graphsを有効にしたサンプルのLPIPSは0.086だ。
不要な演算を省くSol-Attention(τ=1.0)は、最初の16ステップを密に計算すると品質優先で1.24倍、12ステップなら速度優先で1.30倍だった。これはコンパイル済みの密なVANILLAに対するデノイジング+オートエンコーダーのデコードの倍率だ。12ステップでCUDA Graphsを有効にしたサンプルのLPIPSは、車の場面が0.151、猫の場面が0.140で、異なる画像の値だ。τをさらに上げても、品質が下がる一方で速度の追加向上は大きくなかった。
Cache-DiTは重みを変更せず、ステップ間の中間Transformer出力を再利用する。出力変化量の許容基準となる残差差分のしきい値0.24では、キャッシュなしに比べ生成が1.94倍、サンプルのLPIPSは0.033だった。
複数基を使う際、Baseは正・負のプロンプトをGPUグループに分けるCFG並列と、シーケンスを分けるUlysses並列を併用する。ステップ削減モデルはUlyssesのみを使う。
上の2048×2048の拡張表では、エンドツーエンドの高速化はBaseが14.90/3.00≈4.97倍、ステップ削減が2.73/1.08≈2.53倍で、デノイジングの6.01・4.44倍より小さい。8基のステップ削減モデルでは時間の約半分がデノイジング以外に残り、GPU数に比例して応答全体が速くなるわけではない。
別の1024×1024 NVFP4・VANILLA実験では、コンパイルにカーネル実行を記録・再利用するCUDA Graphsを加え、GPU当たりの処理量減少に伴う実行負荷を抑えた。NVIDIAの測定では、B200 8基のBaseが1.823→0.809秒、ステップ削減が0.791→0.366秒だった。
選択時の基準
1基で応答時間を短縮するのが目標なら、NVFP4チェックポイントとtorch.compile、Cache-DiTから有効にし、Sol-Attentionは品質を見て加えるのがよい。品質低下をほぼ許容できない場合はSol-Attentionを外し、Cache-DiTとNVFP4も実際の業務画像を基準出力と比較して組み合わせを決める。
別のハードウェアでの実験として、RTX PRO 6000 Blackwell Server Edition 1基では、コンパイルとCuTe DSL NVFP4、Cache-DiTの組み合わせで1.73~3.25倍になるとNVIDIAは述べている。
NVFP4を選ぶにはYAMLに以下を入れる。インストール・実行と残りの設定は、以下の配布案内に従う。
pipeline_config:
  variant: nvfp4
比較対象はNVIDIAが測定した自社サーバー環境であり、別のGPU構成で同じ比率になる保証はない。
デノイジングのボトルネックを減らすほどそれ以外の時間が拡張の制約になるため、GPU数よりエンドツーエンドのレイテンシとLPIPSを併せて見るべきであり、VisualGenはまだベータ段階だ。