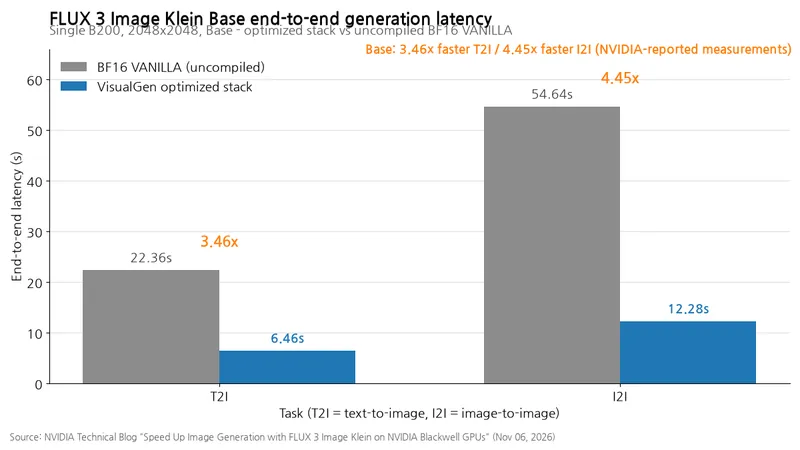
用于降低图像生成与编辑服务器延迟的优化组合已公开。NVIDIA的测量显示,FLUX 3 Image Klein Base的文本→图像生成耗时从22.36秒降至6.46秒,图像→图像编辑耗时从54.64秒降至12.28秒。除加速幅度外,还提供了衡量与基准输出差异的LPIPS指标,便于比较需要付出的代价。
测量方法
NVIDIA于2026年11月6日发布了TensorRT LLM扩散模型专用运行时VisualGen的教程。除Base外,教程还涵盖了经过训练以减少生成步数的步数缩减模型,该16步模型的端到端加速最高为2.34倍。
端到端延迟指不含提示词扩展与上采样的生成流水线耗时,LPIPS越低,输出越接近基准。首先考察逐步去除噪声的去噪过程所占的时间。T2I指文本→图像生成,I2I指图像编辑。
表:FLUX 3 Image Klein流水线各阶段延迟
条件:单张B200,2048×2048,NVFP4、VANILLA注意力(在图像不同部分之间选择并引用所需信息的运算)、torch.compile;Base为50步、CFG 3.5,步数缩减模型为16步、无CFG;CFG通过正负提示词调节条件强度;预热2次后取10次请求平均值,NVIDIA自行测量。
单位:ms、s
| 任务 | 模型 | 文本+准备 (ms) | 去噪 (s) | 解码+后处理 (ms) | 总计 (s) | 去噪占比 (%) |
|---|---|---|---|---|---|---|
| T2I | Base | 47 | 14.24 | 416 | 14.70 | 96.8 |
| T2I | 步数缩减 | 24 | 2.28 | 410 | 2.71 | 84.0 |
| I2I | Base | 468 | 39.40 | 417 | 40.29 | 97.8 |
| I2I | 步数缩减 | 407 | 6.65 | 418 | 7.48 | 89.0 |
结果
表:单GPU端到端延迟优化前后对比
条件:1张B200,2048×2048,Base;以未编译的BF16 VANILLA为基准,对比编译+NVFP4 PrimsTS+Sol-Attention+Cache-DiT;LPIPS为示例图像相对基准输出的数值,NVIDIA自行测量。
单位:s、倍
| 任务 | 端到端延迟 (s) | 端到端加速 (倍) | LPIPS |
|---|---|---|---|
| T2I | 22.36 → 6.46 | 3.46 | 0.095 |
| I2I | 54.64 → 12.28 | 4.45 | 0.045 |
表:多GPU扩展时的端到端延迟与去噪加速幅度
条件:DGX B200从1张扩展至8张,2048×2048,NVFP4 T2I;Base采用CFG 2组、Ulysses 4,步数缩减模型采用Ulysses 8,NVIDIA自行测量。
单位:s、倍
| 模型 | 端到端延迟中位数 (s) | 去噪加速 (倍) |
|---|---|---|
| Base | 14.90 → 3.00 | 6.01 |
| 步数缩减 | 2.73 → 1.08 | 4.44 |
去噪占据了总耗时的大部分,其余阶段仅为数百ms。因此,NVIDIA的优化主要针对去噪阶段,也就是注意力与矩阵乘法运算。
为何出现这些差异
以下各项技术的数据均来自NVIDIA在1张B200、2048×2048、Base NVFP4 T2I条件下的测量。默认注意力后端VANILLA的BF16注意力,约占逐步细化图像的扩散Transformer(DiT)GPU内核耗时的60%。
量化采用Blackwell的低精度格式NVFP4。在1张Blackwell上,相比BF16,生成加速最高为T2I 1.62倍、I2I 1.58倍。由于直接加载BFL预先量化的DiT检查点,无需另行量化。矩阵乘法由FlashInfer的PrimsTS内核负责;据NVIDIA测量,在B200上,相比自动调优的TensorRT LLM NVFP4 GEMM实现,其T2I加速为1.02~1.10倍。
相比VANILLA BF16注意力,cuDNN FP8的生成加速为1.08倍,仅校正高误差token的VC-Attention FP8(ρ=0.005)为1.18倍。后者启用CUDA Graphs的示例LPIPS为0.086。
跳过不必要运算的Sol-Attention(τ=1.0),在前16步采用稠密计算时以质量优先,加速为1.24倍;前12步则以速度优先,为1.30倍。这是相对已编译的稠密VANILLA的去噪+自编码器解码加速倍数。12步且启用CUDA Graphs时,汽车场景的示例LPIPS为0.151,猫场景为0.140,二者来自不同图像。进一步提高τ会降低质量,但额外加速幅度不大。
Cache-DiT不修改权重,而是复用不同步骤间的Transformer中间输出。在用于限定输出变化量的残差差异阈值为0.24时,相比不使用缓存,生成加速为1.94倍,示例LPIPS为0.033。
使用多张GPU时,Base同时采用将正负提示词分配至不同GPU组的CFG并行,以及拆分序列的Ulysses并行。步数缩减模型仅采用Ulysses。
上述2048×2048扩展表中的端到端加速为Base 14.90/3.00≈4.97倍、步数缩减模型2.73/1.08≈2.53倍,低于去噪的6.01倍与4.44倍。8卡步数缩减模型仍有约一半时间用于去噪之外,因此整体响应不会按GPU数量同比加速。
另一个1024×1024 NVFP4、VANILLA实验在编译之外加入了记录并复用内核执行的CUDA Graphs,以减轻每张GPU工作量下降后带来的执行开销。NVIDIA测得,8张B200上的Base耗时为1.823→0.809秒,步数缩减模型为0.791→0.366秒。
选择标准
若目标是用1张卡降低响应时间,宜先启用NVFP4检查点、torch.compile与Cache-DiT,再视质量情况加入Sol-Attention。若几乎不能容忍质量损失,则不使用Sol-Attention;Cache-DiT与NVFP4的组合也应通过实际业务图像与基准输出的比较来确定。
在另一项使用不同硬件的实验中,NVIDIA表示,1张RTX PRO 6000 Blackwell Server Edition采用编译、CuTe DSL NVFP4与Cache-DiT组合,可实现1.73~3.25倍加速。
选择NVFP4时,在YAML中加入以下内容。安装、运行与其余配置请遵循下方部署指南。
pipeline_config:
  variant: nvfp4
比较对象是NVIDIA测量的自有服务器环境,不能保证其他GPU配置也能取得相同的加速比例。
去噪瓶颈越小,其余耗时就越会限制扩展,因此相比GPU数量,更应同时关注端到端延迟与LPIPS,并注意VisualGen仍处于测试阶段。