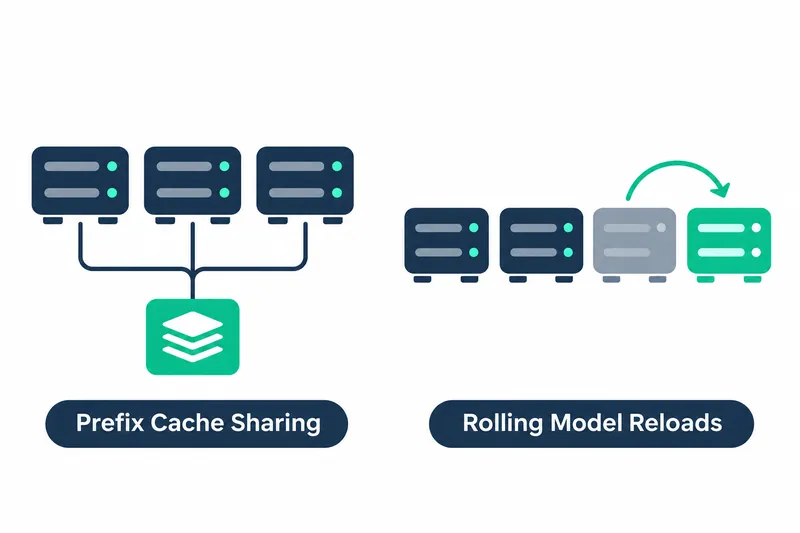
Xinferenceが11月7日に公開した4.2.0は、モデルサーバーを複数レプリカで運用する開発者向けに、入力の先頭部分の計算結果を共有し、モデルをレプリカごとに再読み込みする機能を追加した。繰り返しの計算を減らす一方、交換前に処理していたリクエストを以前のエンジンで完了でき、計算効率とサービス運用の継続性の両方に関わる変更だ。
1. 同じ入力の先頭部分をレプリカ間で再利用する
プレフィックスキャッシュ共有は、入力の同じ先頭部分をレプリカごとに再計算する代わりに、処理済みの結果を利用する仕組みだ。Xavierがこの共有を担い、入力を先に処理するプリフィル段階の繰り返しを減らすことに重点を置いている。
共有対象には、vLLMとSGLangを実行するレプリカが含まれる。これらの推論エンジンで複数レプリカを運用する環境で、計算結果を再利用できるようにした。
TRT-LLMとMLXを実行するレプリカも共有対象だ。共有機能を複数の推論エンジンを使う環境へ広げた点が、今回の変更の核心となる。
エージェントがツールの応答を待つ間は、続けて使う入力の先頭部分の計算結果であるKVプレフィックスを優先的に保持できる。作業再開時に同じ入力を再処理する負担を減らすための機能だ。
ストレージ面では、LMCacheにMooncake Storeのサポートが追加された。エージェントキャッシュの保持・再利用を管理するライフサイクルも、複数のストレージ層を活用する階層型ストレージまで拡張された。
2. 重みを保持してレプリカを順番に再読み込みする
ローリング再読み込みは、モデルが学習で得た数値情報であるGPU上の重みを保持したまま、レプリカを1つずつ再読み込みする機能だ。レプリカの交換中、処理中のリクエストは以前のエンジンインスタンスで完了する。再読み込みするレプリカを1つずつ切り替えながら、既存リクエストが完了する場所を以前のエンジンに残す仕組みだ。
3. プログラムの更新はウェブ画面から順番に進める
管理者はウェブ画面でXinferenceの新しい更新の有無を確認し、インストールできる。モデルの再読み込み機能に加え、プログラム自体の更新経路も提供し、運用画面からバージョン管理作業を始められるようにした。
アップグレードは、ワーカー → スーパーバイザー → API の順に進む(ワーカーはタスクを担当して実行するプロセス、スーパーバイザーはタスクの実行単位を管理するコンポーネントである)。モデルレプリカのローリング再読み込みが稼働中のモデルを扱うのに対し、この手順は推論サービスを構成するプログラムを順番に更新する。
4. 稼働中のモデルでスループットと応答時間を調べる
ウェブ画面には、稼働中のチャットモデルを対象に性能テストを開始する機能も追加された。同時に送るリクエスト数を変えてテストし、実行ごとのスループットと応答時間を比較できる。運用者は、利用中のモデルで負荷レベルによる違いを調べられる。
比較項目には、最初のトークンまでの時間と出力トークンあたりの時間も含まれる。結果はJSONでエクスポートでき、画面で確認したテスト記録を外部に持ち出せる。キャッシュ共有が繰り返しの計算を減らす変更だとすれば、この機能は稼働中のモデルの処理性能を調べる手段だ。
5. 再計算を減らす代わりに計算結果を保持する
キャッシュ共有の利点は、同じ入力を再処理する負担を軽減することにある。その代わり、運用の焦点は計算結果を保持・再利用するストレージ管理へ移る。ローリング再読み込みも、処理中のリクエストを以前のエンジンで完了する間はGPU上の重みを保持するため、リクエスト処理の継続性とリソースの保持を併せて考慮する方式だ。
キャッシュ共有は互換性のあるプレフィックスに適用され、重みを保持するローリング再読み込みは、対応するvLLMおよびSGLangのデプロイ環境が対象だ。リリースノートには、性能の改善幅や重みの保持に必要な追加リソース量は示されていない。
Xinference 4.2.0の核心は、レプリカ間での計算結果の再利用と、処理中のリクエストを考慮した順次交換によって、モデルサービス運用の負担を軽減することにある。