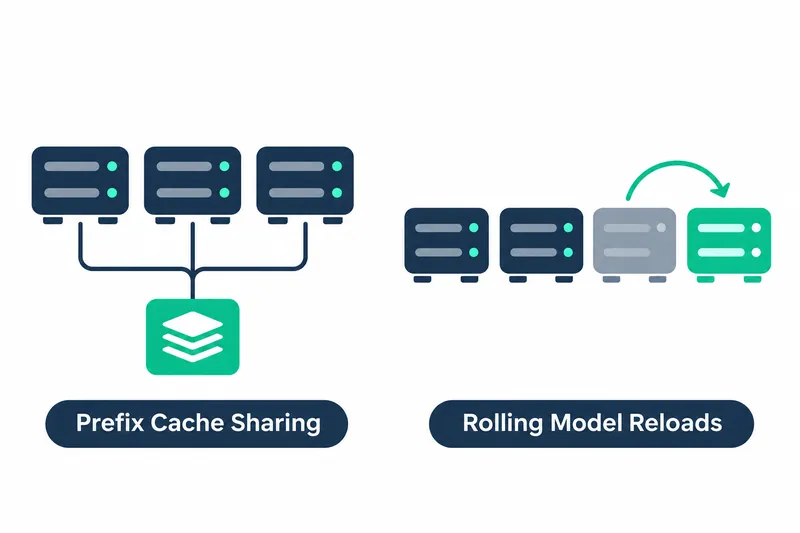
Xinference가 11월 7일 공개한 4.2.0은 모델 서버를 여러 복제본으로 운영하는 개발자를 위해 입력 앞부분의 계산 결과를 나눠 쓰고, 모델을 한 복제본씩 다시 불러오는 기능을 추가했다. 반복 계산을 줄이는 한편 교체 전에 처리하던 요청을 이전 엔진에서 마칠 수 있어, 계산 효율과 서비스 운영의 연속성을 함께 다룬 변화다.
1. 같은 입력 앞부분을 복제본끼리 재사용한다
접두사 캐시 공유는 입력의 같은 앞부분을 복제본마다 다시 계산하는 대신, 이미 처리한 결과를 가져다 쓰는 방식이다. Xavier가 이 공유를 맡으며, 입력을 먼저 처리하는 프리필 단계의 반복을 줄이는 데 초점을 맞췄다.
공유 대상에는 vLLM과 SGLang을 실행하는 복제본이 포함된다. 이들 추론 엔진으로 여러 복제본을 운영하는 환경에서 계산 결과를 재사용할 수 있게 한 것이다.
TRT-LLM과 MLX를 실행하는 복제본도 공유 대상이다. 공유 기능을 여러 추론 엔진을 사용하는 환경으로 넓힌 점이 이번 변화의 핵심이다.
에이전트가 도구의 응답을 기다리는 동안에는 이어서 쓸 입력 앞부분의 계산 결과인 KV 접두사를 우선 보존할 수 있다. 작업을 재개할 때 같은 입력을 다시 처리하는 부담을 줄이려는 기능이다.
저장 측면에서는 LMCache에 Mooncake Store 지원이 추가됐다. 에이전트 캐시의 보존·재사용을 관리하는 수명 주기도 여러 저장 계층을 활용하는 계층형 저장소까지 확장됐다.
2. 가중치를 남겨 두고 복제본을 차례로 다시 불러온다
순차 재적재는 GPU 가중치, 모델이 학습해 얻은 수치 정보를 보유한 상태로 복제본을 하나씩 다시 불러오는 기능이다. 복제본 교체가 진행되는 동안 처리 중인 요청은 이전 엔진 인스턴스에서 완료된다. 다시 불러올 복제본을 하나씩 바꾸면서, 기존 요청이 끝날 자리를 이전 엔진에 남겨 두는 방식이다.
3. 프로그램 업데이트는 웹 화면에서 순서대로 진행한다
관리자는 웹 화면에서 Xinference의 새 업데이트가 있는지 확인하고 설치할 수 있다. 모델을 다시 불러오는 기능과 함께 프로그램 자체의 업데이트 경로도 제공해, 운영 화면에서 버전 관리 작업을 시작할 수 있게 했다.
업그레이드는 워커 → 수퍼바이저 → API 순으로 진행된다(워커는 작업을 맡아 실행하는 프로세스이고, 수퍼바이저는 작업 실행 단위를 관리하는 구성 요소다). 모델 복제본의 순차 재적재가 실행 중인 모델을 다룬다면, 이 절차는 추론 서비스를 구성하는 프로그램들을 순서대로 갱신한다.
4. 실행 중인 모델로 처리량과 응답 시간을 살핀다
웹 화면에는 실행 중인 채팅 모델을 대상으로 성능 시험을 시작하는 기능도 추가됐다. 동시에 보내는 요청 수를 달리해 시험하고, 실행별로 처리량과 응답 시간을 비교할 수 있다. 운영자는 자신이 쓰는 모델에서 부하 수준에 따른 차이를 살필 수 있다.
비교 항목에는 첫 토큰까지 걸리는 시간과 출력 토큰당 시간도 포함된다. 결과는 JSON으로 내보낼 수 있어, 화면에서 확인한 시험 기록을 밖으로 가져갈 수 있다. 캐시 공유가 반복 계산을 줄이는 변화라면, 이 기능은 실행 중인 모델의 처리 성능을 살펴보는 수단이다.
5. 재계산을 줄이는 대신 계산 결과를 보존한다
캐시 공유의 이익은 같은 입력을 다시 처리하는 부담을 덜어내는 데 있다. 그 대가로 운영의 초점은 계산 결과를 보존하고 재사용하는 저장 관리로 옮겨간다. 순차 재적재 역시 진행 중인 요청을 이전 엔진에서 마치는 동안 GPU 가중치를 유지하므로, 요청 처리의 연속성과 자원 보유를 함께 고려하는 방식이다.
캐시 공유는 호환되는 접두사에 적용되며, 가중치 유지형 순차 재적재는 지원되는 vLLM 및 SGLang 배포가 대상이다. 릴리스 노트에는 성능 개선 폭이나 가중치 유지에 필요한 추가 자원량이 제시되지 않았다.
Xinference 4.2.0의 핵심은 복제본 간 계산 결과 재사용과 진행 중 요청을 고려한 순차 교체로 모델 서비스 운영의 부담을 낮추는 데 있다.