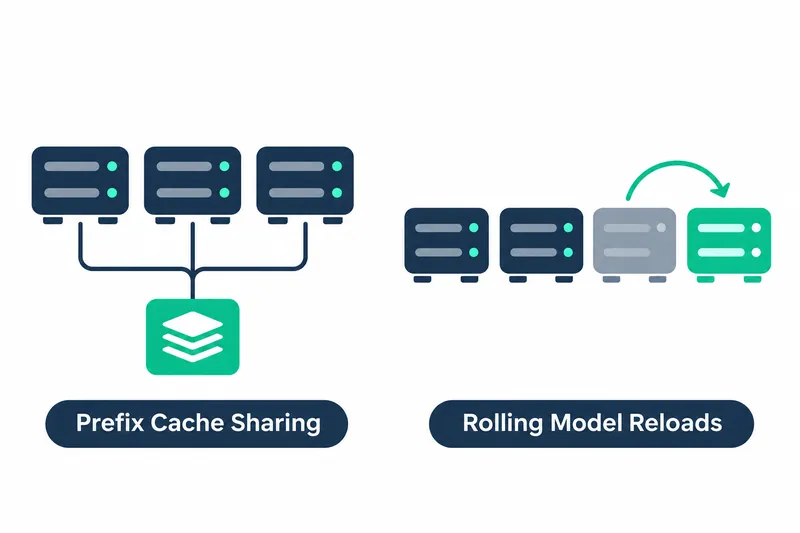
Xinference 于 11月 7日发布的 4.2.0,为以多副本运行模型服务器的开发者新增了共享输入前缀计算结果、逐个重载模型副本的功能。这既能减少重复计算,又能让替换前正在处理的请求在旧引擎上完成,同时兼顾计算效率与服务运行的连续性。
1. 在副本间复用相同输入前缀
前缀缓存共享是指直接使用已处理的结果,而不是让每个副本重新计算相同的输入前缀。Xavier 负责这项共享,重点在于减少预先处理输入的预填充阶段中的重复计算。
共享范围包括运行 vLLM 和 SGLang 的副本。这使得在使用这些推理引擎运行多个副本的环境中,可以复用计算结果。
运行 TRT-LLM 和 MLX 的副本也在共享范围内。将共享功能扩展到使用多种推理引擎的环境,是此次变化的核心。
智能体等待工具响应时,可以优先保留后续要使用的输入前缀计算结果,即 KV 前缀。这项功能旨在减轻恢复任务时重新处理相同输入的负担。
在存储方面,LMCache 新增了对 Mooncake Store 的支持。管理智能体缓存保留与复用的生命周期,也扩展到了利用多个存储层的分层存储。
2. 保留权重并逐个重载副本
滚动重载是在保留 GPU 权重,即模型通过训练获得的数值信息的状态下,逐个重载副本的功能。副本替换期间,正在处理的请求会在旧引擎实例上完成。这种方式逐个替换需要重载的副本,同时保留旧引擎,让已有请求能够完成。
3. 在网页界面中依次更新程序
管理员可以在网页界面中检查并安装 Xinference 的新更新。除了模型重载功能,还提供了程序本身的更新途径,让用户能够从运维界面启动版本管理操作。
升级按 工作节点 → 监督器 → API 的顺序进行(工作节点是承接并执行任务的进程,监督器是管理任务执行单元的组件)。如果说模型副本的滚动重载针对的是运行中的模型,那么这一流程就是依次更新构成推理服务的各个程序。
4. 用运行中的模型查看吞吐量和响应时间
网页界面还新增了对运行中聊天模型启动性能测试的功能。用户可以改变并发请求数进行测试,并比较各次运行的吞吐量和响应时间。运维人员能够查看所用模型在不同负载水平下的表现差异。
比较指标还包括首个词元耗时和每个输出词元耗时。结果可导出为 JSON,便于将界面中查看的测试记录带到外部。如果说缓存共享是为了减少重复计算,那么这项功能就是观察运行中模型处理性能的手段。
5. 保留计算结果以减少重新计算
缓存共享的收益在于减轻重复处理相同输入的负担。相应地,运维重点会转向保留和复用计算结果的存储管理。滚动重载也会在旧引擎完成进行中的请求时保留 GPU 权重,因此需要同时考虑请求处理的连续性与资源占用。
缓存共享适用于兼容的前缀,保留权重的滚动重载则面向受支持的 vLLM 和 SGLang 部署。发布说明未给出性能提升幅度,也未说明保留权重所需的额外资源量。
Xinference 4.2.0 的核心在于,通过副本间复用计算结果,以及顾及进行中请求的滚动替换,减轻模型服务的运维负担。