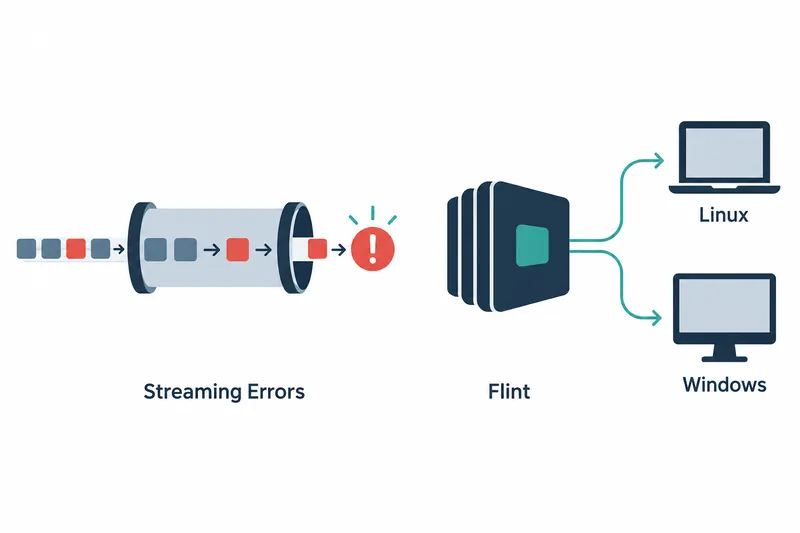
Ollamaは回答の送信中に起きた生成の失敗をレスポンスで通知し、FlintモデルをLinuxとWindowsでも実行できるようにした。回答をリアルタイムに受信して表示するサービスの開発者は、部分出力と完成した回答を区別して処理でき、Flint利用者は実行環境の選択肢が広がる。
1. 部分出力後の失敗もレスポンスに含める
リリースノートによると、OpenAI ResponsesとAnthropic Messages形式のストリーミングリクエストで生成に失敗した場合、一部を出力して黙って終了するのではなく、失敗を報告するようになった。従来の動作では、送信済みの内容だけを受け取った側が正常なレスポンスと誤認する可能性があったが、今後はストリームの末尾で失敗を確認できる。
Anthropic形式では、ストリーミング開始後のエラーをerrorイベントで通知する。開始前に発生したエラーは、従来どおりエラー内容を含むレスポンスとして処理する。
OpenAI Responses側は、失敗状態のイベントであるresponse.failedを送出するよう変更された。変更されたコードでは、失敗で終了する際に生成済みの部分出力も保持する。
	response := anthropic.NewError(w.Status(), errData.Error)
	if w.stream && w.Written() {
		if err := w.writeEvent("error", anthropic.StreamErrorEvent{Type: response.Type, Error: response.Error}); err != nil {
			return 0, err
		}
		return len(data), nil
	}
このコードは、変更履歴全体に含まれるAnthropic処理の一部だ。レスポンスの書き込みを開始済みか確認してから、エラーイベントを送る。ストリーミングを受け取るプログラムは、本文の断片を表示するだけでなく、最後の失敗イベントも解釈する必要がある。
2. クラウドモデルの情報をコーディングツールに提供
ollama launchは、クラウドモデルのコンテキスト長、つまりモデルが一度に参照する入力量と、機能情報をコーディングツールに渡すよう修正された。リリースノートは、この変更が誤ったコンテキスト設定と圧縮設定を正すと説明している。圧縮は長くなった会話を短くして作業を続けるための処理で、適切なタイミングで行うにはツールがモデルの入力上限を知る必要がある。
Claude Codeの連携コードでは、モデル情報から得たコンテキスト長を設定に反映し、自動圧縮のしきい値も所定の上限内で調整する。利用者が自動圧縮のしきい値をすでに設定している場合、その値は維持する。利用者はクラウドモデルをコーディングツールに接続する際、モデルごとの入力上限が設定に反映されているか確認できる。
3. Flintの実行環境がLinux・Windowsに拡大
Ollamaは、FlintがmacOSだけでなくLinuxとWindowsでも動作すると発表した。これにより、これらのOSの利用者も同じモデルを実行対象に選べる。
変更履歴全体には、推論機能、つまり回答前に中間的な思考過程を経る機能を無効にしたFlintが、すぐに回答を生成するようにした修正もある。変更の説明によると、デフォルト設定と推論を有効にした場合のプロンプトは変わっていない。
4. 検索後のリクエストも対応する設定に従う
Anthropic互換のウェブ検索の後続リクエストは、モデルが対応する推論設定を再利用するようになった。最初のリクエストに合わせて調整した設定を、検索後のリクエストでも引き続き使う方式だ。Ollamaは、これにより回避可能な失敗を防ぐと説明した。
ストリーミングの変更が、発生したエラーを受信側に伝えることに重点を置くのに対し、この修正は検索後のリクエストに適した設定を使うことに重点を置く。同じエラー対策でも、一方は失敗の通知を、もう一方は後続リクエストの設定の整合性を扱う。
5. 連携コードは部分出力と最終状態をともに扱う
ストリーミングのエラーが通知されれば、途切れた結果を完成した回答として処理する可能性を減らせる。一方、従来は成功時の出力だけを受け取っていた連携コードには、失敗イベントを読み取り、利用者にエラーを知らせる処理が必要になる。このようにエラー処理が明確になる一方で、ストリームを受け取る側の状態処理が重要になる。
0.40.9はストリーミングの失敗を明確に通知し、クラウドモデル情報とFlintの対応範囲を広げることで、連携の正確性と選択肢を改善したアップデートだ。