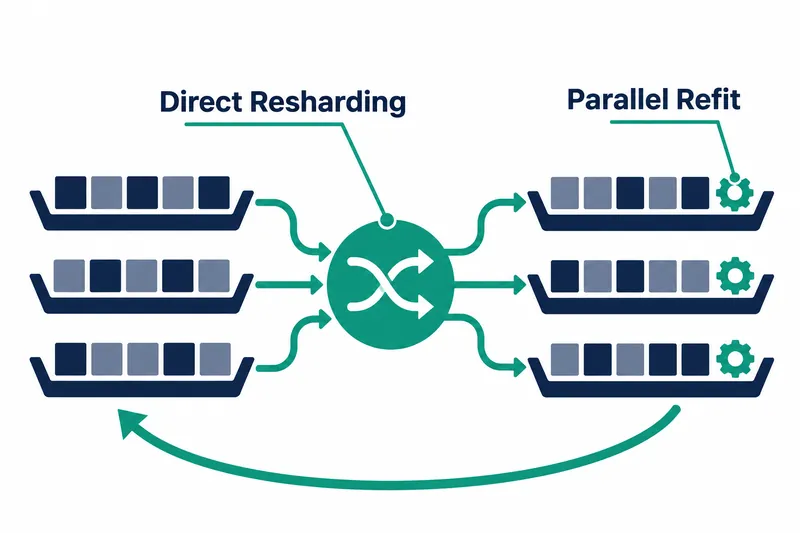
NVIDIAは、強化学習モデルの学習用GPUから推論用GPUへ更新済みの重みを移す通信方式「Reshard」を公開した。学習と推論を別々のGPUで実行する開発チームは、重み全体を集約してから送る代わりに、必要な断片を直接渡して更新の待ち時間を短縮できる。
1. 重み全体を集約してから再送する方式
強化学習による事後学習、つまり事前学習後に追加で訓練する過程では、現在の方策で推論して学習データを作り、更新した重みを推論GPUへ定期的に反映する。この更新作業を重みの再ロード(refit)という。学習と推論は計算特性が異なり、重みの分割方法も異なるため、2つのGPU群の間で大容量データを効率よく移すことが課題となる。
従来の代表的な方式では、学習GPUがそれぞれ持つ断片を集めて全パラメータを構築し、推論GPUへ送る。推論GPUは必要な部分だけを残すが、受信時には全パラメータを経由する。
NVIDIAは、パラメータ当たり2バイトのBF16重みを想定し、Kimi K3の2.8兆パラメータは約5.6TB、Qwen 3.8 2.4T A95Bの2.4兆パラメータは約4.8TBと推計した。集約と転送を合わせた論理データ量、つまり各段階のデータサイズの合計は、それぞれ約11.2TBと約9.6TBとなる。
2. 必要な断片を直接接続
Reshardは、PyTorchの分散テンソル表現であるDTensorで送信元と送信先の重みの配置を記述し、必要な領域だけを転送する。行方向に分割した行列を列方向に再分割する場合、各GPUが担当する列に相当する部分だけを受け取り、組み立てる仕組みだ。
NCCL M2N Reshardは、これを実装したNCCLベースのオープンソースライブラリだ。開発チームは両側の配置を記述して転送を呼び出し、具体的な通信経路はライブラリに任せる。
3. ネットワーク転送とGPU間の交換
GPU間の高速接続であるNVLinkを共有する送信先GPUは、同じデータを複製する際、異なる部分をネットワーク経由で受け取ってから分け合う。2つの転送は重ねて実行され、同じデータを複製ごとにネットワークで繰り返し送る負担を減らす。
4. NeMo RLで確認した遅延の削減
NVIDIAのNeMo RL測定では、同社の発表によると、Reshardの再ロードは従来の集約・転送方式より2.7~5.7倍高速だった。以下はハードウェア、モデル、並列配置が異なる事例で、各事例内で2つの方式の遅延を比較した結果だ。
DGX H100(NVL8)上のQwen 3 235Bでは、同社の発表によると6.4秒から1.9秒に短縮した。学習はテンソル4・パイプライン8・エキスパート16並列、推論はテンソル8・データ16並列の構成だ。それぞれ重みの断片、モデルの連続した段階、エキスパート群、同じモデルの複製をGPUに分散配置する方式を指す。
DeepSeek v3 671Bは、学習にパイプライン16・エキスパート16並列、推論にテンソル32・データ8並列を用いた。この構成では、同社の発表によるとDGX H100(NVL8)は14.9秒から2.6秒へ、DGX GB200(NVL72)は6.1秒から2.3秒へ短縮した。
DGX GB200(NVL72)上のNemotron Ultra v3では、同社の発表によると8.2秒から2.3秒に短縮した。学習はテンソル8・エキスパート32・パイプライン2並列、推論はテンソル8・データ8並列の構成だ。
別の再ロード専用マイクロベンチマーク、つまり特定の処理だけを測る性能試験では、同社の発表によるとBF16 Qwen3.8 2.4Tモデルの再ロードに4.3秒かかった。この数値は、兆単位のパラメータを持つモデルでの再ロード結果として示された。
5. 適用方法とコストの移動
NeMo RLは各層で値を変換するフィードフォワード投影重みにReshardを使い、それ以外は従来の集約・転送経路に残す。同社の発表によると、最新の大規模言語モデルでは、この重みがパラメータの約95%を占める。データ量の多い部分に最適化を集中させ、ほかの重みの多様な形状は従来の経路で処理する選択だ。
設定は以下のとおりだ。
policy:
  generation:
    colocated:
      enabled: false
    refit_transport: nccl_reshard
この機能はNeMo RLの文書で実験的機能とされている。学習と生成を別々のGPUで実行し、Megatronで学習する必要がある。生成バックエンドはvLLMまたはMegatronに限られ、生成側のパイプライン並列には対応しない。
重複するネットワーク転送を減らす代わりに、複製を完成させる作業の一部は送信先GPU間のNVLink通信へ移る。Reshardの大容量経路で扱う量子化重み、つまり表現精度を下げた重みは、BF16に戻して転送し、送信先で必要に応じて再量子化するため、転送量の削減とともに形式変換のコストも検討する必要がある。
Reshardの価値は、大規模モデルの更新待ちを短縮するため、全パラメータの繰り返し転送を必要な断片の受け渡しに置き換える点にある。