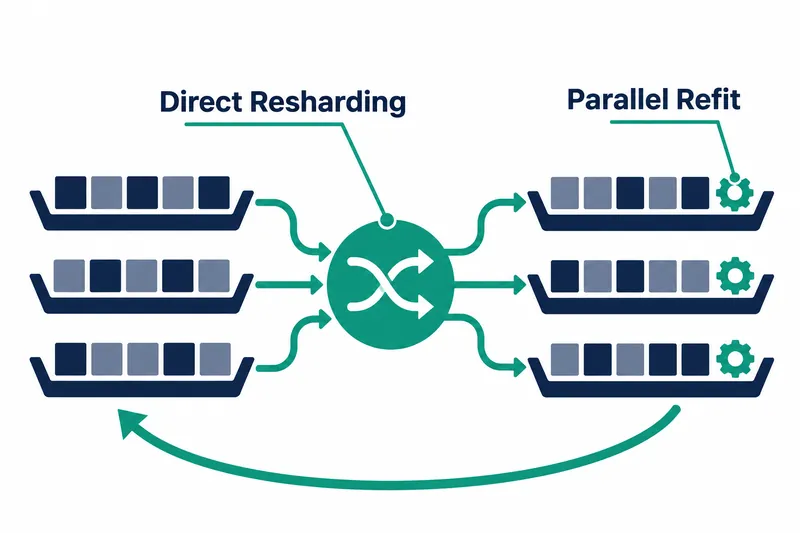
NVIDIA公布了通信方式Reshard,用于将强化学习模型更新后的权重从训练GPU传至推理GPU。在不同GPU上分别运行训练和推理的开发团队,可直接传递所需分片,而不必先汇集全部权重再发送,从而缩短更新等待时间。
1. 汇集全部权重后再发送的方式
强化学习后训练是在预训练后继续训练的过程,使用当前策略进行推理以生成训练数据,并定期将更新后的权重同步到推理GPU。这种更新称为权重重新加载(refit)。训练与推理的计算特征不同,权重分片方式也不同,因此如何在两组GPU之间高效传输大量数据成为一项挑战。
传统的典型方式是让训练GPU汇集各自持有的分片,构建完整参数,再将其传给推理GPU。推理GPU虽然只保留所需部分,但接收过程仍需经过完整参数。
NVIDIA假设BF16权重每个参数占2字节,估算Kimi K3的2.8万亿参数约为5.6TB,Qwen 3.8 2.4T A95B的2.4万亿参数约为4.8TB。汇集与传输合计的逻辑数据量,即各阶段数据大小之和,分别约为11.2TB和9.6TB。
2. 直接连接所需分片
Reshard使用PyTorch的分布式张量表示DTensor描述源端和目标端的权重布局,仅传输所需区域。例如,将按行划分的矩阵重新按列划分时,每个GPU只接收并组装自己负责的列所对应的部分。
NCCL M2N Reshard是基于NCCL实现这一机制的开源库。开发团队描述两端布局并调用传输,具体通信路径则交由库处理。
3. 网络传输与GPU内部交换
共享GPU间高速互联NVLink的目标GPU,在复制同一份数据时,会先通过网络接收不同部分,再相互共享。两种传输重叠进行,减少了通过网络向每个副本重复发送相同数据的负担。
4. NeMo RL中验证的延迟下降
根据NVIDIA公布的NeMo RL测试,Reshard重新加载权重的速度比传统汇集再传输方式快2.7~5.7倍。以下案例采用不同硬件、模型和并行布局,各案例均比较两种方式的延迟。
据该公司公布,DGX H100(NVL8)上的Qwen 3 235B从6.4秒降至1.9秒。训练采用张量4·流水线8·专家16并行,推理采用张量8·数据16并行。这些方式分别将权重分片、模型连续阶段、专家组和同一模型的副本分布到GPU上。
DeepSeek v3 671B的训练采用流水线16·专家16并行,推理采用张量32·数据8并行。据该公司公布,在此配置下,DGX H100(NVL8)从14.9秒降至2.6秒,DGX GB200(NVL72)从6.1秒降至2.3秒。
据该公司公布,DGX GB200(NVL72)上的Nemotron Ultra v3从8.2秒降至2.3秒。训练采用张量8·专家32·流水线2并行,推理采用张量8·数据8并行。
在单独针对重新加载的微基准测试,即仅测量特定任务的性能测试中,该公司公布BF16 Qwen3.8 2.4T模型的重新加载耗时为4.3秒。这一数据作为万亿参数级模型的重新加载结果给出。
5. 应用方式与成本转移
NeMo RL对各层用于数值变换的前馈投影权重使用Reshard,其余权重仍走传统汇集再传输路径。据该公司公布,在最新大型语言模型中,这类权重约占参数的95%。这种选择将优化集中在数据量大的部分,同时用传统路径处理其他权重的多种形态。
配置如下。
policy:
  generation:
    colocated:
      enabled: false
    refit_transport: nccl_reshard
NeMo RL文档将此功能标为实验性功能。训练与生成必须在不同GPU上运行,并使用Megatron训练;生成后端仅限vLLM或Megatron,且不支持生成端的流水线并行。
减少重复网络传输的同时,补全副本的部分工作转移到了目标GPU之间的NVLink通信。Reshard大容量路径处理的量化权重,即降低表示精度的权重,会先还原为BF16传输,并在目标端按需重新量化,因此除传输节省外,也需关注格式转换成本。
Reshard的价值在于,将完整参数的重复传输改为按需传递分片,从而缩短大型模型更新的等待时间。